
LM Studio utilité, éditeur et limites sur poste de travail
LM Studio utilité, éditeur et limites sur poste de travail
Section intitulée « LM Studio utilité, éditeur et limites sur poste de travail »LM Studio est une application de bureau qui télécharge des modèles de langage, les exécute sur la machine et les expose par une interface de discussion ou par un serveur local. L’outil est confortable, gratuit, et édité par une société privée qui n’en publie pas le code principal. Toute la question tient là : ce que ce confort apporte, ce qu’il coûte en auditabilité, et où s’arrête l’usage raisonnable.
→ Lire l’explication complète de la marmotte
Utilité de LM Studio : ce que l’outil fait vraiment
Section intitulée « Utilité de LM Studio : ce que l’outil fait vraiment »LM Studio fait quatre choses, et les fait bien.
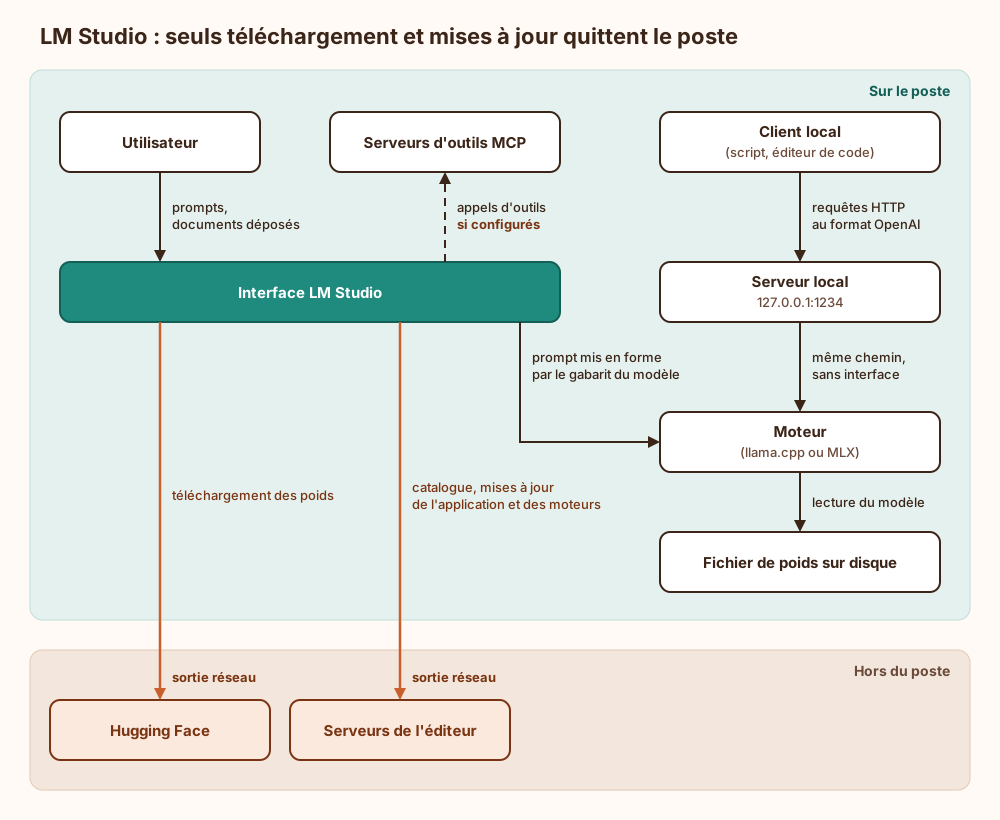
Il sert de catalogue : recherche et téléchargement de modèles depuis Hugging Face, avec une indication de compatibilité selon la mémoire disponible. Il sert de moteur : exécution d’un LLM (Large Language Model, grand modèle de langage) via llama.cpp pour les fichiers GGUF (GPT-Generated Unified Format, le format de fichier de llama.cpp), ou via MLX, le cadre de calcul d’Apple, sur les puces Apple Silicon. Il sert d’interface de discussion, avec dépôt de documents et connexion à des outils externes. Il sert enfin de serveur : une API (Application Programming Interface) HTTP compatible avec celle d’OpenAI, sur le port 1234 par défaut.
Ce dernier point est celui qui compte pour un architecte. Un outil écrit pour un fournisseur d’API en ligne se rebranche sur http://127.0.0.1:1234/v1 en changeant une URL de base. L’évaluation d’un modèle ouvert sur des données qui ne doivent pas sortir devient l’affaire d’une demi-heure, là où la compilation de llama.cpp avec les bons drapeaux d’accélération occupait un après-midi et une partie de la dignité.
Le schéma suivant montre ce qui reste sur la machine et ce qui en sort : seuls le téléchargement et les mises à jour franchissent la frontière du poste.
Ce que LM Studio n’est pas : un serveur d’inférence mutualisé. Pas de gestion d’utilisateurs, pas de quotas, pas de journal d’audit exploitable, pas de haute disponibilité. Les versions récentes savent traiter des requêtes en parallèle et tourner sans interface graphique, ce qui ne transforme pas un outil de poste en service d’équipe, pas plus qu’un klaxon ne transforme une trottinette en autobus.
Éditeur de LM Studio : Element Labs et le périmètre fermé
Section intitulée « Éditeur de LM Studio : Element Labs et le périmètre fermé »L’éditeur est Element Labs, Inc., société américaine. L’application de bureau est propriétaire : le code source n’est pas publié. Certaines briques périphériques le sont, sous licence MIT : la CLI (Command Line Interface) lms, les SDK (Software Development Kit) JavaScript et Python, et le moteur MLX. Le moteur GGUF repose sur llama.cpp, lui aussi ouvert. Le cœur qui orchestre l’ensemble, lui, reste une boîte noire livrée sous forme de binaire Electron.
Côté conditions d’usage : l’application est gratuite pour un usage personnel et, depuis 2025, pour un usage professionnel sans demande de licence préalable. Des offres payantes couvrent les fonctions d’équipe (authentification centralisée, contrôle des modèles autorisés). Les conditions générales en vigueur font foi, et elles changent plus vite que les fiches d’inventaire logiciel.
Trois conséquences pratiques du statut propriétaire.
- La promesse de confidentialité est une déclaration, pas une propriété vérifiable par lecture du code. L’éditeur affirme que prompts et documents ne quittent pas la machine. La vérification se fait donc par l’extérieur : filtrage et journalisation des flux sortants du poste.
- Les mises à jour arrivent par deux canaux : l’application elle-même et les moteurs d’exécution, mis à jour séparément. Un parc où chaque poste se met à jour seul n’a plus de version de référence, et un résultat d’évaluation obtenu sur un poste ne se reproduit pas forcément sur le voisin.
- La dépendance à l’éditeur porte sur le binaire, pas sur les données. Les poids sont des fichiers GGUF standards, relisibles par llama.cpp sans LM Studio. La sortie est donc peu coûteuse, ce qui est assez rare pour être noté.
Les licences des modèles sont un sujet distinct : chaque fichier de poids porte la sienne (Apache 2.0, licences communautaires restrictives, clauses d’usage acceptable). LM Studio ne les fait pas respecter et ne les rend pas plus permissives.
Prérequis de plateforme et dimensionnement
Section intitulée « Prérequis de plateforme et dimensionnement »- macOS : Apple Silicon uniquement, les Mac à processeur Intel ne sont pas pris en charge.
- Windows : x64 avec le jeu d’instructions AVX2 (Advanced Vector Extensions 2), ou ARM64 sur les plateformes récentes.
- Linux : x64, distribution au format AppImage, donc sans gestionnaire de paquets ni mise à jour pilotée par le système.
- Mémoire : 16 Go de RAM (Random Access Memory) constituent le plancher réaliste. Sur PC, c’est la mémoire de la carte graphique qui borne la taille du modèle ; sur Apple Silicon, la mémoire unifiée joue les deux rôles.
- Disque : un modèle quantifié (poids compressés en moins de bits par paramètre) pèse de 2 à plus de 40 Go. Dix modèles essayés par curiosité remplissent un disque avec une régularité de métronome.
Le choix du niveau de quantification et le calcul de la mémoire nécessaire sont traités dans le comparatif des formats de quantification et dans la page sur le dimensionnement du matériel d’inférence.
Surface d’attaque du serveur local et des modèles
Section intitulée « Surface d’attaque du serveur local et des modèles »Le port 1234
Section intitulée « Le port 1234 »Par défaut, le serveur écoute sur la boucle locale et n’exige aucune authentification. Tout processus de la session peut donc l’interroger. C’est acceptable sur un poste mono-utilisateur, à trois réserves près.
L’option « Serve on Local Network » bascule l’écoute sur toutes les interfaces. Le poste offre alors son processeur graphique, la liste de ses modèles et, selon la version, les opérations de chargement et de déchargement à quiconque partage le réseau, Wi-Fi d’hôtel compris. Les versions récentes proposent des jetons d’accès : ils sont à activer explicitement, leur présence se vérifie sur la version installée, et le flux reste en HTTP sans chiffrement.
L’option CORS (Cross-Origin Resource Sharing) autorise les pages web à lire les réponses du serveur local. Activée pour faire fonctionner une interface web de test, elle permet à n’importe quel site ouvert dans le navigateur de converser avec le modèle chargé.
Enfin, un service HTTP en boucle locale, sans authentification, reste une cible de réassociation DNS (DNS rebinding : un domaine contrôlé par l’attaquant se résout soudain vers 127.0.0.1, et le navigateur croit parler au même site). Tant que la validation de l’en-tête Host n’a pas été constatée sur la version déployée, le serveur est à considérer comme joignable depuis le navigateur.
Les fichiers de modèles
Section intitulée « Les fichiers de modèles »Un fichier GGUF n’est pas une donnée inerte. Il est analysé par du code C++, et des corruptions mémoire dans cette analyse ont été corrigées dans llama.cpp en 2024. Il embarque aussi un gabarit de conversation, interprété par un moteur de gabarits, qui met en forme chaque prompt : un gabarit modifié injecte des instructions à chaque échange sans toucher aux poids et sans rien afficher dans l’interface.
Les dépôts communautaires republient des quantifications de modèles officiels. Rien ne lie cryptographiquement la copie à l’original. Contre-mesure : n’autoriser que des éditeurs de dépôts identifiés, relever l’empreinte SHA-256 du fichier à la validation, et la recontrôler avant usage. Le raisonnement complet figure dans l’éditorial sur le poids du modèle comme artefact.
Les outils MCP
Section intitulée « Les outils MCP »LM Studio sait jouer le rôle d’hôte MCP (Model Context Protocol, protocole qui relie un modèle à des outils externes, détaillé dans le glossaire). La configuration vit dans un fichier mcp.json du répertoire de l’application. Deux effets : les jetons d’accès aux services y sont stockés en clair, et chaque serveur d’outils déclaré est un programme lancé avec les droits de l’utilisateur, souvent récupéré à la volée depuis un registre de paquets.
Un modèle local de petite taille résiste mal aux instructions cachées dans un résultat d’outil. La boîte de confirmation avant appel est une barrière humaine, donc une barrière qui clique sur « Autoriser » au bout du troisième affichage. Les règles de cloisonnement sont celles de la page sur la sécurité des agents outillés.
Les traces sur disque
Section intitulée « Les traces sur disque »Les conversations sont enregistrées en clair dans le répertoire de l’application (~/.lmstudio/ sur les versions actuelles), à côté des modèles et de la configuration. Le prompt qui ne part pas dans le cloud reste donc lisible par tout ce qui lit le profil utilisateur : logiciel de sauvegarde, synchronisation de dossiers, outil d’indexation, maliciel.
Ce que LM Studio ne garantit pas
Section intitulée « Ce que LM Studio ne garantit pas »- La confidentialité au repos. Elle vient du chiffrement du disque et de la gestion du poste, pas de l’application. « Local » décrit un emplacement, pas une protection : l’argument est développé dans l’éditorial modèle local et confidentialité.
- L’intégrité et la provenance des poids. Aucune signature n’est vérifiée entre le modèle d’origine et le fichier téléchargé.
- L’isolation entre appelants. Tous les clients du serveur partagent les mêmes modèles chargés, sans identité ni cloisonnement.
- La traçabilité. Pas de journal horodaté et protégé de qui a demandé quoi ; les journaux disponibles servent au débogage.
- La qualité des réponses. Un modèle quantifié à 4 bits sur un portable n’a pas le niveau d’un grand modèle hébergé. Décider d’un usage métier à partir d’un essai local exige une évaluation sur le même fichier que celui qui sera déployé.
Position : poste d’évaluation oui, service partagé non
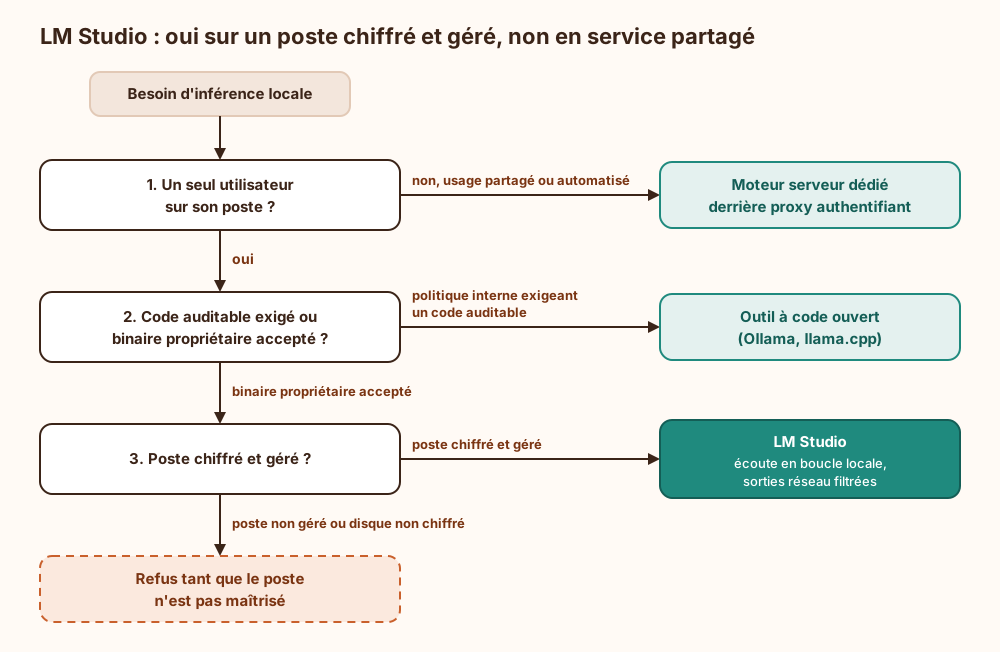
Section intitulée « Position : poste d’évaluation oui, service partagé non »Le compromis central : LM Studio échange de l’auditabilité contre du temps. On gagne une mise en route en quelques minutes, un catalogue, une gestion des moteurs sans compilation. On paie par un binaire fermé qui manipule les prompts les plus sensibles de la maison, par des mises à jour difficiles à figer, et par un serveur pensé pour un seul utilisateur.
La recommandation est donc tranchée. LM Studio convient au poste de travail individuel, pour évaluer des modèles, prototyper contre une API compatible OpenAI et traiter ponctuellement des données qui ne doivent pas partir chez un tiers. Il ne convient pas comme service d’inférence partagé, ni sur un serveur, ni dans une chaîne d’intégration. Pour ces cas, llama.cpp en mode serveur ou un moteur d’inférence dédié, derrière un proxy qui authentifie et journalise, font le travail avec un code lisible. Entre LM Studio et Ollama sur un poste, la question qui départage est unique : le code de l’outil doit-il pouvoir être audité ? Si oui, voir déployer Ollama sur un poste de travail. Microsoft range Foundry Local dans le même rayon, et la comparaison entre Foundry Local et LM Studio évite de choisir son épicier à la seule couleur de l’emballage.
Le schéma ci-dessous résume l’arbre de décision.
Exemple : démarrer le serveur LM Studio et vérifier son exposition
Section intitulée « Exemple : démarrer le serveur LM Studio et vérifier son exposition »La séquence suivante télécharge un modèle, le charge avec un identifiant stable, vérifie l’interface d’écoute et relève l’empreinte du fichier. Elle suppose l’application installée et lancée une première fois, ce qui installe la commande lms.
# Télécharger un modèle du catalogue (sortie réseau vers Hugging Face)lms get google/gemma-3-4b
# Lister les modèles présents sur disquelms ls
# Charger le modèle : accélération graphique maximale, contexte borné,# identifiant stable pour les clients, déchargement après 30 min d'inactivitélms load google/gemma-3-4b --gpu max --context-length 8192 \  --identifier eval-local --ttl 1800
# Démarrer le serveur sur le port par défautlms server start --port 1234
# Contrôle d'exposition : l'adresse d'écoute doit être 127.0.0.1, pas 0.0.0.0ss -ltnp | grep ':1234'
# Appel de test au format OpenAIcurl -s http://127.0.0.1:1234/v1/chat/completions \  -H 'Content-Type: application/json' \  -d '{        "model": "eval-local",        "messages": [{"role": "user", "content": "Résumer TLS 1.3 en une phrase."}],        "temperature": 0.2      }'
# Empreinte des poids, à consigner dans l'inventairefind ~/.lmstudio/models -name '*.gguf' -exec sha256sum {} +
# Arrêt propre : décharger puis couper le serveurlms unload --alllms server stop
Deux lectures à faire. La ligne ss est le vrai contrôle : une écoute sur 0.0.0.0:1234 signifie que l’option d’exposition réseau est active, quelle que soit l’intention. L’empreinte SHA-256, elle, n’a de valeur que comparée à une référence relevée au moment de la validation du modèle.
Exploitation : mises à jour, inventaire, supervision et sauvegarde
Section intitulée « Exploitation : mises à jour, inventaire, supervision et sauvegarde »Secrets. Les seuls secrets de LM Studio sont ceux qu’on y dépose : jetons du fichier mcp.json, jetons d’accès au serveur s’ils sont activés. Ils se traitent comme tout secret de poste : portée minimale, durée de vie courte, renouvellement à chaque départ ou réaffectation de machine. Un jeton à privilèges larges dans un fichier de configuration d’outil de discussion est un mot de passe écrit sous le clavier, avec une meilleure typographie.
Versions. Figer une version d’application et une version de moteur par campagne d’évaluation, et les noter avec l’empreinte du modèle. Sans ce triplet, un écart de résultat entre deux postes ne s’explique pas.
Supervision. Trois signaux suffisent sur un parc : la présence du binaire dans l’inventaire logiciel, une écoute sur le port 1234 hors boucle locale, et les destinations des flux sortants du processus. lms log stream affiche les requêtes reçues, à des fins de diagnostic uniquement. Un outil de ce type installé sans validation relève du même traitement que le reste de la sécurité des postes de développeurs.
Sauvegarde et reprise. Les poids se retéléchargent : les exclure des sauvegardes, en conservant la liste des modèles et leurs empreintes. Les conversations, en revanche, contiennent ce que les utilisateurs ont jugé trop sensible pour un service en ligne : soit elles sont exclues de la sauvegarde et de toute synchronisation de dossiers, soit la sauvegarde est chiffrée au niveau requis par la classification de ces données. La reprise après perte du poste se réduit à réinstaller la version figée et à recharger les modèles de la liste.
Fin de vie. Supprimer une conversation dans l’interface ne garantit pas l’effacement des blocs sur disque. Le recyclage d’un poste ayant servi à ces usages passe par l’effacement du volume chiffré, pas par la corbeille.
LM Studio fonctionne-t-il sans connexion Internet ?
Section intitulée « LM Studio fonctionne-t-il sans connexion Internet ? »Oui, une fois l’application et les modèles présents sur la machine : discussion, analyse de documents et serveur local fonctionnent hors ligne. Le réseau ne sert qu’au catalogue, aux téléchargements et aux mises à jour. Un poste isolé reçoit ses modèles par copie de fichiers GGUF dans le répertoire prévu.
LM Studio est-il open source ?
Section intitulée « LM Studio est-il open source ? »Non. La ligne de commande, les SDK et le moteur MLX sont publiés sous licence MIT ; l’application de bureau est propriétaire. Dire « LM Studio est ouvert » parce que lms l’est revient à juger un immeuble à sa boîte aux lettres.
Peut-on exposer le serveur LM Studio à une équipe ?
Section intitulée « Peut-on exposer le serveur LM Studio à une équipe ? »Techniquement oui, par l’option d’écoute réseau. C’est déconseillé : pas de chiffrement du transport, pas d’identité par appelant, pas de journal d’audit. Un besoin d’équipe appelle un moteur serveur derrière un proxy qui authentifie, limite et trace.
🐝 Ce qui arrive si on s’en passe
Section intitulée « 🐝 Ce qui arrive si on s’en passe »Sans outil d’inférence locale validé sur les postes, le besoin ne disparaît pas : il se déplace. Les extraits de code, les contrats et les journaux d’incident partent vers des assistants en ligne dont la durée de conservation et la réutilisation des données échappent à tout contrôle interne. L’évaluation de modèles ouverts sur des données réelles devient impossible sans les faire sortir, donc les décisions se prennent sur des démonstrations. Et l’installation finit par se faire quand même, hors inventaire : serveur ouvert sur le réseau, modèles de provenance inconnue, version jamais figée, sans qu’aucun signal de supervision ne le révèle.
🦫 Explication de la marmotte 🍫
Section intitulée « 🦫 Explication de la marmotte 🍫 »LM Studio est un programme installé sur un ordinateur. On y choisit un modèle d’intelligence artificielle dans une liste, et le programme télécharge un gros fichier qui contient ce modèle. Ensuite, tout se passe sur la machine : la question tapée est transmise au modèle, qui calcule la réponse avec le processeur et la carte graphique de l’ordinateur. Rien n’est envoyé ailleurs pendant ce calcul. Internet ne sert qu’à récupérer les modèles et les mises à jour du programme.
LM Studio peut aussi ouvrir une porte d’entrée pour les autres programmes de l’ordinateur, afin qu’ils posent eux aussi des questions au modèle. Par défaut, cette porte n’est accessible que depuis la machine elle-même et ne demande aucun mot de passe. Si on l’ouvre au réseau, tous les appareils voisins peuvent s’en servir.
Le programme appartient à une entreprise privée qui ne montre pas comment il est écrit. Il faut donc vérifier de l’extérieur ce qu’il envoie sur Internet. Les fichiers de modèles viennent de sources variées : il faut contrôler leur origine, car un fichier modifié peut changer les réponses en cachette. Enfin, les discussions sont enregistrées sur le disque sans protection : si l’ordinateur est volé ou infecté, elles sont lisibles, sauf si le disque entier est chiffré.
À lire aussi
- L'IA actuelle : assistants conversationnels et agentsÉtat des lieux en octobre 2026 des assistants d'IA générative (ChatGPT, Claude, Gemini, Copilot, Vibe, Meta AI, DeepSeek, Grok, modèles ouverts) et des agents qui agissent à leur place, avec ce que cela change pour la sécurité et la manière de les encadrer.
- Agentique : définition, lectures d'OpenAI et d'Anthropic, Claude CodeCe que recouvre le mot agentique pour un système fondé sur un modèle de langage, comment OpenAI et Anthropic le définissent, et ce que Claude Code en fait concrètement sur un dépôt de code.
- Fenêtre de contexte et mémoire d’un LLM localChoisir, dimensionner et exploiter la fenêtre de contexte d’un LLM local sans sacrifier inutilement la performance, la sécurité ou la continuité des conversations.
- Comment fonctionne l'inférence d'un modèle de langagePréremplissage, décodage, cache de clés et valeurs, batching et surface d'attaque d'un serveur d'inférence, avec les compromis de latence et de débit à trancher avant la mise en production.
Pages voisines
La citent
LM Studio utilité, éditeur et limites sur poste de travail
Elle cite
- Lien dans les deux sens :Backend Foundry Local expliqué et comparé à LM Studio
- Lien dans les deux sens :Faire tourner un modèle chez soi
- Comparer GGUF GPTQ et AWQ pour LLM local
- Déployer Ollama sur un poste de travail et dimensionner la mémoire
- Dimensionner GPU et RAM pour un LLM local
- Evals LLM comment mesurer qu'un assistant IA répond juste
- Sécuriser les actions irréversibles des agents LLM
- Les poids d'un modèle sont un artefact logiciel
- Pourquoi l’IA responsable reste invérifiable
- Pourquoi supprimer un fichier ne l'efface pas
- Sécuriser les postes développeurs avec secrets de production
: les deux pages se citent l’une l’autre.