
Quantification
IA
Technique qui réduit la précision numérique des poids (et parfois des activations) d'un modèle, par exemple de flottants 16 bits vers des entiers 8 ou 4 bits. On gagne en mémoire et en vitesse d'inférence ; on paie en exactitude, plus ou moins selon la méthode.
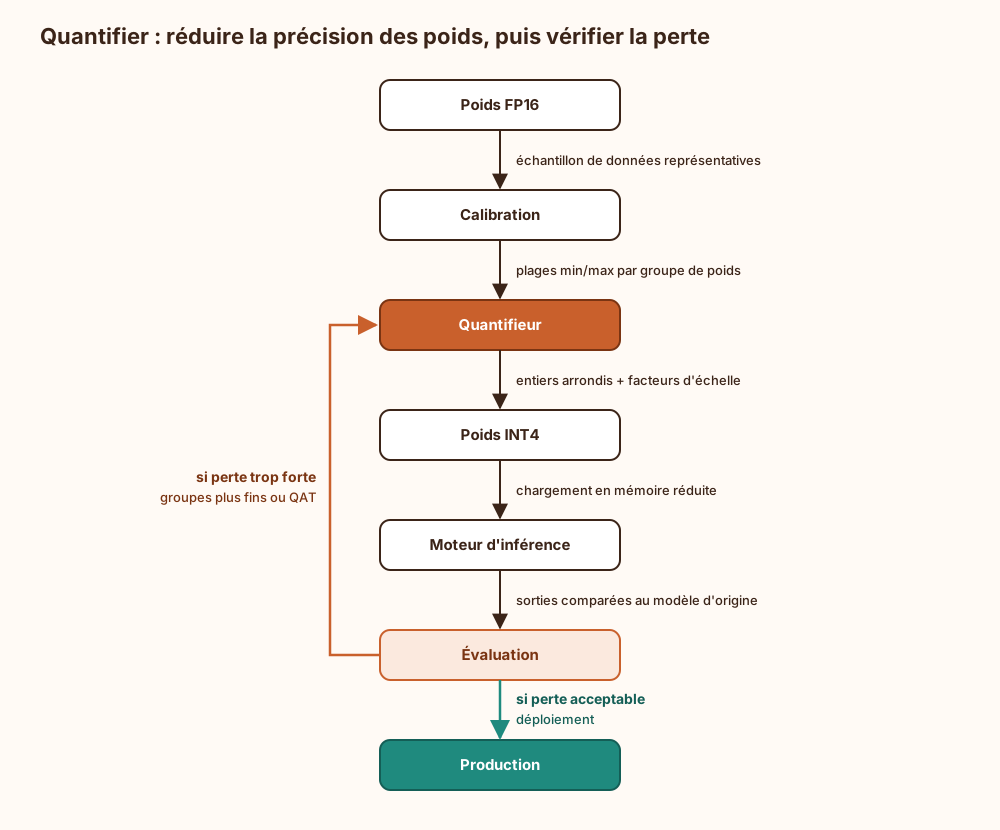
Principe : Chaque valeur est projetée sur une grille réduite grâce à un facteur d'échelle, parfois complété d'un point zéro. On stocke l'entier et on reconstruit une approximation au moment du calcul.
Après ou pendant l'entraînement : La PTQ (Post-Training Quantization) quantifie un modèle déjà entraîné à partir d'un petit jeu de calibration : c'est rapide et peu coûteux. La QAT (Quantization-Aware Training) simule l'arrondi pendant l'entraînement : le modèle apprend à vivre avec, ce qui donne une meilleure qualité pour un calcul nettement plus cher.
Granularité : L'échelle peut être calculée par tenseur, par canal ou par groupe de 64 à 128 poids. Plus le grain est fin, moins les valeurs aberrantes écrasent la plage des autres, mais plus il faut stocker de métadonnées.
Le prix à payer : En 4 bits et en dessous, la perte devient mesurable, surtout sur le raisonnement et les tâches longues ; des méthodes comme GPTQ ou AWQ limitent la casse. Passer en 4 bits divise la mémoire par quatre : la fiche produit retient la division, rarement la colonne des scores qui a bougé.
Explication de la marmotte
Imagine une photo très détaillée avec des millions de couleurs. Si tu l'enregistres avec seulement quelques centaines de couleurs, le fichier devient beaucoup plus léger et s'ouvre plus vite. De loin, on voit à peine la différence ; de près, quelques nuances ont disparu. Les programmes d'intelligence artificielle contiennent des milliards de nombres très précis. La quantification consiste à arrondir ces nombres, un peu comme dire « environ 3 » au lieu de « 3,14159 ». Le programme prend alors beaucoup moins de place et peut tourner sur un ordinateur ordinaire, voire sur un téléphone. Toute l'astuce est d'arrondir assez pour gagner de la place, mais pas trop, sinon le programme se trompe plus souvent.
Où ce terme est utilisé
- Comparer GGUF GPTQ et AWQ pour LLM local (7 occurrences)
- Dimensionner GPU et RAM pour un LLM local (7 occurrences)
- Backend Foundry Local expliqué et comparé à LM Studio (5 occurrences)
- Pourquoi la dette technique de sécurité reste non chiffrée (4 occurrences)
- Calculer le coût d’un LLM local à grande échelle (3 occurrences)
- Fine-tuning en IA, définition, usages et limites (3 occurrences)
- Comment fonctionne l'inférence d'un modèle de langage (2 occurrences)
- Faire tourner un modèle chez soi (2 occurrences)
- LM Studio utilité, éditeur et limites sur poste de travail (2 occurrences)
- Pseudonymisation par LLM, fuite de contexte et réidentification (2 occurrences)