
Différence entre IA et LLM : un champ entier, un type de modèle
Différence entre IA et LLM : un champ entier, un type de modèle
Section intitulée « Différence entre IA et LLM : un champ entier, un type de modèle »Dire « l’IA » pour parler de ChatGPT revient à dire « le sport » pour parler du tennis : ce n’est pas faux, c’est seulement assez imprécis pour fausser toutes les décisions qui suivent. Le LLM (Large Language Model, grand modèle de langage) est une branche récente et étroite d’un champ, l’intelligence artificielle (IA), qui compte des systèmes experts, des classifieurs, des détecteurs d’anomalies, de la vision, de la parole et de la planification. Cette page trace la frontière et montre ce qu’elle change pour la surface d’attaque, le choix d’outil et le vocabulaire de l’AI Act.
→ Lire l’explication complète de la marmotte
Ce que l’usage courant confond entre IA et LLM
Section intitulée « Ce que l’usage courant confond entre IA et LLM »On rencontre trois confusions, et elles n’ont pas le même coût.
« L’IA » employé pour « un LLM ». C’est la plus fréquente. Une politique interne qui interdit « l’usage de l’IA » sans préciser bloque en théorie le filtre antispam, le correcteur orthographique et le moteur de détection de l’EDR (Endpoint Detection and Response), qui embarquent souvent de l’apprentissage automatique depuis longtemps. En pratique, personne ne l’applique à ces outils, donc la règle est violée en permanence, et une règle violée en permanence ne protège plus rien. Une politique sérieuse vise un usage précis : envoi de données à un modèle génératif hébergé, intégration d’un agent outillé, etc. (voir la politique d’usage de l’IA générative).
Un produit vendu « propulsé par l’IA » qui ne contient aucun LLM. Souvent légitime : un score de risque issu d’un gradient boosting est de l’IA au sens du champ. Parfois franchement abusif : un jeu de seuils codés en dur rebaptisé « moteur cognitif ». D’une plaquette commerciale à la suivante, la même règle if score > 80 a été successivement « heuristique », « big data », « machine learning » et maintenant « IA générative », sans qu’une seule ligne de code ait bougé.
Un LLM là où il n’a rien à faire. C’est l’inverse, et c’est le plus cher. Confier le tri d’alertes en trois catégories à un modèle génératif, c’est payer à l’appel, accepter des sorties hors des trois catégories et perdre toute métrique de performance stable, pour un problème qu’un classifieur entraîné sur l’historique résout mieux.
Carte des familles de l’IA : du système expert au LLM
Section intitulée « Carte des familles de l’IA : du système expert au LLM »Le champ se lit en couches imbriquées. Le schéma montre où se situe le LLM : au fond d’un emboîtement, pas au sommet.
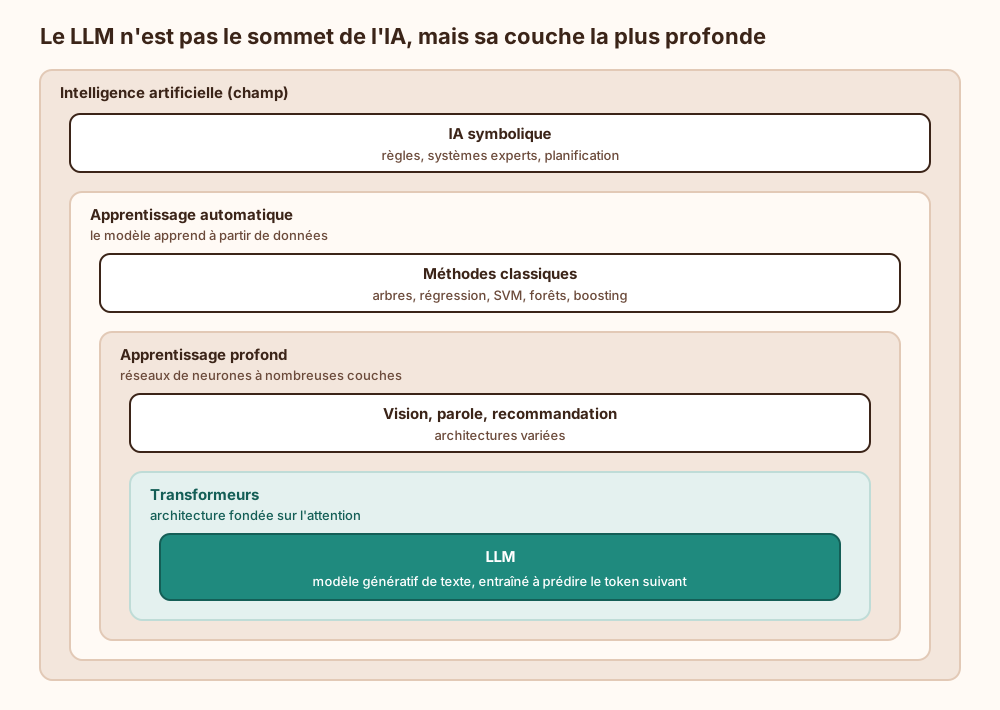
On y lit une conséquence directe : tout LLM est de l’apprentissage profond, mais l’essentiel de l’IA en production n’est pas un LLM. Le transformeur sert d’ailleurs aussi à la vision et à la parole, donc « transformeur » n’est pas un synonyme de « LLM » non plus.
Le tableau suivant décrit chaque famille par ce qui compte pour un architecte : ce qui entre, ce qui sort, et comment ça casse.
| Famille | Exemple d’usage | Données d’entrée | Nature de la sortie | Mode d’échec typique |
|---|---|---|---|---|
| Systèmes experts et moteurs de règles | Politique d’accès, détection par signatures, conformité de configuration | Faits structurés | Décision déterministe, traçable jusqu’à la règle | Cas non prévu par les règles ; base de règles qui pourrit faute de maintenance |
| Apprentissage supervisé classique (arbre de décision, régression, SVM (Support Vector Machine), boosting) | Scoring de fraude, classification de courriels | Variables tabulaires étiquetées | Étiquette parmi un ensemble fini, ou nombre, avec probabilité | Dérive des données ; fuite de la cible dans les variables ; évasion adversariale |
| Détection d’anomalies (non supervisée) | Comportement réseau ou d’authentification inhabituel | Séries ou événements sans étiquette | Score d’écart à une normale apprise | Faux positifs en rafale après un changement légitime ; normale apprise sur un historique déjà compromis |
| Vision par ordinateur | Contrôle qualité, lecture de plaques, biométrie faciale | Images, vidéo | Classe, boîte englobante, segmentation | Perturbations adversariales, conditions hors distribution (éclairage, angle), biais démographiques |
| Reconnaissance vocale | Transcription, commande vocale | Signal audio | Texte transcrit | Bruit, accents sous-représentés, commandes inaudibles pour l’humain |
| Systèmes de recommandation | Catalogue, fil d’actualité | Historique d’interactions | Liste ordonnée d’éléments | Boucle de rétroaction, manipulation par faux profils |
| IA de jeu | Échecs, go, jeux vidéo | État du jeu | Coup à jouer | Exploitation d’une faiblesse que l’entraînement n’a jamais rencontrée |
| Robotique et planification | Ordonnancement, déplacement, logistique | Modèle de l’environnement, objectifs | Séquence d’actions | Écart entre le modèle du monde et le monde |
| LLM | Rédaction, synthèse, assistant de code, agent outillé | Texte (et parfois images) découpé en tokens | Texte libre, non borné | Hallucination, injection de prompt, sortie hors format |
Une seule ligne du tableau produit une sortie non bornée. Ce n’est pas un détail : c’est la propriété qui décide de presque tout le reste.
Ce qu’un LLM sait faire par construction, et ce qu’il ne garantit pas
Section intitulée « Ce qu’un LLM sait faire par construction, et ce qu’il ne garantit pas »Un LLM est entraîné à une seule tâche : prédire une distribution de probabilité sur le token suivant (un fragment de mot) étant donné les tokens précédents. La génération consiste à tirer un token dans cette distribution, l’ajouter au texte, recommencer. Le fonctionnement de cette boucle est détaillé dans la page sur l’inférence ; ici, seules comptent ses conséquences.
Pas de base de faits. Le modèle ne consulte aucune table de vérité. Il produit le texte le plus plausible, et le plausible coïncide souvent avec le vrai, sans aucune garantie. L’hallucination n’est pas une panne : c’est le mécanisme nominal qui produit une suite plausible et fausse. Le cas des noms de paquets inventés, et de leur exploitation, est traité dans la page sur le slopsquatting.
Non-déterminisme. Avec un échantillonnage à température non nulle, deux appels identiques donnent deux réponses différentes. À température nulle, l’identité des sorties reste non garantie chez la plupart des fournisseurs, parce que le regroupement des requêtes et l’arithmétique flottante sur accélérateur introduisent des variations. Il ne faut donc pas bâtir un test de non-régression sur l’égalité exacte des sorties.
Fenêtre de contexte. Le modèle ne « se souvient » que de ce qui tient dans son contexte à l’instant de l’appel : instructions, historique, documents injectés. Tout ce qui y entre, y compris un texte hostile caché dans un document, est traité comme du texte au même titre que les instructions légitimes. Les limites pratiques des contextes longs sont dans la page dédiée.
Sortie non bornée. Demander « réponds par oui ou par non » n’interdit pas au modèle de répondre « Probablement ». Les modes de sortie structurée des fournisseurs contraignent la forme, pas la justesse.
Face à ça, un classifieur, un détecteur d’anomalies ou un moteur de règles offrent trois propriétés qu’un LLM n’offre pas nativement :
- Sortie bornée : une étiquette parmi N, un score entre 0 et 1, une règle déclenchée ou non.
- Mesurabilité : précision, rappel, taux de faux positifs sur un jeu de test figé, comparables d’une version à l’autre.
- Explicabilité : la règle déclenchée, l’importance des variables, le chemin dans l’arbre. Un LLM qui « explique » sa réponse produit un texte plausible sur sa réponse, pas une trace de son calcul.
Le compromis central se formule ainsi : le LLM fait gagner la généralité et une interface en langage naturel ; il fait payer le bornage, la mesurabilité, le déterminisme et une surface d’attaque nouvelle. La recommandation qui en découle est tranchée : si la sortie attendue est énumérable (une catégorie, un booléen, un nombre) et qu’un historique étiqueté existe, on prend un classifieur ou des règles. On réserve le LLM aux sorties qui sont réellement du texte ouvert (synthèse, rédaction, extraction depuis du non-structuré), et on le place derrière une validation déterministe. La question qui tranche les cas ambigus : la sortie peut-elle être vérifiée automatiquement ? Si oui, un LLM peut produire, un contrôle peut valider. Si non, il faut un humain dans la boucle ou un autre outil.
Surface d’attaque : LLM contre apprentissage automatique classique
Section intitulée « Surface d’attaque : LLM contre apprentissage automatique classique »Les deux mondes ne se défendent pas de la même façon, et un audit qui applique la grille de l’un à l’autre passe à côté de l’essentiel. Les référentiels publics le reflètent : l’OWASP (Open Worldwide Application Security Project) publie un Top 10 propre aux applications LLM, tandis que MITRE ATLAS (Adversarial Threat Landscape for Artificial-Intelligence Systems) catalogue les techniques d’attaque contre les systèmes d’apprentissage automatique en général.
Côté LLM, l’attaque passe par le contexte.
- Injection de prompt directe : l’utilisateur rédige des instructions qui contournent celles du système.
- Injection indirecte : l’instruction hostile est dans une page web, un courriel ou un document que le système charge dans le contexte. C’est la plus dangereuse, parce que l’attaquant n’a jamais besoin d’accéder à l’interface.
- Fuite par le contexte : tout ce qui est dans la fenêtre (instructions système, documents d’autres utilisateurs, secrets collés par erreur) peut ressortir dans une réponse. Voir les secrets dans les prompts et la fuite d’instructions des assistants personnalisés.
- Outils d’agents : dès que le modèle peut appeler une API (Application Programming Interface), envoyer un message ou exécuter du code, une injection devient une action. La contre-mesure n’est pas dans le modèle mais autour : moindre privilège des outils, validation des arguments, confirmation humaine des actions irréversibles (sécurité du function calling, agents autonomes outillés).
Aucune technique connue ne garantit qu’un LLM distingue de façon fiable instruction et donnée dans son contexte. Les filtres d’entrée réduisent le risque, ils ne le ferment pas. L’architecture doit donc supposer l’injection réussie et limiter ce qu’elle permet, ce que détaille la page sur les guardrails programmatiques.
Côté apprentissage automatique classique, l’attaque passe par les données et les requêtes.
- Évasion adversariale : modifier l’entrée juste assez pour changer la classe (un binaire malveillant retouché pour passer sous le seuil du détecteur). Contre-mesures : entraînement adversarial, combinaison avec des règles indépendantes du modèle.
- Empoisonnement : injecter des exemples piégés dans les données d’entraînement ou dans la boucle de réentraînement. Le détecteur d’anomalies réentraîné en continu y est particulièrement exposé, puisqu’un attaquant patient lui apprend que son comportement est normal. Détails dans la page sur l’empoisonnement.
- Inversion de modèle et inférence d’appartenance : interroger le modèle pour reconstituer des données d’entraînement ou savoir si un individu y figurait. Contre-mesures : limiter le débit des requêtes, ne pas exposer les scores bruts, recourir à la confidentialité différentielle quand les données sont sensibles.
- Extraction de modèle : reproduire le comportement d’un modèle propriétaire à force de requêtes. Mêmes contre-mesures de débit et d’exposition.
L’empoisonnement concerne aussi les LLM, et l’injection de prompt n’a pas d’équivalent dans un arbre de décision. Les deux catalogues se recoupent un peu, mais leurs priorités diffèrent.
Données envoyées, hallucinations et lecture du discours fournisseur
Section intitulée « Données envoyées, hallucinations et lecture du discours fournisseur »Données et rétention. Un classifieur tourne typiquement dans le périmètre, sur des variables extraites. Un LLM est souvent consommé par API chez un tiers, et on lui envoie du texte brut, donc des données personnelles, du code, des contrats. La question de la rétention et de la réutilisation des données côté fournisseur se pose alors immédiatement ; elle est traitée dans données envoyées aux API d’IA et rétention et le contrat DPA avec le fournisseur.
Hallucinations en contexte sécurité. Un LLM qui résume un incident peut inventer un indicateur de compromission, un numéro de CVE (Common Vulnerabilities and Exposures) ou une commande de remédiation. La règle : aucune sortie de LLM ne déclenche une action de sécurité sans vérification contre une source de vérité (base de vulnérabilités, journal d’origine, inventaire).
Lecture critique de « propulsé par l’IA ». Face à un produit, cinq questions suffisent à dégonfler la plupart des plaquettes :
- Quelle famille de modèle, pour quelle fonction précise ?
- Où s’exécute-t-il, et quelles données lui sont envoyées ?
- Quelle métrique de performance, mesurée sur quel jeu de test ?
- Que se passe-t-il quand le modèle se trompe : qui le voit, qui corrige ?
- Le modèle est-il réentraîné sur les données du client, et peut-on le refuser ?
Un fournisseur incapable de répondre à la première question vend un adjectif, pas un composant. La grille complète est dans évaluer un fournisseur d’IA générative.
Vocabulaire de l’AI Act : système d’IA, modèle GPAI et LLM
Section intitulée « Vocabulaire de l’AI Act : système d’IA, modèle GPAI et LLM »Le règlement (UE) 2024/1689 (AI Act) ne parle pas de LLM. Il emploie deux notions distinctes, et les confondre fausse la qualification.
« Système d’IA » (article 3, point 1). La définition est large : un système automatisé, conçu pour fonctionner à différents niveaux d’autonomie, qui peut faire preuve d’adaptation après déploiement et qui, pour des objectifs explicites ou implicites, déduit à partir des entrées qu’il reçoit la manière de générer des sorties (prédictions, contenus, recommandations ou décisions) pouvant influencer des environnements physiques ou virtuels. Un classifieur de scoring de crédit, un système de vision biométrique ou un détecteur d’anomalies entrent dans ce périmètre, sans LLM. Le considérant 12 précise que la définition ne couvre pas les systèmes fondés sur des règles définies uniquement par des personnes physiques pour exécuter automatiquement des opérations. D’où un paradoxe à garder en tête : un système expert est de l’IA au sens du champ académique, mais un moteur de règles purement écrit à la main peut sortir de la définition du règlement. L’article 96 prévoit des lignes directrices de la Commission sur l’application de cette définition, à consulter avant toute qualification.
« Modèle d’IA à usage général » ou GPAI (General-Purpose AI), article 3, point 63. Il s’agit d’un modèle caractérisé par une généralité significative et la capacité d’exécuter de manière compétente un large éventail de tâches distinctes, typiquement entraîné sur de grandes quantités de données. Un LLM de fondation est l’exemple type. Les obligations des fournisseurs de ces modèles sont au chapitre V (article 53 pour l’ensemble, article 55 pour ceux présentant un risque systémique). L’article 51 présume le risque systémique au-delà de 10^25 opérations en virgule flottante cumulées pour l’entraînement.
Deux conséquences pratiques :
- Un système d’IA à haut risque peut n’avoir aucun LLM. La classification passe par l’article 6 et les domaines de l’annexe III (biométrie, infrastructures critiques, emploi, accès aux services essentiels, etc.) : c’est l’usage qui qualifie, pas la technologie. Un modèle de régression qui trie des candidatures relève de l’annexe III ; un LLM qui reformule des courriels internes, a priori non.
- Intégrer un modèle GPAI dans un produit mis sur le marché ou en service sous son propre nom fait de l’intégrateur le fournisseur d’un système d’IA (article 3, point 3), avec ses propres obligations, distinctes de celles du fournisseur du modèle. Ce versant est développé dans l’AI Act côté déployeur.
Cette page décrit le vocabulaire du texte ; la qualification d’un système donné relève d’une analyse juridique au cas par cas, à mener sur le texte officiel publié au Journal officiel de l’Union européenne.
Prérequis et conditions d’exploitation selon la famille de modèle
Section intitulée « Prérequis et conditions d’exploitation selon la famille de modèle »Les deux familles ne demandent pas le même socle avant mise en œuvre.
- Classifieur ou détecteur d’anomalies : un historique de données représentatif (étiqueté pour le supervisé), un jeu de test figé et versionné, une chaîne d’entraînement reproductible (versions des bibliothèques, graine aléatoire, instantané des données). Sans jeu de test figé, aucune métrique n’est comparable d’une version à l’autre.
- LLM : un choix d’hébergement (API d’un fournisseur ou modèle local, voir Ollama sur poste de travail), un contrat couvrant la rétention, la gestion des clés d’API (clés d’API des fournisseurs), un jeu d’évaluation de prompts avec critères de réussite vérifiables, et une couche de validation des sorties.
En exploitation, les points de rupture diffèrent :
- Dérive. Le classifieur se dégrade quand les données changent : superviser la distribution des entrées et la précision sur un échantillon relabellisé. Le LLM change quand le fournisseur met à jour le modèle derrière un même nom : épingler une version datée quand l’API le permet, et rejouer le jeu d’évaluation à chaque changement.
- Secrets. Un modèle classique entraîné en interne est lui-même un actif à protéger (il encode les données d’entraînement). Côté LLM, le secret critique est la clé d’API, qui donne accès à la facturation et parfois à l’historique (denial of wallet).
- Supervision. Pour un LLM, journaliser prompts et réponses pose immédiatement une question de données personnelles ; le compromis est discuté dans l’observabilité des LLM en production.
- Reprise. Un classifieur se restaure depuis un artefact versionné. Un LLM consommé par API n’a pas de sauvegarde côté client : la reprise, c’est un fournisseur de repli testé, ou un mode dégradé sans modèle.
Exemple : choisir entre règles, classifieur et LLM pour un problème de sécurité
Section intitulée « Exemple : choisir entre règles, classifieur et LLM pour un problème de sécurité »Le schéma suivant est l’arbre de décision qui découle des sections précédentes. Il s’applique au tri d’alertes, à la catégorisation de tickets, à l’analyse de journaux ou à l’extraction d’information dans des rapports.
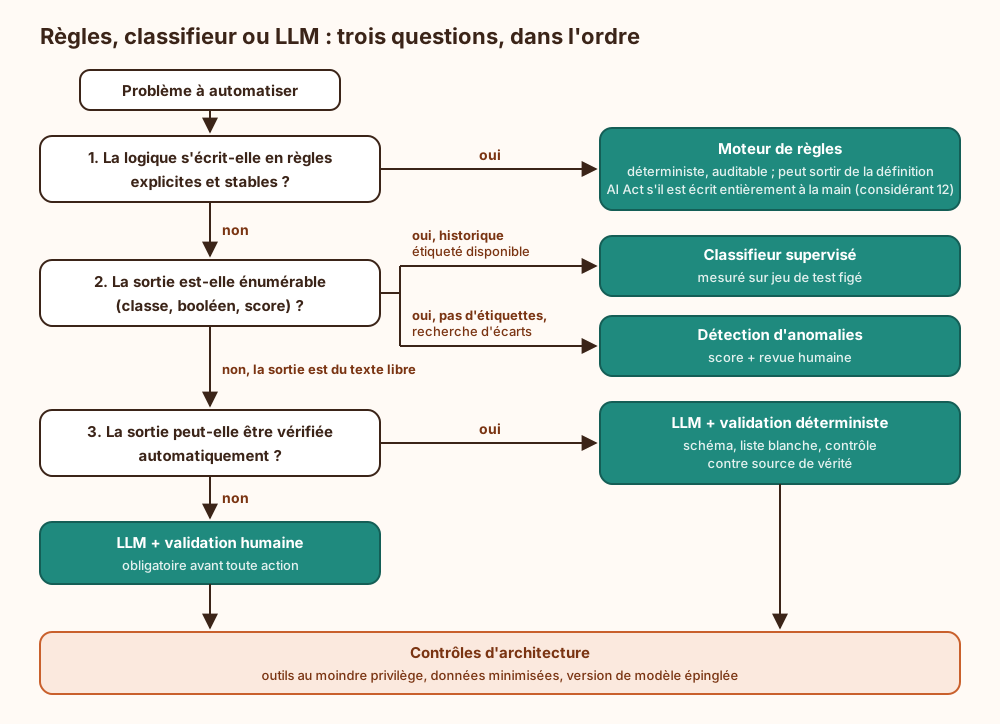
À lire de haut en bas : le LLM n’apparaît qu’après deux filtres, et il n’est jamais une feuille terminale nue, puisque les deux branches qui y mènent ajoutent une validation. Appliqué au tri d’alertes en trois niveaux de gravité, l’arbre s’arrête à la question 2 : classifieur. Appliqué à la rédaction d’une synthèse d’incident pour la direction, il descend jusqu’à la question 3 branche « non » : LLM, relecture humaine. Les deux usages coexistent souvent dans un même outil, et c’est très bien ainsi : le classifieur trie, le LLM rédige, et chacun reste dans la ligne du tableau où ses modes d’échec sont connus.
Un modèle d’embeddings est-il un LLM ?
Section intitulée « Un modèle d’embeddings est-il un LLM ? »Non. Un modèle d’embeddings repose souvent sur la même architecture transformeur, mais sa sortie est un vecteur de nombres, pas un texte généré. Il n’hallucine pas au sens génératif ; ses risques portent plutôt sur ce que le vecteur encode du texte d’origine. Voir la page sur les embeddings.
Un agent est-il une autre forme d’IA que le LLM ?
Section intitulée « Un agent est-il une autre forme d’IA que le LLM ? »Un agent, au sens actuel, est un LLM placé dans une boucle avec des outils, de la mémoire et des règles d’arrêt. Le modèle reste un LLM ; c’est l’architecture autour qui change, et la surface d’attaque avec elle. La définition est discutée dans la page sur l’agentique, l’état des produits dans assistants et agents actuels.
Le LLM est-il un pas vers l’IA générale ?
Section intitulée « Le LLM est-il un pas vers l’IA générale ? »C’est un débat ouvert, et la réponse ne change rien aux décisions d’architecture présentées ici : un système se conçoit avec les propriétés que le modèle a aujourd’hui, pas avec celles qu’on lui prête. Le débat est traité dans la page sur l’AGI.
🦫 Explication de la marmotte 🍫
Section intitulée « 🦫 Explication de la marmotte 🍫 »L’intelligence artificielle désigne tous les programmes qui accomplissent une tâche qu’on croyait réservée à l’humain. Certains suivent des règles écrites à la main par des personnes : si telle condition est vraie, alors faire telle chose. D’autres apprennent à partir d’exemples : on leur montre des milliers de courriels marqués « indésirable » ou « normal », et ils trouvent seuls ce qui les distingue. Ensuite, devant un nouveau courriel, ils répondent par une des deux étiquettes, et on peut compter combien de fois ils ont raison.
Le modèle de langage qui discute est un cas particulier. Pendant son apprentissage, il a lu d’énormes quantités de texte et appris une seule chose : deviner le morceau de mot qui vient ensuite. Pour répondre, il devine un morceau, l’ajoute, puis recommence. Il ne vérifie rien dans une liste de faits. Quand la suite la plus probable est fausse, il l’écrit quand même, avec assurance. Deux questions identiques peuvent recevoir deux réponses différentes. Et tout le texte qu’on lui donne, y compris un message piégé caché dans un document, peut modifier ce qu’il fait.
Voilà pourquoi le choix compte. Si la réponse attendue est une case parmi quelques-unes, un modèle qui classe fait mieux, se mesure et s’explique. Le modèle de langage sert quand il faut produire du texte, mais quelqu’un ou quelque chose doit vérifier ce qu’il écrit. La loi européenne sur l’intelligence artificielle fait elle aussi la différence entre un système complet et un modèle polyvalent.
À lire aussi
- Apprentissage automatique et réseaux de neurones, attaques du modèleComment un réseau de neurones apprend à partir de données (poids, perte, descente de gradient, rétropropagation) et où se placent l'empoisonnement, l'évasion, l'extraction et l'inversion sur le cycle de vie du modèle.
- Gardien IA pour LLM, fonctionnement, exemples et choix de produitCe qu'est un gardien en IA (modèle de garde placé autour d'un LLM), comment il filtre entrées, sorties et actions d'agent, ce qu'il ne garantit pas et quel produit retenir selon l'architecture.
- Faille chatbot Chevrolet 2023, Tahoe à 1 dollar et injectionComment le chatbot du concessionnaire Chevrolet de Watsonville a accepté de vendre un Tahoe 2024 pour un dollar par injection d'instructions, et ce qu'un gardien d'entrée et de sortie du LLM aurait intercepté.
- Relier FinOps et MLOps pour piloter le coût de l'IA en productionComment articuler FinOps et MLOps en IA pour attribuer, plafonner et contrôler le coût d'un modèle de l'entraînement à l'inférence, avec la surface d'attaque et les limites de l'approche.
Pages voisines
La citent
- Apprentissage automatique et réseaux de neurones, attaques du modèle
- D'où vient la peur de l'IA : les racines culturelles
Différence entre IA et LLM : un champ entier, un type de modèle
Elle cite
- Lien dans les deux sens :AGI : ce que recouvre l'intelligence artificielle générale
- Lien dans les deux sens :AI Act : définition du système d'IA (article 3, point 1)
- Comment fonctionne l'inférence d'un modèle de langage
- Embeddings : vecteurs, recherche sémantique et RAG
- L'IA actuelle : assistants conversationnels et agents
- Agentique : définition, lectures d'OpenAI et d'Anthropic, Claude Code
- Comment observer un LLM en production
- Comment valider le function calling d’un LLM
- Denial of wallet sur une application adossée à une API d'IA
- Déployer Ollama sur un poste de travail et dimensionner la mémoire
: les deux pages se citent l’une l’autre.