
Fine-tuning en IA, définition, usages et limites
Fine-tuning en IA, définition, usages et limites
Section intitulée « Fine-tuning en IA, définition, usages et limites »Le fine-tuning consiste à reprendre l’entraînement d’un modèle d’IA (intelligence artificielle) déjà entraîné, sur un jeu de données restreint, pour modifier durablement son comportement. Appliqué à un LLM (Large Language Model, grand modèle de langage), il règle une manière de répondre, pas un stock de connaissances. Cette distinction décide de presque tout : quand s’en servir, quand s’en passer, et ce qu’il coûte une fois en production.
→ Lire l’explication complète de la marmotte
Ce que le fine-tuning modifie dans un modèle
Section intitulée « Ce que le fine-tuning modifie dans un modèle »Un modèle de langage est une fonction paramétrée par des poids : des milliards de nombres ajustés pendant le pré-entraînement, sur un corpus généraliste, pour prédire le token suivant (voir apprentissage automatique et réseaux de neurones). Le fine-tuning reprend cette même descente de gradient, avec trois différences : un corpus beaucoup plus petit, un taux d’apprentissage plus faible, et un objectif étroit. On ne construit rien, on infléchit.
Deux familles coexistent, et le choix entre elles est d’abord une question de facture.
Le fine-tuning complet met à jour tous les poids. Le résultat est une copie entière du modèle, à stocker et à servir comme telle. L’entraînement exige de garder en mémoire les poids, leurs gradients et les états de l’optimiseur, soit plusieurs fois la taille du modèle. Il expose aussi à l’oubli catastrophique : en se spécialisant, le modèle dégrade des capacités générales que personne n’avait pensé à tester.
Le PEFT (Parameter-Efficient Fine-Tuning) gèle les poids d’origine et n’entraîne qu’un petit nombre de paramètres ajoutés. La méthode dominante est LoRA (Low-Rank Adaptation) : pour chaque matrice de poids ciblée, on apprend deux petites matrices de rang r dont le produit s’ajoute à la matrice d’origine. Moins de 1 % des paramètres sont entraînés dans les configurations courantes, et le résultat est un adaptateur de quelques dizaines de mégaoctets, chargeable et déchargeable sans toucher au modèle de base. QLoRA (Quantized LoRA) pousse la logique plus loin en chargeant le modèle de base quantifié sur 4 bits pendant l’entraînement, ce qui ramène le besoin en mémoire à la portée d’une seule carte graphique.
Le schéma suivant montre le cycle complet : ce qui entre, ce qui sort, et la boucle de retour que tout le monde oublie de budgéter.
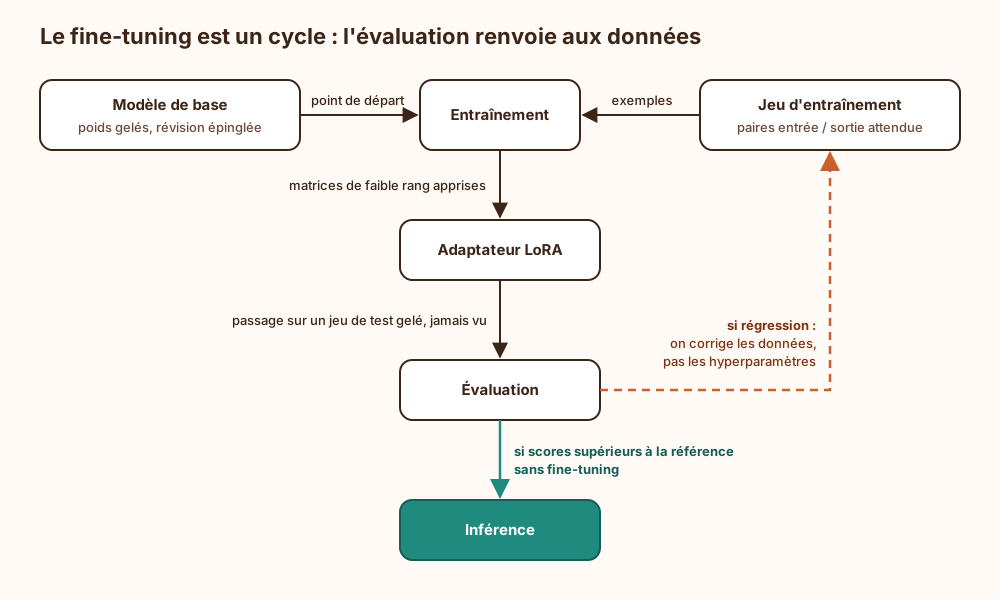
Position défendue ici : LoRA par défaut. Le fine-tuning complet ne se justifie que si une évaluation chiffrée montre qu’un adaptateur plafonne, ce qui arrive bien moins souvent que les demandes de budget matériel ne le laissent croire.
À quoi sert le fine-tuning, et à quoi il ne sert pas
Section intitulée « À quoi sert le fine-tuning, et à quoi il ne sert pas »Le compromis central tient en une phrase : on gagne un comportement stable, des prompts courts et la possibilité de faire tenir une tâche étroite dans un petit modèle ; on paie un jeu de données à constituer, un cycle de réentraînement à entretenir, et une copie figée des données logée dans des poids que personne ne sait auditer.
Ce que le fine-tuning fait bien :
- Imposer un format de sortie (structure, schéma, taxonomie interne) avec une régularité qu’un prompt n’obtient qu’à coups d’exemples répétés à chaque appel.
- Fixer un registre : ton, vocabulaire métier, niveau de détail, langue.
- Spécialiser une tâche étroite : classification, extraction, routage, réécriture.
- Distiller : faire reproduire par un petit modèle le comportement d’un gros sur une tâche précise, pour réduire latence et coût d’inférence.
Ce qu’il fait mal, et qu’on lui demande pourtant sans cesse : injecter des connaissances. Un fait vu quelques fois à l’entraînement n’est pas restitué de façon fiable, il n’est pas sourcé, et il est périmé dès que le document change. Pour des faits, des documents, de la fraîcheur ou des droits d’accès par utilisateur, la réponse est le RAG (Retrieval-Augmented Generation, génération augmentée par recherche documentaire), qui fournit les documents au moment de la requête. La comparaison détaillée est traitée dans fine-tuning ou RAG en local.
L’ordre de décision recommandé est le suivant, et il se lit de haut en bas sans sauter de ligne.
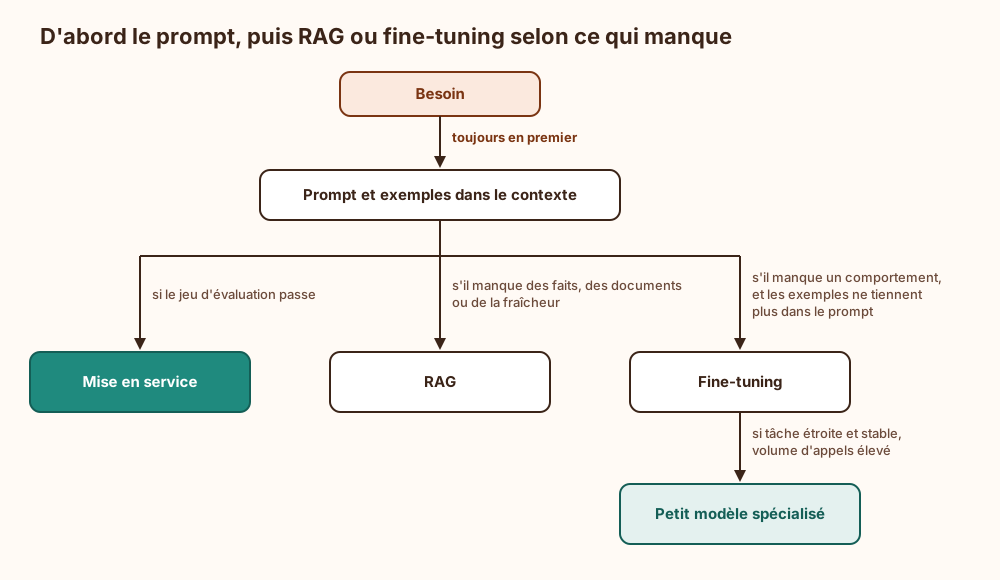
Le fine-tuning arrive en dernier parce qu’il est le seul des trois à produire un artefact à maintenir. Un prompt se corrige en une minute ; un adaptateur se réentraîne, se réévalue et se redéploie. Le secteur a pourtant une tendresse particulière pour le projet de fine-tuning lancé avant d’avoir écrit un seul prompt sérieux, sans doute parce que « modèle maison » sonne mieux en comité que « trois exemples bien choisis ».
Les deux approches ne s’excluent pas : un modèle ajusté pour le format peut très bien recevoir ses faits par RAG. La question qui tranche reste la même : ce qui manque, est-ce un savoir ou une habitude ?
Prérequis du fine-tuning : données, évaluation, matériel
Section intitulée « Prérequis du fine-tuning : données, évaluation, matériel »Avant la première époque d’entraînement, quatre choses doivent exister.
Un jeu d’évaluation gelé. Il se construit avant le jeu d’entraînement, il n’y est jamais mélangé, et il sert d’abord à mesurer la référence : le modèle de base avec le meilleur prompt disponible. Sans cette mesure, impossible de dire si le fine-tuning a apporté quoi que ce soit. La méthode est décrite dans évaluations de LLM.
Un jeu d’entraînement propre. Des paires entrée/sortie attendue, au format de conversation du modèle cible. L’ordre de grandeur va de quelques centaines d’exemples pour un format ou un ton à quelques milliers pour une tâche plus fine. La qualité domine la quantité : le modèle apprend les erreurs, les incohérences d’annotation et les tics de rédaction avec exactement la même application que le reste.
Un modèle de base dont la licence autorise l’usage visé. Certaines licences de poids ouverts restreignent l’usage commercial ou la redistribution de dérivés. Un adaptateur est un dérivé.
Du matériel, ou un service. En local : un GPU (Graphics Processing Unit, processeur graphique) dont la VRAM (Video Random Access Memory, mémoire de la carte) contient le modèle de base plus les activations ; avec QLoRA, un modèle de 7 à 8 milliards de paramètres s’ajuste sur une carte de 16 à 24 Go. Le dimensionnement est détaillé dans dimensionner le matériel d’inférence. En service hébergé, le fournisseur expose une API (Application Programming Interface) de fine-tuning : pas de matériel, mais le jeu d’entraînement part chez un tiers, avec les questions de rétention exposées dans données envoyées aux API d’IA.
Exemple de fine-tuning LoRA avec PEFT
Section intitulée « Exemple de fine-tuning LoRA avec PEFT »L’exemple ci-dessous ajuste un petit modèle ouvert avec la bibliothèque PEFT. Le modèle choisi (un demi-milliard de paramètres) tourne sur une machine modeste : le but est de montrer le mécanisme, pas d’obtenir un modèle de production.
Le fichier train.jsonl suit le format JSONL (JSON Lines : un objet JSON, JavaScript Object Notation, par ligne) :
{"messages": [{"role": "user", "content": "Classer : le certificat du portail expire demain"}, {"role": "assistant", "content": "{\"categorie\": \"pki\", \"urgence\": \"haute\"}"}]}Installation et entraînement :
pip install torch transformers peft datasetsfrom datasets import load_datasetfrom peft import LoraConfig, get_peft_modelfrom transformers import (AutoModelForCausalLM, AutoTokenizer, DataCollatorForLanguageModeling, Trainer, TrainingArguments)
BASE = "Qwen/Qwen2.5-0.5B-Instruct" # en production : épingler revision="<hash du commit>"tok = AutoTokenizer.from_pretrained(BASE)model = AutoModelForCausalLM.from_pretrained(BASE)
# Poids d'origine gelés ; seules les matrices LoRA (rang 16) sont entraînéesmodel = get_peft_model(model, LoraConfig( r=16, lora_alpha=32, lora_dropout=0.05, target_modules=["q_proj", "v_proj"], # projections d'attention ciblées task_type="CAUSAL_LM",))model.print_trainable_parameters() # affiche la part entraînée (< 1 %)
ds = load_dataset("json", data_files="train.jsonl", split="train")
def encode(ex): # Applique le format de conversation attendu par le modèle de base text = tok.apply_chat_template(ex["messages"], tokenize=False) return tok(text, truncation=True, max_length=1024)
ds = ds.map(encode, remove_columns=ds.column_names)
Trainer( model=model, args=TrainingArguments(output_dir="out", num_train_epochs=3, learning_rate=2e-4, per_device_train_batch_size=4, logging_steps=10, save_strategy="no", seed=42), train_dataset=ds, data_collator=DataCollatorForLanguageModeling(tok, mlm=False),).train()
model.save_pretrained("adapter") # n'écrit que l'adaptateur, au format safetensorsTrois points à lire dans ce script. Le rang r règle la capacité de l’adaptateur : trop bas, il n’apprend pas la tâche ; trop haut, il apprend le jeu d’entraînement par cœur. Le nombre d’époques (num_train_epochs) est le premier levier de surapprentissage, et aussi de mémorisation, ce qui devient un sujet de sécurité dans la section suivante. Enfin, le répertoire adapter ne contient pas le modèle : il ne vaut rien sans la révision exacte du modèle de base, d’où le commentaire sur l’épinglage.
Surface d’attaque du fine-tuning : empoisonnement, mémorisation, chaîne d’approvisionnement
Section intitulée « Surface d’attaque du fine-tuning : empoisonnement, mémorisation, chaîne d’approvisionnement »Le fine-tuning transforme un jeu de données en comportement. Tout ce qui peut altérer l’un altère l’autre, et la vérification a posteriori est médiocre : on ne relit pas des poids.
Empoisonnement du jeu d’entraînement. Quelques exemples piégés suffisent à installer une porte dérobée : un comportement normal partout, sauf en présence d’un déclencheur choisi par l’attaquant. Plus le jeu est petit, plus le poids relatif de chaque exemple est grand ; un jeu de fine-tuning est donc une cible bien plus rentable qu’un corpus de pré-entraînement. Contre-mesures : provenance tracée de chaque exemple, revue des contributions, contrôle d’accès en écriture sur le jeu, empreinte du fichier enregistrée avec chaque entraînement. Le détail figure dans empoisonnement des données d’entraînement.
Mémorisation et extraction. Un modèle ajusté peut restituer mot pour mot des séquences de son jeu d’entraînement, surtout les séquences rares ou répétées, et d’autant plus que les époques se multiplient. Or un modèle n’a pas de droits d’accès : tout utilisateur autorisé à l’interroger peut tenter d’en extraire ce qu’il a vu. Conséquence d’architecture : le modèle hérite de la classification de la donnée la plus sensible du jeu, et son périmètre de diffusion ne peut pas dépasser celui de cette donnée. Nettoyer le jeu avant l’entraînement (secrets, données personnelles, documents à diffusion restreinte) est la seule contre-mesure efficace ; filtrer les sorties est un rattrapage. Voir confidentialité et mémorisation d’un LLM interne.
Chaîne d’approvisionnement des poids. Un modèle de base ou un adaptateur téléchargé est du code tiers, parfois au sens littéral : les anciens formats de poids fondés sur la sérialisation pickle de Python exécutent du code arbitraire au chargement. N’accepter que le format safetensors, épingler les révisions par empreinte, et héberger une copie interne des artefacts validés. Un adaptateur récupéré sur un dépôt public parce qu’il « fait pile ce qu’il faut » mérite la même confiance qu’un binaire trouvé sur un forum.
Érosion des garde-fous du modèle. Le fine-tuning peut dégrader les comportements de refus appris par le modèle de base, y compris avec des données anodines : il suffit que l’entraînement pousse le modèle à obéir au format demandé coûte que coûte. Un modèle ajusté ne doit donc jamais être présumé aussi prudent que son parent. Les contrôles se placent hors du modèle (guardrails programmatiques) et se vérifient par des tests offensifs après chaque entraînement (red teaming d’un LLM local).
Ce que le fine-tuning ne garantit pas
Section intitulée « Ce que le fine-tuning ne garantit pas »- L’exactitude. Un modèle ajusté hallucine toujours, avec en prime le ton assuré de la maison. La vérification factuelle vient des sources fournies à la requête et des contrôles en aval.
- La fraîcheur. Les poids sont une photographie du jeu au jour de l’entraînement.
- Le cloisonnement. Aucune séparation par utilisateur, par projet ou par niveau d’habilitation n’existe dans des poids. Elle vient du contrôle d’accès au modèle lui-même et, pour les documents, d’un RAG filtré par droits.
- L’oubli. Retirer un exemple du jeu ne le retire pas du modèle. Une demande d’effacement fondée sur le RGPD (Règlement général sur la protection des données) portant sur une donnée d’entraînement se traduit, techniquement, par un réentraînement sans cette donnée. Mieux vaut y avoir pensé avant d’y mettre des données personnelles.
- La résistance à l’injection de prompt. Apprendre un comportement n’empêche pas une entrée hostile d’en demander un autre.
- La portabilité. Un adaptateur est lié à une révision précise du modèle de base. Nouvelle version du modèle : nouvel entraînement, nouvelle évaluation.
Côté réglementation, le règlement européen sur l’IA (règlement (UE) 2024/1689, dit AI Act) envisage explicitement le cas : son considérant 109 indique qu’en cas de modification ou de fine-tuning d’un modèle d’usage général, les obligations de fournisseur se limitent à cette modification. Ajuster un modèle n’est donc pas neutre sur le rôle endossé ; la page modèles d’usage général cite les articles, et le texte officiel fait foi.
Exploitation d’un modèle fine-tuné : versions, évaluation, reprise
Section intitulée « Exploitation d’un modèle fine-tuné : versions, évaluation, reprise »Un modèle ajusté est un artefact de production comme un autre, à ceci près qu’il n’a pas de code source lisible. Ses conditions d’exploitation en découlent.
Traçabilité de l’entraînement. Chaque adaptateur est enregistré avec : la révision du modèle de base (empreinte), l’empreinte du jeu d’entraînement, les hyperparamètres, la graine aléatoire, les versions des bibliothèques et les scores d’évaluation. Sans ce quintette (qui est un sextuor, la précision s’impose), impossible de reproduire un modèle ni d’expliquer pourquoi le suivant se comporte autrement.
Sauvegarde. L’actif à protéger est le jeu de données, pas l’adaptateur : le second se recalcule à partir du premier, l’inverse n’est pas vrai. Le jeu se sauvegarde, se versionne et se classe au niveau de sa donnée la plus sensible.
Promotion et retour arrière. Aucun adaptateur n’est promu sans passer le jeu d’évaluation gelé et une batterie de tests de non-régression sur les capacités générales. Garder l’adaptateur non fusionné avec le modèle de base permet de revenir à la version précédente par un changement de fichier. La fusion, puis la quantification éventuelle (comparatif des formats de quantification), produisent un nouvel artefact qui se réévalue : la quantification change les scores.
Cycle de vie du modèle de base. Les fournisseurs hébergés retirent leurs modèles selon leur propre calendrier, et les modèles ajustés partent avec. Le réentraînement périodique est donc une charge récurrente à inscrire au budget dès le départ, pas un incident.
Secrets et accès. Chez un fournisseur, le droit de lancer un entraînement et de lire les fichiers déposés doit être porté par une clé distincte de celle de l’inférence (clés d’API des fournisseurs d’IA). En local, le poste ou le serveur d’entraînement détient le jeu en clair : il se traite comme le système le plus sensible de la chaîne.
Supervision. Les entrées réelles s’éloignent du jeu d’entraînement avec le temps, et la qualité baisse sans alerte. Suivre en production le taux de sorties conformes au format, le taux de refus et un échantillon réévalué régulièrement (observabilité des LLM en production).
Le fine-tuning permet-il d’apprendre la documentation interne à un modèle ?
Section intitulée « Le fine-tuning permet-il d’apprendre la documentation interne à un modèle ? »Mal. Le modèle en retient des fragments, sans source, sans mise à jour et sans respect des droits d’accès. Pour interroger une base documentaire, le RAG est l’outil prévu pour cela ; le fine-tuning peut compléter, pour le format des réponses.
Faut-il fusionner l’adaptateur LoRA dans le modèle de base ?
Section intitulée « Faut-il fusionner l’adaptateur LoRA dans le modèle de base ? »Seulement si la latence ou le format de déploiement l’exige. Non fusionné, l’adaptateur se remplace et se retire à chaud, et plusieurs adaptateurs peuvent partager un même modèle de base en mémoire. Fusionné, on obtient un modèle complet de plus à stocker et à réévaluer.
Un modèle fine-tuné conserve-t-il les protections du modèle d’origine ?
Section intitulée « Un modèle fine-tuné conserve-t-il les protections du modèle d’origine ? »Pas nécessairement. Les comportements de refus font partie des poids et peuvent être dégradés par l’entraînement. Les contrôles de sécurité doivent rester à l’extérieur du modèle et être retestés après chaque fine-tuning.
🐝 Ce qui arrive si on s’en passe
Section intitulée « 🐝 Ce qui arrive si on s’en passe »Sans fine-tuning, tout le comportement attendu vit dans le prompt : consignes, exemples, format. Ce texte est renvoyé à chaque appel, donc facturé et ralenti à chaque appel, et il reste lisible par quiconque parvient à le faire réciter au modèle. La régularité du format dépend alors de la bonne volonté d’un modèle généraliste, ce qui oblige à écrire en aval du code de rattrapage pour les sorties mal formées. Une tâche étroite qui aurait tenu dans un petit modèle local continue de mobiliser un grand modèle, souvent chez un tiers, avec les données de chaque requête qui sortent du périmètre. Dans beaucoup de cas, ce prix reste parfaitement acceptable : se passer de fine-tuning est une option légitime, tant qu’elle est chiffrée plutôt que subie.
🦫 Explication de la marmotte 🍫
Section intitulée « 🦫 Explication de la marmotte 🍫 »Un modèle de langage est un programme dont le comportement tient dans des milliards de nombres réglés pendant un premier entraînement très long, sur d’énormes quantités de texte. Le fine-tuning reprend ce programme déjà entraîné et corrige une partie de ces nombres à l’aide d’exemples choisis : pour chaque question, la réponse attendue. Le programme répond, sa réponse est comparée à la bonne, et les nombres sont légèrement ajustés pour réduire l’écart. Après de nombreux passages, il répond dans le style voulu sans qu’on le lui redemande. Le plus souvent, on ne touche pas aux nombres d’origine : on apprend un petit fichier de corrections ajouté par-dessus, moins coûteux à calculer et facile à retirer. Cette méthode règle une manière de répondre, pas des connaissances : pour des informations récentes, il faut fournir les documents au moment de la question. Elle a des risques. Un exemple faux ou piégé dans les données devient une mauvaise habitude. Un texte confidentiel vu pendant l’entraînement peut ressortir devant n’importe quel utilisateur, et il n’existe aucun moyen de le faire oublier sans tout recommencer. Enfin, le fichier de corrections ne fonctionne qu’avec la version exacte du programme d’origine. Il faut donc conserver les exemples, tester chaque nouvelle version sur des questions jamais vues, et garder l’ancienne pour pouvoir revenir en arrière.
À lire aussi
- Gardien IA pour LLM, fonctionnement, exemples et choix de produitCe qu'est un gardien en IA (modèle de garde placé autour d'un LLM), comment il filtre entrées, sorties et actions d'agent, ce qu'il ne garantit pas et quel produit retenir selon l'architecture.
- Fenêtre de contexte et mémoire d’un LLM localChoisir, dimensionner et exploiter la fenêtre de contexte d’un LLM local sans sacrifier inutilement la performance, la sécurité ou la continuité des conversations.
- L'empoisonnement d'un RAG en une pageComment un document piégé glissé dans le corpus finit cité, ou obéi, par l'assistant qui le retrouve, en cinq étapes animées, avec les parades qui coupent la chaîne.
- Différence entre IA et LLM : un champ entier, un type de modèleDistinguer l'intelligence artificielle, champ entier aux nombreuses familles de modèles, du LLM, type récent de modèle de langage génératif, et en tirer les conséquences en sécurité, en architecture et en conformité AI Act.
Pages voisines
Fine-tuning en IA, définition, usages et limites
Elle cite
- Lien dans les deux sens :Empoisonnement des données d'affinage d'un LLM local et backdoor
- Lien dans les deux sens :Fine-tuning local ou RAG pour données internes
- Lien dans les deux sens :AI Act : obligations du fournisseur d'un modèle d'IA à usage général (article 53, annexes XI et XII)
- Comment observer un LLM en production
- Evals LLM comment mesurer qu'un assistant IA répond juste
- Apprentissage automatique et réseaux de neurones, attaques du modèle
- Comment éviter la mémorisation dans un LLM interne
- Comment fonctionne l'inférence d'un modèle de langage
- Comment red teamer un LLM local avant production
- Comparer GGUF GPTQ et AWQ pour LLM local
- Dimensionner GPU et RAM pour un LLM local
- Guardrails programmatiques pour assistant IA de production
: les deux pages se citent l’une l’autre.