
AI Act : définition du système d'IA (article 3, point 1)
AI Act : définition du système d’IA (article 3, point 1)
Section intitulée « AI Act : définition du système d’IA (article 3, point 1) »L’AI Act (Artificial Intelligence Act, règlement (UE) 2024/1689) ne s’applique qu’à ce qu’il appelle un « système d’IA » (intelligence artificielle), défini à l’article 3, point 1. Toute la suite du texte (interdictions, haut risque, transparence) dépend de cette qualification, qui tient en une phrase et que la Commission a commentée dans des lignes directrices non contraignantes. Position défendue ici : qualifier large, par écrit, et ne jamais sortir de la définition un système qui décide sur des personnes au seul motif d’une exclusion tirée de ces lignes directrices.
→ Lire l’explication complète de la marmotte
Le texte de l’article 3, point 1, et ses versions linguistiques
Section intitulée « Le texte de l’article 3, point 1, et ses versions linguistiques »La version française officielle, mot pour mot :
« “système d’IA”, un système automatisé qui est conçu pour fonctionner à différents niveaux d’autonomie et peut faire preuve d’une capacité d’adaptation après son déploiement, et qui, pour des objectifs explicites ou implicites, déduit, à partir des entrées qu’il reçoit, la manière de générer des sorties telles que des prédictions, du contenu, des recommandations ou des décisions qui peuvent influencer les environnements physiques ou virtuels »
Trois faits à poser avant d’interpréter quoi que ce soit.
La définition est en application. Elle vaut depuis le 2 février 2025 (article 113, qui rend applicables à cette date les chapitres I et II). Le règlement (UE) 2026/1744, dit omnibus IA, en vigueur depuis le 27 juillet 2026, n’a pas touché au point 1 : dans l’article 3, seuls le point 14 et les nouveaux points 14 bis et 14 ter, sur les petites et moyennes entreprises et les petites entreprises à moyenne capitalisation, ont bougé. Le reste des échéances est détaillé dans le calendrier d’application.
La version française porte deux écarts de traduction. L’article dit « système automatisé » là où l’anglais dit « machine-based system » ; le considérant 12 français, lui, parle du terme « fondé sur des machines », qui « renvoie au fait que les systèmes d’IA tournent sur des machines ». Même décalage pour « déduit » dans l’article, alors que le considérant 12 parle d’« inférence » (anglais « infers »). Toutes les versions linguistiques font foi. Lire « automatisé » comme « tout ce qui tourne tout seul » ferait entrer la minuterie du couloir dans le champ du règlement, ce que personne n’a demandé, pas même la minuterie.
La définition n’est pas une invention locale. Le considérant 12 veut une notion « étroitement alignée sur les travaux des organisations internationales œuvrant dans le domaine de l’IA ». Il ne nomme personne ; la proximité avec la définition révisée de l’OCDE (Organisation de coopération et de développement économiques) de novembre 2023 est un constat extérieur, pas une affirmation du texte.
Le texte intégral est sur EUR-Lex. La question de savoir à qui et où le règlement s’applique relève du champ d’application, pas de cette page.
Les sept éléments de la définition du système d’IA
Section intitulée « Les sept éléments de la définition du système d’IA »Les lignes directrices de la Commission sur la définition d’un système d’IA (C(2025) 924 final, publiées le 6 février 2025, prévues par l’article 96, paragraphe 1, point f) découpent la phrase en sept éléments (§9). Le schéma se lit de haut en bas, dans l’ordre de la phrase.
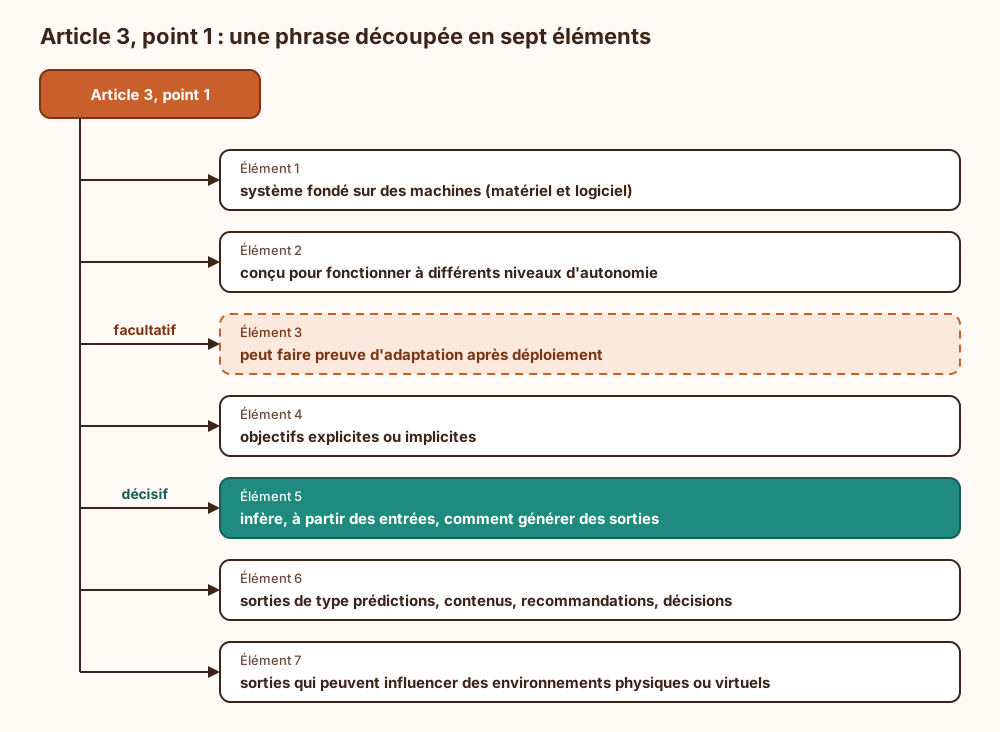
Tous ne pèsent pas le même poids. Lecture élément par élément :
- Machine (§11 à 13) : matériel et logiciel. Tout logiciel coche la case ; l’élément ne trie rien.
- Autonomie (§17 et 18) : le considérant 12 parle d’« un certain degré d’indépendance dans leur action par rapport à une ingérence humaine ». Seuls sortent les systèmes conçus pour fonctionner uniquement avec une intervention humaine manuelle complète. Un système dont les entrées sont saisies à la main mais qui produit seul sa sortie est autonome au sens du texte. L’argument « un humain clique sur le bouton » ne fait donc sortir personne.
- Adaptation (§22 et 23) : le texte dit « peut ». La capacité d’auto-apprentissage en cours d’utilisation est facultative ; un modèle aux poids figés reste dans la définition. C’est l’erreur de lecture la plus fréquente : « le modèle n’apprend plus en production, donc ce n’est pas de l’IA ». Si, c’en est.
- Objectifs (§24 et 25) : ils sont internes au système (ce qu’il optimise) et peuvent, dit le considérant 12, « être différents de la destination du système d’IA dans un contexte spécifique ». La destination (« intended purpose », article 3, point 12) est externe et fixée par le fournisseur. Les deux notions servent à des étapes différentes : l’objectif pour qualifier, la destination pour classer le risque.
- Inférence (§26 et suivants) : l’élément qui fait le tri, traité dans la section suivante.
- Sorties et influence : prédictions, contenus, recommandations, décisions, qui peuvent influencer un environnement. Un logiciel dont la sortie n’influence rien est un logiciel éteint ; l’élément ne filtre presque jamais.
Les lignes directrices distinguent deux phases du cycle de vie : la construction (avant déploiement) et l’utilisation (après). Les sept éléments n’ont pas à être présents en continu dans les deux (§10). Conséquence d’architecture : un système dont la capacité d’inférence a été acquise à la construction, puis gelée, est qualifié sur ce qu’il est, pas sur ce qu’il fait encore évoluer en production. Une plaquette qui annonce de l’IA ne prouve rien dans un sens ; une plaquette qui n’en parle pas ne prouve rien dans l’autre.
Le système peut être utilisé seul ou comme composant d’un produit, intégré ou non (considérant 12). Un moteur de détection enfoui dans une appliance reste un système d’IA, même si personne ne l’a acheté sous ce nom.
L’inférence, critère décisif entre système d’IA et logiciel classique
Section intitulée « L’inférence, critère décisif entre système d’IA et logiciel classique »Le considérant 12 est direct : « Une caractéristique essentielle des systèmes d’IA est leur capacité d’inférence ». Le mot recouvre deux choses, et c’est là que les ingénieurs se font piéger. Dans le vocabulaire courant, l’inférence désigne l’exécution d’un modèle déjà entraîné. Dans le règlement, elle désigne à la fois le processus qui génère des sorties et la capacité à « inférer des modèles ou des algorithmes, ou les deux, à partir d’entrées ou de données ». La phase de construction, entraînement compris, relève donc de l’inférence au sens du texte, et pas seulement l’exécution du modèle.
Le considérant nomme deux familles de techniques qui permettent cette inférence lors de la construction :
- les « approches d’apprentissage automatique qui apprennent à partir des données la manière d’atteindre certains objectifs » ; les lignes directrices citent l’apprentissage supervisé, non supervisé, auto-supervisé, par renforcement et profond (§30 à 39) ;
- les « approches fondées sur la logique et les connaissances qui font des inférences à partir des connaissances encodées ou de la représentation symbolique de la tâche à résoudre » : représentation des connaissances, programmation inductive, bases de connaissances, moteurs d’inférence et de déduction, raisonnement symbolique, systèmes experts, méthodes de recherche et d’optimisation.
L’inférence « va au-delà du traitement de données de base en ce qu’elle permet l’apprentissage, le raisonnement ou la modélisation ». À l’inverse, la définition « ne devrait pas couvrir les systèmes fondés sur les règles définies uniquement par les personnes physiques pour exécuter automatiquement des opérations ».
La conséquence à ne pas rater : « pas d’apprentissage automatique » ne veut pas dire « hors définition ». Un système expert qui raisonne sur des connaissances encodées, avec un moteur d’inférence qui enchaîne des déductions, peut être un système d’IA. Ce qui sort, c’est l’exécution automatique de règles écrites uniquement par des humains, sans inférence. La frontière ne passe pas entre « règles » et « neurones » ; elle passe entre « le système applique ce qu’on lui a dicté » et « le système établit lui-même comment produire la sortie ». Dix mille if imbriqués restent dix mille if : la complexité n’est pas un critère, sinon la moitié des scripts de sauvegarde seraient réglementés.
Les quatre familles exclues par les lignes directrices de la Commission
Section intitulée « Les quatre familles exclues par les lignes directrices de la Commission »Le statut d’abord. Les lignes directrices ne sont pas contraignantes ; l’interprétation qui fait autorité est celle de la Cour de justice de l’Union européenne, et la Commission annonce qu’elles évolueront. Elles éclairent la lecture d’une autorité ; elles ne protègent pas contre un juge qui lirait l’article autrement.
Elles décrivent quatre familles hors définition (§40 à 51), « en raison de leur capacité limitée à analyser des motifs et à ajuster de manière autonome leurs sorties » :
- Amélioration de l’optimisation mathématique (§42 à 45), y compris quand de l’apprentissage automatique accélère ou approxime une méthode établie. Les lignes directrices rangent la régression linéaire ou logistique parmi ces méthodes établies, avec les exemples de l’approximation de modèles physiques (prévision atmosphérique) et de l’allocation de bande passante satellitaire.
- Traitement de données de base (§46 et 47) : un SGBD (système de gestion de base de données) qui trie ou filtre, un tableur sans fonction d’IA, un tableau de bord de ventes, des statistiques descriptives de sondage.
- Heuristiques classiques (§48) : un programme d’échecs à algorithme minimax avec fonction d’évaluation heuristique.
- Systèmes de prédiction simples (§49 à 51) : l’estimateur par la moyenne. Cours de bourse moyen historique, température de demain égale à la moyenne d’hier, délai moyen de résolution d’un ticket, ventes moyennes par jour. Une moyenne glissante rebaptisée « moteur prédictif » sur une slide reste une moyenne.
Le point discuté par la doctrine concerne la première famille. Lue largement, elle semble faire sortir une régression logistique, alors qu’une régression logistique ajustée sur des données est de l’apprentissage automatique au sens du considérant 12. Les deux lectures existent ; seul un juge tranchera, et cette page ne le fait pas à sa place.
Le compromis central du sujet est là. Qualifier étroit raccourcit l’inventaire et évite toute analyse en aval, au prix d’une position qui repose sur un document non contraignant et révisable. Qualifier large allonge l’inventaire, mais coûte peu : les lignes directrices rappellent que la grande majorité des systèmes, même qualifiés de systèmes d’IA, ne sont soumis à aucune des exigences propres aux interdictions, au haut risque ou à la transparence. La recommandation suit : qualifier large par défaut, et ne jamais s’appuyer sur une exclusion des lignes directrices pour sortir un système qui décide sur des personnes (scoring, tri de candidatures). Pour un système qui optimise un flux physique sans effet sur quiconque, l’exclusion se défend ; elle se documente quand même.
Exemple : qualifier un logiciel avec l’arbre de décision
Section intitulée « Exemple : qualifier un logiciel avec l’arbre de décision »Les lignes directrices écartent toute détermination automatique et toute liste exhaustive : l’analyse se fait système par système (§61 et 62). L’arbre ci-dessous ordonne les questions ; il se lit de gauche à droite, chaque condition entre crochets ouvrant une branche.
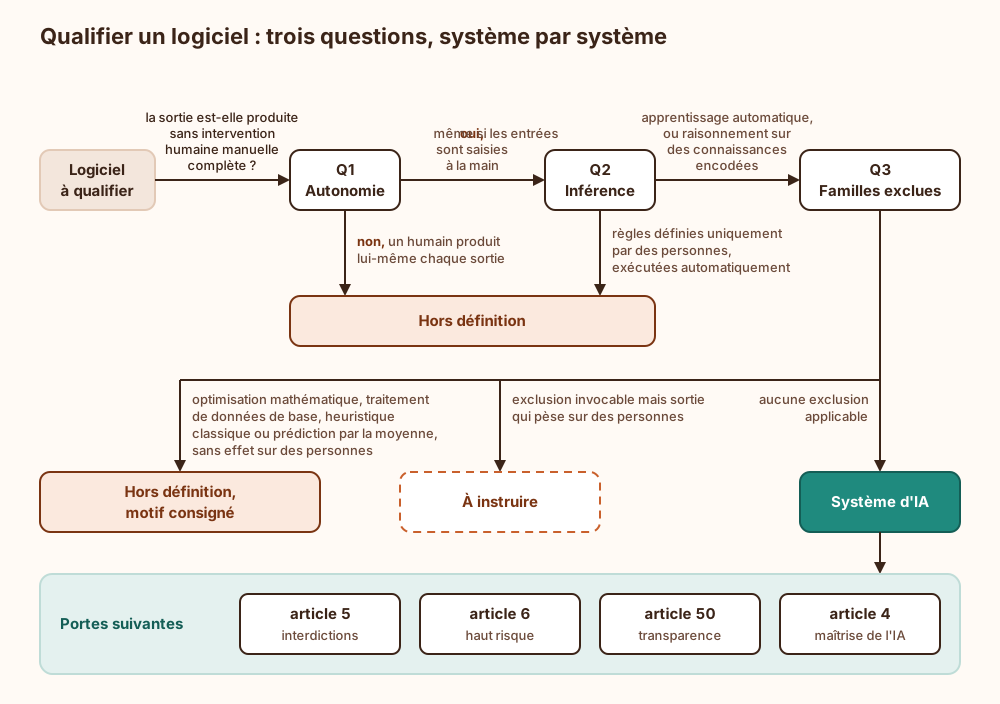
L’adaptation après déploiement n’apparaît pas dans l’arbre : facultative, elle ne change jamais la réponse. La branche « à instruire » est une branche d’escalade, pas un statut de repos : elle appelle une analyse écrite et, quand l’enjeu le justifie, un avis juridique.
Application à des logiciels courants en architecture sécurité et infrastructure :
| Logiciel | Classement | Motif |
|---|---|---|
| Filtre antispam bayésien | Dedans | Classifieur dont les paramètres sont appris sur des messages étiquetés |
| Détection d’anomalies par apprentissage d’un EDR (Endpoint Detection and Response) ou d’un SIEM (Security Information and Event Management) | Dedans | Modèle de comportement inféré à partir des données |
| Règle de corrélation SIEM écrite à la main | Dehors | Règle définie uniquement par une personne, exécutée automatiquement |
| Règle de pare-feu | Dehors | Même motif |
| Script d’exploitation | Dehors | Même motif |
| Macro de tableur | Dehors | Même motif ; tableur sans fonction d’IA (§46 et 47) |
| RPA (Robotic Process Automation) à règles fixes | Dehors | Enchaînement dicté par un humain, sans inférence |
| Système expert à moteur d’inférence | Dedans, en principe | Approche fondée sur la logique et les connaissances (considérant 12), dès lors que le moteur enchaîne lui-même des déductions |
| Scoring par régression logistique | À instruire | Exclusion des §42 à 45 invocable, mais apprentissage automatique au sens du considérant 12 ; à ne pas sortir s’il décide sur des personnes |
| Assistant bâti sur un LLM (Large Language Model) | Dedans | Apprentissage profond, génération de contenu |
| OCR (Optical Character Recognition) par réseau de neurones | Dedans | Apprentissage profond, sortie de type prédiction |
| Tableau de bord | Dehors | Traitement de données de base (§46 et 47) |
« Dedans » ne veut pas dire « réglementé lourdement ». Le filtre antispam et l’OCR entrent dans la définition et, dans la plupart des usages, ne déclenchent guère plus que la maîtrise de l’IA de l’article 4, qui vaut pour tout système d’IA.
Ce que la qualification de système d’IA ne garantit pas
Section intitulée « Ce que la qualification de système d’IA ne garantit pas »Elle ne dit rien du niveau de risque. C’est la première porte ; derrière viennent les pratiques interdites de l’article 5, la classification à haut risque de l’article 6, la transparence de l’article 50 et la maîtrise de l’IA de l’article 4. Chacune a ses propres critères.
Elle ne dit pas qui porte les obligations. Le même système d’IA place des charges différentes sur celui qui le met sur le marché et sur celui qui l’utilise : voir fournisseur, déployeur, importateur.
Elle ne couvre pas les modèles. Un « modèle d’IA à usage général » (article 3, point 63) n’est pas un système : le considérant 97 précise qu’il lui faut d’autres composants, par exemple une interface utilisateur, pour en devenir un. Le modèle suit son propre régime, décrit dans la page sur les modèles à usage général ; l’assistant construit autour est le système. La page LLM et IA résume la distinction côté technique.
Enfin, une sortie de la définition ne vaut que pour ce règlement. Un script de scoring hors AI Act reste soumis aux autres textes applicables aux traitements qu’il réalise.
Surface d’attaque de la qualification : contournements et dérives
Section intitulée « Surface d’attaque de la qualification : contournements et dérives »Une qualification se fausse de quatre façons connues, dont aucune n’a besoin d’un attaquant.
La requalification par le vocabulaire. « Ce ne sont que des statistiques » : phrase exacte pour à peu près tout l’apprentissage automatique, donc sans valeur de tri. Contre-mesure : qualifier sur la technique de construction, jamais sur le nom du produit ni sur celui du projet.
La dérive par mise à jour. L’exclusion vise le tableur « sans fonction d’IA ». Le jour où l’éditeur active une fonction de prédiction ou un assistant dans une version mineure, le motif d’exclusion tombe sans qu’aucune ligne de l’inventaire ne bouge. Contre-mesure : lier la qualification à une version et à une liste de fonctions activées, et la rouvrir à chaque montée de version.
Le composant enfoui. Un système d’IA peut être un composant intégré d’un produit. L’inventaire qui recense des produits et non des fonctions le rate. Contre-mesure : exiger de l’éditeur, au contrat, la description des techniques employées par fonction.
La confusion entre objectif et destination. Sortir un système au motif que son usage prévu est anodin mélange deux étapes. L’usage anodin se plaide à l’étape du risque ; il ne retire pas le système de la définition.
Prérequis et conditions d’exploitation d’un registre de qualification
Section intitulée « Prérequis et conditions d’exploitation d’un registre de qualification »Trois choses doivent exister avant de qualifier quoi que ce soit : un inventaire des logiciels par fonction (pas par contrat), un accès aux informations de conception (technique de construction, données d’apprentissage ou base de connaissances, mode de production de la sortie), et la version consolidée du règlement, omnibus compris, avec les lignes directrices dans leur dernière révision.
La qualification se consigne dans une fiche par système, tenue dans le même référentiel que l’inventaire :
- système, version, éditeur, fonctions activées ;
- technique de construction et source de l’information (documentation, réponse écrite de l’éditeur) ;
- réponse aux questions d’autonomie et d’inférence, avec le passage du considérant 12 qui la fonde ;
- exclusion invoquée le cas échéant, avec le paragraphe des lignes directrices ;
- effet de la sortie sur des personnes : oui ou non ;
- décision (dedans, dehors, à instruire), auteur, date.
Quatre événements rouvrent une fiche : changement de version ou de fonctions activées, changement d’usage, révision des lignes directrices, arrêt de la Cour de justice de l’Union européenne sur l’article 3, point 1. Une fiche « dehors » fondée sur une exclusion des lignes directrices est la plus fragile du registre, puisque son fondement est le seul que la Commission a annoncé vouloir faire évoluer : elle mérite une revue périodique, les fiches « dedans » beaucoup moins.
🐝 Ce qui arrive si on s’en passe
Section intitulée « 🐝 Ce qui arrive si on s’en passe »Sans qualification écrite, la première porte reste ouverte par défaut : aucun système n’est confronté aux interdictions, au classement à haut risque ni aux obligations de transparence, puisque ces contrôles ne se déclenchent que sur ce qui a été reconnu comme système d’IA. Un système sorti trop vite de la définition disparaît de toute la chaîne en aval, sans alerte : pas de journalisation exigée, pas de contrôle humain prévu, pas d’information des personnes concernées. L’erreur ne produit aucun symptôme technique ; elle se révèle lorsqu’une autorité, ou une personne visée par une décision, demande sur quel raisonnement le système a été écarté. Il faut alors reconstituer après coup des informations de conception que l’éditeur ne livre plus forcément, et rattraper d’un bloc des obligations qui se préparent dans la durée.
🦫 Explication de la marmotte 🍫
Section intitulée « 🦫 Explication de la marmotte 🍫 »La loi européenne sur l’intelligence artificielle ne s’applique qu’aux logiciels qui correspondent à sa définition. Cette définition tient en une phrase, que la Commission européenne découpe en sept conditions. Trois comptent vraiment. D’abord, le logiciel doit produire son résultat sans qu’un humain fasse tout à la main. Ensuite, et c’est le point décisif, il doit établir lui-même comment passer de ce qu’il reçoit à ce qu’il produit : soit parce qu’il a appris à partir d’exemples, soit parce qu’il raisonne sur des connaissances qu’on lui a fournies. Un programme qui applique à la lettre des règles écrites par une personne ne remplit pas cette condition, même s’il est très compliqué. Enfin, son résultat doit pouvoir changer quelque chose autour de lui. La Commission a aussi listé quatre sortes de logiciels qui restent dehors : les calculs d’optimisation, le tri et l’affichage de données, les astuces de calcul classiques et les prévisions par la moyenne. Cette liste n’a pas force de loi : seul un juge européen a le dernier mot. Quand un logiciel entre dans la définition, il faut ensuite vérifier s’il est interdit, risqué ou soumis à une obligation d’information ; la plupart ne le sont pas. Quand on le laisse dehors par erreur, aucune de ces vérifications n’a lieu, et l’erreur reste invisible jusqu’au jour où quelqu’un pose la question.
À lire aussi
- AI Act et modèle d'IA à usage général appelé par APIObligations de l'AI Act pour une organisation qui intègre un modèle d'IA à usage général accessible par API dans ses propres services, vues depuis la sécurité (transparence, maîtrise, documentation).
- AI Act : analyse d'impact sur les droits fondamentaux (article 27)Ce qu'exige l'article 27 du règlement (UE) 2024/1689, qui doit réaliser l'analyse d'impact sur les droits fondamentaux, avec quel contenu, et comment l'articuler avec l'analyse d'impact relative à la protection des données.
- AI Act : réclamation et droit à l'explication (articles 85 et 86)Ce que les articles 85 et 86 du règlement (UE) 2024/1689 ouvrent aux personnes face à une IA, réclamation et droit à l'explication, et ce que le déployeur doit journaliser pour y répondre.
- AI Act : qui contrôle, Bureau de l'IA, Comité IA et autorités nationales (articles 64 à 70 et 74)Répartition des rôles de contrôle de l'AI Act entre Bureau de l'IA, Comité IA, forum consultatif, groupe scientifique et autorités de surveillance du marché (articles 64 à 70 et 74), avec les exigences d'ingénierie qui en découlent.
Pages voisines
AI Act : définition du système d'IA (article 3, point 1)
Elle cite
- Lien dans les deux sens :AI Act : calendrier d'application 2025-2030 et ce qui s'applique déjà
- Lien dans les deux sens :AI Act : classer un système d'IA à haut risque (article 6, annexes I et III)
- Lien dans les deux sens :Différence entre IA et LLM : un champ entier, un type de modèle
- AI Act : bacs à sable réglementaires et mesures PME (art. 57 à 63)
- AI Act : champ d'application, qui est concerné et qui en sort (article 2)
- AI Act : fournisseur, déployeur, importateur et requalification en fournisseur
- AI Act : maîtrise de l'IA et obligation de former le personnel (article 4)
- AI Act : pratiques d'IA interdites par l'article 5 depuis février 2025
- AI Act : transparence des chatbots, hypertrucages et contenus générés (article 50)
- AI Act : obligations du fournisseur d'un modèle d'IA à usage général (article 53, annexes XI et XII)
- Apprentissage automatique et réseaux de neurones, attaques du modèle
- Comment fonctionne l'inférence d'un modèle de langage
: les deux pages se citent l’une l’autre.