
Cairn, un moteur multi-agents de recherche dans un espace d'états
Cairn, un moteur multi-agents de recherche dans un espace d’états
Section intitulée « Cairn, un moteur multi-agents de recherche dans un espace d’états »Cairn ne se présente pas comme un outil de sécurité. Ses auteurs en font un moteur de résolution de problèmes à usage général : on lui donne un point de départ, un but, et il cherche un chemin dans un espace d’états inconnu. Le test d’intrusion n’est qu’un terrain, choisi parce qu’il a exactement cette forme et parce qu’une compétition permettait de mesurer le résultat. Cette ambition théorique a une conséquence concrète : le moteur ne définit ni rôles, ni flux de travail, ni outils, et obtient sa puissance de frappe en déléguant à des agents de code existants auxquels il retire, par conception, tous leurs garde-fous.
→ Lire l’explication complète de la marmotte
À quoi sert Cairn, et ce qu’on appelle un harnais d’agent
Section intitulée « À quoi sert Cairn, et ce qu’on appelle un harnais d’agent »Un harnais d’agent est ce qu’on installe autour d’un modèle de langage pour qu’il agisse : la boucle qui exécute ce qu’il propose et lui renvoie le résultat, les outils, la mémoire, la gestion du contexte. Cairn s’arrête un étage plus haut : il ne fournit ni terminal, ni navigateur, ni mémoire de conversation, mais la boucle et la mémoire partagée, et sous-traite l’exécution à des harnais complets déjà installés, les agents de code en ligne de commande de Claude Code, de Codex et de Pi.
C’est ce qui le distingue des deux autres harnais de cette rubrique. L’un est un agent généraliste qui vit sur un poste de travail ; l’autre embarque son propre arsenal de test d’intrusion dans un conteneur et le pilote lui-même. Cairn est une couche de coordination : il n’a pas d’outils, il a des travailleurs à qui il ordonne quoi chercher.
Le problème qu’il traite est réel. Un agent unique lancé sur une cible complexe se perd : il suit une piste jusqu’à l’échec, oublie pourquoi il l’avait choisie, et recommence. Cairn externalise la mémoire de l’exploration dans un graphe que tous les agents lisent, et régénère les tâches depuis l’état de ce graphe plutôt que depuis un plan écrit d’avance.
Éditeur, licence et état du dépôt de Cairn
Section intitulée « Éditeur, licence et état du dépôt de Cairn »Le projet est publié sur le dépôt oritera/Cairn, créé le 19 avril 2026. Le fichier cairn/pyproject.toml nomme un auteur unique, « leixiao », avec une adresse de courriel personnelle ; le README affiche les logos du hackathon de Tencent Cloud et de la communauté ChainReactors. Plusieurs autres projets portent le nom Cairn sans aucun rapport avec celui-ci : la fiche ne décrit que oritera/Cairn.
La licence demande de l’attention, parce qu’elle est double. Le fichier LICENSE est le texte de la GNU AGPL (Affero General Public License) version 3, et le README précise la portée : AGPLv3 pour l’usage personnel et éducatif, licence commerciale à demander à l’auteur pour un usage commercial ou propriétaire sans les obligations de l’AGPL. Celle-ci est la plus contraignante des licences libres courantes, puisqu’elle étend l’obligation de publication du code au service rendu par le réseau : une société qui exposerait ce moteur à ses clients devrait publier ses modifications ou acheter la licence. Le README ajoute que toute contribution est acceptée sous les deux régimes à la fois, mécanisme habituel de ce modèle qui mérite d’être su avant de contribuer.
La version la plus récente lue pendant la rédaction de cette fiche est la v0.2.1, publiée le 10 mai 2026, numéro que confirme le pyproject.toml. Trois versions au total, de mai 2026. Le dernier envoi sur la branche principale date du 7 septembre 2026 : le dépôt est donc calme depuis plusieurs mois, ce qui, pour un outil qui pilote des agents offensifs, est une information de sécurité autant qu’une information de maintenance.
Architecture de Cairn : tableau noir, Fact, Intent, Hint
Section intitulée « Architecture de Cairn : tableau noir, Fact, Intent, Hint »Le moteur repose sur une architecture de tableau noir, ce schéma ancien où des agents indépendants n’échangent rien directement et se coordonnent uniquement par ce qu’ils écrivent sur un support commun. Les auteurs parlent de stigmergie, le terme employé pour les fourmis qui se guident par leurs traces.
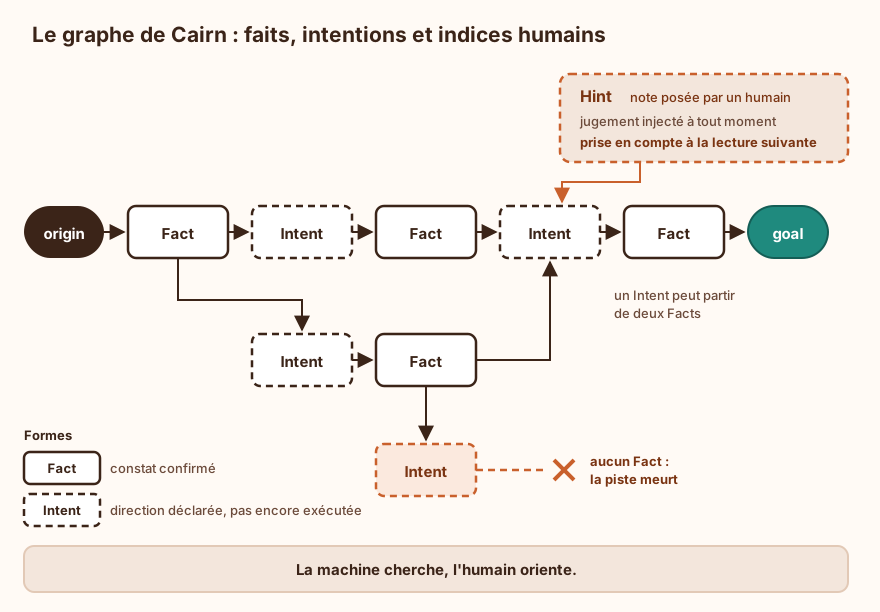
Trois primitives suffisent au graphe :
- Fact : un constat objectif et confirmé, écrit au tableau. C’est un point d’appui.
- Intent : une direction d’exploration déclarée, pas encore exécutée. C’est un pas dans l’inconnu.
- Hint : un jugement humain, injecté à tout moment, absorbé par les agents à leur lecture suivante.
Le graphe part de l’origine et pousse vers le but. Trois types de tâches, exécutées par le même travailleur, le font grandir. Bootstrap tente de résoudre le problème directement au démarrage. Reason lit le graphe entier et répond à deux questions : le but est-il atteint, et faut-il proposer de nouvelles intentions. Explore réclame une intention, l’exécute et rapporte un fait.
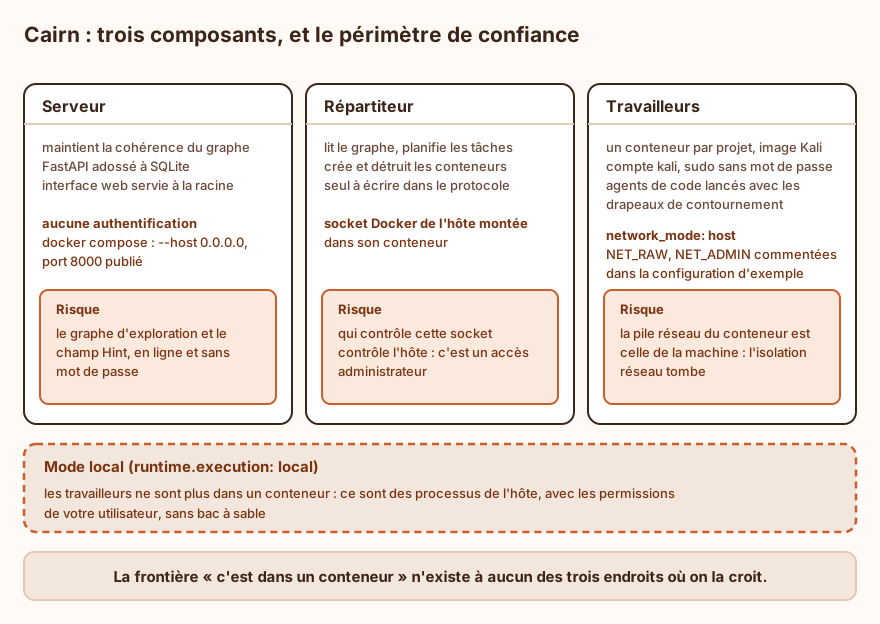
Au-dessus, trois composants. Le serveur ne fait qu’une chose, maintenir la cohérence du graphe : une application FastAPI adossée à SQLite, qui sert aussi une interface web de visualisation. Le répartiteur lit le graphe, planifie les tâches, crée et détruit les conteneurs de travailleurs, et reste le seul à écrire dans le protocole. Les travailleurs reçoivent un prompt et renvoient une sortie structurée en JSON ; ils n’ont aucun rôle fixe, les tâches étant engendrées à l’exécution depuis l’état du graphe, non depuis des fiches de poste.
La configuration d’exemple donne les ordres de grandeur : un tour de planification toutes les trois secondes, huit travailleurs au maximum, trois projets actifs simultanés, un délai de trois cents secondes par tâche, et au plus deux nouvelles intentions par étape de raisonnement. Ce dernier plafond est le frein principal contre l’emballement combinatoire : sans lui, un graphe d’exploration double de taille à chaque tour. Quant aux prompts fournis, lisibles dans le dépôt, ils imposent une sortie JSON brute et contiennent une consigne sans ambiguïté : l’agent ne doit refuser la tâche en aucune circonstance. Les mécanismes de coordination de ce genre d’ensemble sont traités dans la page sur la sécurité de l’orchestration multi-agents.
Prérequis, installation et les deux modes d’exécution
Section intitulée « Prérequis, installation et les deux modes d’exécution »Les prérequis annoncés sont macOS ou Linux, Python 3.12 au minimum, et Docker pour l’exécution en conteneur, dont le mode local se dispense. Les dépendances Python sont légères, ce qui est logique pour un moteur qui ne fait rien lui-même.
# Image du conteneur de travailleurs, puis configuration locale à remplirdocker pull --platform=linux/amd64 ghcr.io/oritera/cairn-worker-container:latestcp dispatch.example.yaml dispatch.yaml
# Voie recommandée : serveur sur le port 8000, puis répartiteurdocker compose up --build
La voie manuelle sépare les deux processus, et un drapeau utile permet de ne lancer que les contrôles de démarrage, sans travailler :
# Serveur dans un terminal, répartiteur dans un autreuv run --project cairn cairn serveuv run --project cairn cairn dispatch --config dispatch.yaml
# Vérifier seulement que les travailleurs répondent, puis sortiruv run --project cairn cairn dispatch --config dispatch.yaml --startup-healthcheck-only
Le mode conteneur est le mode par défaut : un conteneur par projet, construit sur Kali Linux, dans lequel le répartiteur exécute les commandes des agents. L’image est dense : scanners et moteurs de modèles de vulnérabilités, reconnaissance et force brute Kerberos, boîte à outils de domaine Active Directory, tunnels, navigateur sans interface, et surtout quatre dépôts de connaissances offensives et cinq dépôts de preuves de concept clonés sur le disque, pour que l’agent y cherche un exploit existant au lieu d’en écrire un. C’est la base de la distribution décrite dans la fiche Kali Linux, avec un compte kali doté de sudo sans mot de passe.
Le mode local, activé par runtime.execution: local, se passe de Docker : les travailleurs tournent comme des processus de l’hôte et réutilisent les interfaces en ligne de commande déjà installées et connectées sur la machine. Aucune clé n’est alors nécessaire dans la configuration, puisque chaque outil utilise sa propre session. La documentation du projet l’écrit elle-même, et il faut la citer : le mode local exécute les agents avec les permissions de votre utilisateur et sans bac à sable.
Quand on sort Cairn, et quand un autre outil ferait mieux
Section intitulée « Quand on sort Cairn, et quand un autre outil ferait mieux »L’usage pour lequel il a été éprouvé est la compétition : des épreuves à objectif net, sur une infrastructure prévue pour être attaquée, avec un drapeau qui prouve la réussite. Il convient aussi à un laboratoire d’étude : pour qui veut comprendre comment une recherche multi-agents se structure, le dépôt est court, lisible et honnête sur ses mécanismes.
En dehors de cela, trois réserves. Sur une mission contractuelle, le moteur ne produit ni rapport exploitable, ni traçabilité auditable, ni preuve de concept rejouable : il produit un graphe de faits. Sur un système de production, le cumul des réglages par défaut en fait un outil dangereux, pour la raison détaillée plus bas. Et pour automatiser du test applicatif, un harnais qui embarque son propre outillage et ses propres garde-fous est mieux adapté. La page commander, cadrer et exploiter un test d’intrusion rappelle ce qu’un livrable doit contenir.
Ce que Cairn montre, ce qu’il ne montre pas, et ce que ses auteurs affirment
Section intitulée « Ce que Cairn montre, ce qu’il ne montre pas, et ce que ses auteurs affirment »Il montre le graphe, et c’est son meilleur apport. Un faisceau de faits reliés par des intentions se lit mieux qu’un journal de conversation : on voit ce qui a été établi, ce qui a été tenté, et depuis quel constat chaque piste est partie. L’interface web rend ce graphe navigable, et le champ Hint permet d’y verser une intuition humaine en cours de route : la machine cherche, l’humain oriente.
Il ne montre pas ce qui s’est passé à l’intérieur d’une exploration. Un travailleur reçoit un prompt et rend un résumé en JSON ; ce qu’il a réellement exécuté dans le conteneur reste dans la session de l’agent sous-jacent, et les descriptions longues sont explicitement renvoyées vers des fichiers, ce qui allège le graphe et éparpille les preuves. Il ne montre pas non plus le coût.
Sur ses résultats, le dépôt avance un palmarès précis, à attribuer à ses auteurs. Selon le README, lors de la deuxième édition de l’épreuve de test d’intrusion par IA du hackathon de Tencent Cloud, qui réunissait 610 équipes et 1 345 participants, Cairn a résolu 54 problèmes sur 54, seule équipe à y parvenir, pour un classement final de 3e place. Les auteurs ajoutent que le système n’avait jamais été testé avant la compétition, que la chaîne complète a fonctionné pour la première fois à quatre heures du matin le jour de l’épreuve, et qu’il n’y avait ni entraînement, ni réglage, ni outillage spécifique au domaine, ni base documentaire, ni rôle prédéfini. Un score parfait associé à une troisième place indique que le classement intégrait d’autres critères, que le README ne détaille pas.
Une nuance de périmètre s’impose. Le fichier de contexte livré dans le conteneur de travailleurs est rédigé en chinois et décrit les quatre niveaux de cette compétition, jusqu’aux chemins où trouver les preuves de concept et à un champ à remplir avec l’adresse publique à employer pour les shells inversés et l’exfiltration hors bande. C’est un fichier taillé pour une épreuve : les résultats annoncés valent pour ce terrain, et rien dans le dépôt ne les étend à une application d’entreprise.
Risques de Cairn et conditions d’exploitation
Section intitulée « Risques de Cairn et conditions d’exploitation »C’est la section décisive, et elle se résume en une phrase : les réglages par défaut privilégient l’efficacité en compétition sur tout le reste. Cinq points.
Les garde-fous des agents sous-jacents sont désactivés par conception. Les adaptateurs de travailleurs, lisibles dans le dépôt, lancent l’agent de Claude Code avec --dangerously-skip-permissions et celui de Codex avec --dangerously-bypass-approvals-and-sandbox. Ces drapeaux portent bien leur nom : ils suppriment la demande d’approbation des commandes et, pour le second, le bac à sable. C’est cohérent avec l’objectif (un agent qui demande la permission ne finit pas une épreuve en temps limité) et cela signifie que Cairn ne dispose d’aucune barrière d’exécution propre. En mode local, le cumul est explicite : des agents aux permissions de votre compte, sans bac à sable, sans approbation. Le guide d’usage de Claude Code décrit ce que ces drapeaux neutralisent.
Le réseau du conteneur est celui de l’hôte. La configuration d’exemple pose network_mode: "host" sur le conteneur de travailleurs : celui-ci partage la pile réseau de la machine, voit ses interfaces et ses services locaux, et émet avec son adresse. Les capacités NET_RAW et NET_ADMIN sont, elles, commentées dans l’exemple, avec l’invitation à ne les activer qu’au besoin. Mais le choix du réseau hôte annule l’essentiel du bénéfice d’isolation qu’on attend d’un bac à sable d’outils offensifs.
Le répartiteur contrôle le démon Docker. Le fichier de composition monte la socket Docker de l’hôte dans le conteneur du répartiteur. C’est nécessaire, son travail étant de créer et détruire des conteneurs, et c’est équivalent à un accès administrateur sur la machine : qui contrôle cette socket contrôle l’hôte. Le répartiteur doit donc vivre sur une machine dédiée, jetable, sans route vers quoi que ce soit de sérieux.
Le serveur n’a pas d’authentification, et le fichier de composition l’expose. Le code du serveur ne comporte aucun contrôle d’accès : les routes de projets, d’intentions, d’indices et d’export sont ouvertes, et l’interface web est servie à la racine. La commande en ligne écoute par défaut sur l’interface de bouclage, mais le fichier de composition la lance avec --host 0.0.0.0 et publie le port 8000. Sur une machine exposée, cela met en ligne, sans mot de passe, le graphe complet d’une exploration offensive et le champ qui permet d’injecter des indices aux agents. Le réglage à tenir est l’inverse : écoute sur la boucle locale, accès par tunnel, pare-feu.
Les clés, le coût et les données. En mode conteneur, les jetons d’API des fournisseurs de modèles figurent en clair dans dispatch.yaml, aux côtés d’une adresse de base librement configurable : c’est un fichier de secrets, à traiter comme tel, avec les précautions de la page sur les clés API des fournisseurs d’IA. Côté dépense, les seules limites prévues sont des plafonds de concurrence et des délais par tâche ; rien ne borne la facture, situation décrite dans la page sur le déni de portefeuille. Enfin, tout ce que les agents lisent part chez les fournisseurs de modèles, cartographie de la cible comprise, sujet traité dans la page sur les données envoyées aux API d’IA.
Reste le risque propre à l’architecture : le tableau noir est la mémoire commune, et rien n’y distingue un fait établi par l’agent d’un fait que la cible lui a soufflé. Un service piégé qui renvoie du texte bien tourné peut faire inscrire une fausse certitude dans le graphe, que les travailleurs suivants traiteront comme un point d’appui. C’est de l’injection de prompt à mémoire partagée, mécanisme décrit dans la page sur la sécurité des agents autonomes outillés.
D’autres fiches de la même famille sont regroupées dans la rubrique Outils.
Côté défense : ce que Cairn apprend, et comment repérer son usage
Section intitulée « Côté défense : ce que Cairn apprend, et comment repérer son usage »Pour un défenseur, l’intérêt de ce projet n’est pas de le lancer : c’est de le lire. Le dépôt est petit, et il montre noir sur blanc comment une recherche offensive se structure quand elle est confiée à des machines : un graphe de faits, des intentions parallèles, des travailleurs interchangeables, une mémoire qui survit à l’échec de chaque piste.
Pour la détection, il n’y a pas de signature de Cairn à chercher, puisqu’il n’exécute rien lui-même. Ce qui se voit, ce sont ses travailleurs, et ils sont très visibles : le conteneur embarque des outils dont les empreintes réseau sont documentées depuis des années, et les comportements qui vont avec, balayage de services, essais Kerberos en rafale, requêtes vers une plateforme de réception pour l’exfiltration hors bande, mise en place de tunnels. Un autre signal est propre à l’architecture : les explorations étant parallèles, plusieurs pistes très différentes progressent sur la même cible dans la même minute, ce qu’un humain seul ne fait pas. Côté hôte, en mode local, on voit des processus d’agents de code lancés en boucle avec des drapeaux de contournement, motif de supervision des postes à lui seul.
Un dernier point pour qui déploierait ce moteur : son interface web est le panneau d’administration d’une opération offensive, servi sans authentification. Si la question « ce port est-il joignable depuis Internet » n’a pas de réponse écrite, la réponse est probablement oui. Des opérateurs criminels l’ont appris à leurs dépens, et surtout aux dépens de leurs victimes : plus de vingt panneaux Cairn ouverts sur Internet ont exposé leurs cibles, leurs secrets et leurs commandes.
Cadre légal : un moteur généraliste ne dispense de rien
Section intitulée « Cadre légal : un moteur généraliste ne dispense de rien »Le dépôt porte un avertissement, et il est juste : le projet est destiné aux seuls environnements où l’on détient une autorisation explicite d’opérer, l’utilisateur est seul responsable de son usage, et rien ne doit être lancé contre un système, un réseau, une application ou des données sans permission préalable claire de leur propriétaire ou exploitant.
En France, les articles 323-1 et suivants du code pénal répriment l’accès ou le maintien frauduleux dans un système de traitement automatisé de données (323-1), l’entrave ou le faussement de son fonctionnement (323-2), l’introduction, la modification ou la suppression frauduleuse de données (323-3), la mise à disposition sans motif légitime d’outils conçus pour commettre ces infractions (323-3-1), et punissent la tentative comme l’infraction (323-7). Les peines figurent dans les textes, à lire sur Légifrance. La question du motif légitime et de la bonne foi du chercheur est abordée dans la page sur les tensions juridiques du signalement de failles.
Deux particularités aggravent le risque juridique par rapport à un outil classique. La première est l’absence de notion de périmètre : rien dans la configuration ne liste les cibles autorisées, l’origine et le but sont du texte libre, et les agents ont pour consigne de ne jamais refuser une tâche. Un but formulé largement produit des actions larges. La seconde est le champ Hint, qui permet à quiconque atteint l’interface d’orienter les agents en cours d’exploration : sans authentification, l’autorisation écrite que vous détenez ne couvre pas ce que fera un visiteur. Pour s’exercer, les cibles de compétition et les laboratoires existent, et c’est le terrain pour lequel ce moteur a été écrit.
🐝 Ce qui arrive si on s’en passe
Section intitulée « 🐝 Ce qui arrive si on s’en passe »On peut très bien ne jamais installer ce moteur, et c’est même la recommandation sur un réseau d’entreprise. Ce qu’on ne peut pas se permettre, c’est d’ignorer la bascule qu’il illustre : la partie coûteuse d’une attaque n’est plus l’outil, c’est la méthode, et la méthode vient d’être écrite en quelques milliers de lignes de Python par une personne seule, qui l’a publiée. Une équipe qui n’a pas regardé cela continue de raisonner sur un attaquant qui suit un chemin à la fois, alors que le modèle qui arrive explore huit pistes en parallèle et n’oublie rien. Elle calibre ses seuils d’alerte sur la lenteur humaine et juge improbables des enchaînements qu’une recherche organisée assemble. Le plus pénible reste que ce moteur publie son propre graphe d’exploration sur un port sans mot de passe : il arrive que la menace nouvelle et la négligence ancienne tiennent dans le même programme.
🦫 Explication de la marmotte 🍫
Section intitulée « 🦫 Explication de la marmotte 🍫 »Imagine un labyrinthe dont tu connais l’entrée et la sortie, mais pas le chemin. Pour le traverser, tu peux envoyer plusieurs explorateurs et leur demander d’écrire sur un grand tableau tout ce qu’ils découvrent : « ce couloir mène à une porte fermée », « cette porte s’ouvre avec la clé trouvée en bas ». Personne ne parle à personne, tout passe par le tableau, et chacun lit le tableau avant de repartir. C’est exactement le fonctionnement de Cairn, à ceci près que les explorateurs sont des programmes d’intelligence artificielle et que le labyrinthe est un système informatique.
Le tableau contient trois sortes de notes : des faits, ce qui est confirmé, des intentions, ce que quelqu’un va essayer, et des indices, que toi, l’humain, peux ajouter à tout moment pour donner un coup de pouce. Un programme chef d’orchestre lit le tableau, décide quelles pistes valent le coup, et lance des explorateurs dessus ; aucun n’a de spécialité, c’est l’état du tableau qui décide du travail.
Ce que Cairn ne fait pas lui-même mérite d’être compris : il n’a aucun outil. Pour agir, il appelle d’autres programmes d’intelligence artificielle déjà installés sur la machine, ceux qui savent écrire du code et lancer des commandes, et leur demande de travailler sans poser de question. Ces programmes possèdent normalement une sécurité qui demande l’accord de l’humain avant une action risquée ; Cairn la désactive, pour aller plus vite.
Trois choses à retenir. Ce moteur a été écrit pour une compétition de sécurité informatique, qu’il a gagnée en résolvant toutes les épreuves, d’après ses auteurs : c’est son terrain, et ce n’est pas la même chose qu’une entreprise réelle. Son tableau de bord s’affiche sur une page web sans mot de passe, donc n’importe qui pouvant l’atteindre peut lire l’enquête en cours et y glisser des indices. Et comme pour tout outil de ce genre, attaquer un système sans l’accord écrit de son propriétaire est un délit en France, même si rien n’est cassé.
- oritera/Cairn, README, oritera, consulté le 21 octobre 2026
- oritera/Cairn, fichier LICENSE (GNU AGPL v3), oritera
- oritera/Cairn, cairn/pyproject.toml (version 0.2.1, auteur, dépendances), oritera
- oritera/Cairn, versions publiées, oritera, v0.2.1 du 10 mai 2026
- oritera/Cairn, dispatch.example.yaml (réseau hôte, plafonds, clés), oritera
- oritera/Cairn, dispatch.local.example.yaml (mode local, sans bac à sable), oritera
- oritera/Cairn, docker-compose.yaml (socket Docker montée, écoute sur 0.0.0.0), oritera
- oritera/Cairn, container/Dockerfile (image Kali des travailleurs), oritera
- oritera/Cairn, container/AGENTS.md (fichier de contexte de la compétition), oritera
- oritera/Cairn, adaptateurs de travailleurs (drapeaux de contournement), oritera
- oritera/Cairn, serveur FastAPI (aucune authentification), oritera
- oritera/Cairn, prompts par défaut (bootstrap, reason, explore), oritera
À lire aussi
- Strix, des agents de test d'intrusion autonomes en bac à sableFiche de l'outil Strix : des agents IA de test d'intrusion qui exploitent et valident les failles dans un conteneur Kali, avec son architecture multi-agents, son installation, ses garde-fous, son coût et le cadre légal du périmètre autorisé.
- Hermes Agent, le harnais d'agent autonome de Nous ResearchFiche de l'outil Hermes Agent, harnais d'agent généraliste de Nous Research : architecture, installation, backends d'exécution, mémoire persistante, garde-fous d'approbation, et les risques d'un agent qui agit avec vos droits.
- Installer et utiliser Codex, l'agent de code d'OpenAIGuide pas à pas pour installer Codex CLI, s'authentifier sans exposer de jeton, régler le bac à sable et les approbations, écrire un fichier AGENTS.md, et savoir quand confier une tâche à l'agent ou s'en abstenir.
- ASI05 : exécution de code inattendue par un agentASI05 du Top 10 OWASP des applications agentiques : comment du texte généré par un agent devient du code exécuté sur l'hôte, ce qui sépare ce risque du mésusage d'outils, et ce qui le contient.
Pages voisines
Cairn, un moteur multi-agents de recherche dans un espace d'états
Elle cite
- Lien dans les deux sens :Cairn : panneaux d'opérations offensives par agents IA exposés sur Internet
- Kali Linux pour les tests d'intrusion, usages, limites et détection
- Bug bounty gouvernemental et immunité pénale
- Denial of wallet sur une application adossée à une API d'IA
- Installer et utiliser Claude Code, l'agent de code d'Anthropic
- Pourquoi les CTF créent des compétences offensives réutilisables
- Rétention des données envoyées à une API d'IA générative
- Sécuriser les actions irréversibles des agents LLM
- Sécuriser les clés d'API des fournisseurs d'IA générative
- Sécuriser une orchestration multi-agents IA
- Test d'intrusion : commander, cadrer et exploiter un pentest
: les deux pages se citent l’une l’autre.