
Relier FinOps et MLOps pour piloter le coût de l'IA en production
Relier FinOps et MLOps pour piloter le coût de l’IA en production
Section intitulée « Relier FinOps et MLOps pour piloter le coût de l’IA en production »En IA (intelligence artificielle), le FinOps (Financial Operations, la discipline qui rend la dépense d’infrastructure lisible et pilotable) et le MLOps (Machine Learning Operations, l’industrialisation du cycle de vie des modèles) vivent le plus souvent dans deux équipes qui ne se parlent qu’au moment de la facture. Cette page défend une position : le coût est une métrique du pipeline, mesurée par version de modèle et contrôlée à la promotion, pas un rapport mensuel commenté avec gravité. Elle détaille ce que cela exige, ce que cela expose et ce que cela ne garantit pas.
→ Lire l’explication complète de la marmotte
Ce que FinOps et MLOps changent quand la charge est un modèle
Section intitulée « Ce que FinOps et MLOps changent quand la charge est un modèle »Sur une application classique, le coût suit à peu près le trafic et l’architecture bouge peu. Sur un modèle, le coût dépend de décisions prises par des gens qui ne voient jamais la facture : taille du modèle, longueur du contexte, nombre de tours d’un agent, fréquence de réentraînement. Un changement de prompt système de trois paragraphes peut déplacer la dépense d’inférence plus sûrement qu’un trimestre de négociation tarifaire.
Le compromis central est celui-ci : la vitesse d’expérimentation contre la prévisibilité de la dépense. Bloquer chaque essai derrière une validation budgétaire tue l’itération. Laisser l’expérimentation sans plafond produit la surprise de fin de mois, cette tradition du secteur.
La recommandation tranchée tient en trois points :
- l’unité de pilotage est le coût unitaire (par requête, par millier de résultats exploitables, par entraînement), jamais la dépense totale, qui monte dès que le produit marche ;
- le contrôle se fait à la promotion d’une version de modèle, dans le pipeline CI/CD (Continuous Integration / Continuous Delivery), au même titre que les tests de qualité ;
- l’expérimentation reçoit une enveloppe plafonnée par quota technique, pas par processus d’approbation.
Condition de validité : cette approche suppose un comptage par identité et par version. Sans lui, mieux vaut commencer par les prérequis que par les tableaux de bord.
Prérequis : attribuer le coût par identité et par version de modèle
Section intitulée « Prérequis : attribuer le coût par identité et par version de modèle »Les étiquettes posées sur les ressources cloud ne suffisent pas en IA, pour deux raisons mécaniques. Un GPU (Graphics Processing Unit) partagé entre plusieurs équipes porte une seule étiquette. Un appel à une API (Application Programming Interface) de modèle hébergé n’est pas une ressource : c’est une ligne de consommation rattachée à une clé, et une clé partagée entre trois services donne une facture en un seul bloc.
Ce qui doit exister avant tout le reste :
- une identité par charge de travail, sans secret statique quand la plateforme le permet (voir la fédération d’identité de charge de travail) ;
- une clé ou un jeton par usage auprès de chaque fournisseur de modèle, jamais une clé d’équipe (voir la gestion des clés d’API des fournisseurs d’IA) ;
- un point de passage unique pour l’inférence, une passerelle qui compte les jetons d’entrée et de sortie, la durée, l’identité appelante et l’identifiant de version du modèle ;
- un registre de modèles où chaque version porte un identifiant immuable, repris dans chaque enregistrement de comptage ;
- une grille de prix versionnée (tarif par jeton, coût horaire par type de GPU), car le fournisseur change ses tarifs sans prévenir le pipeline ;
- l’export détaillé de facturation du fournisseur cloud, pour réconcilier le compté et le facturé.
Le schéma montre où se forme la donnée de coût : à la passerelle et à l’ordonnanceur, pas dans la facture.
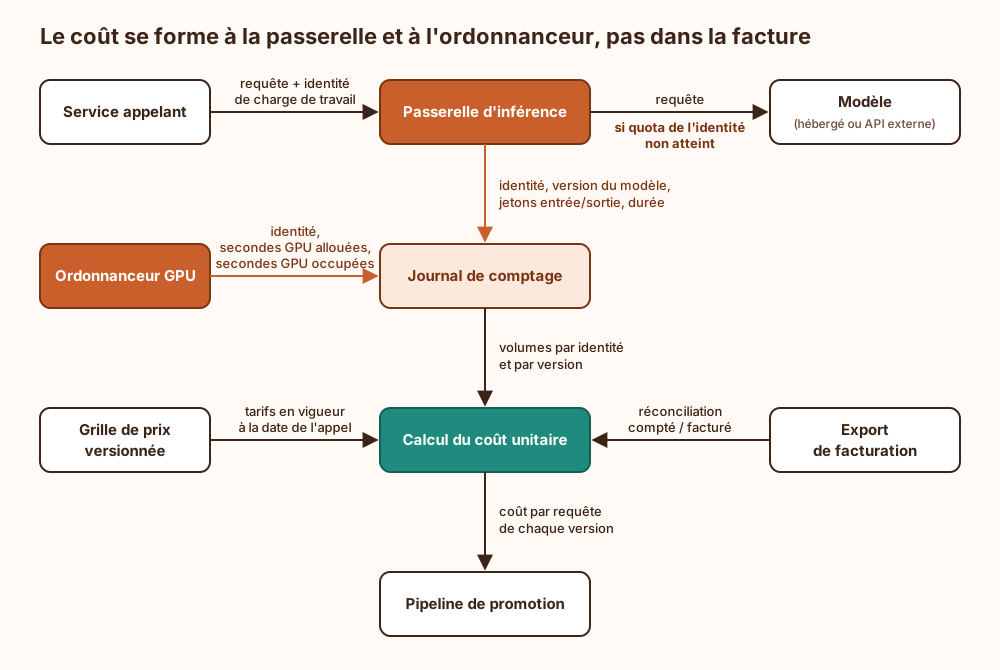
Sur Kubernetes, un piège précis : une demande nvidia.com/gpu: 1 alloue la carte entière au conteneur, qu’il l’occupe à 5 % ou à 95 %. Le partage par tranches de temps (time-slicing) améliore le remplissage mais n’isole pas la mémoire entre charges ; le découpage matériel MIG (Multi-Instance GPU) isole, sur les cartes qui le prennent en charge. Dans les deux cas, il faut compter séparément le temps alloué et le temps occupé : l’écart entre les deux est le premier gisement d’économie, et il est invisible dans la facture.
Postes de coût en IA : entraînement, inférence, jetons et stockage
Section intitulée « Postes de coût en IA : entraînement, inférence, jetons et stockage »Chaque poste a son levier et son piège, et les confondre mène à optimiser le mauvais.
Entraînement et ajustement. Dépense en rafales, tolérante à l’interruption. Les instances préemptibles divisent le prix, à condition d’écrire des points de reprise réguliers : sans eux, une préemption à 90 % du calcul facture 90 % pour rien. Le piège est la recherche d’hyperparamètres lancée sans borne de parallélisme, qui multiplie la dépense par le nombre d’essais avec une constance admirable.
Inférence auto-hébergée. Dépense continue, dominée par le taux d’occupation. Un GPU allumé coûte le même prix à vide. La mise à l’échelle sur la charge CPU (Central Processing Unit) ne reflète rien de ce qui se passe sur la carte : il faut piloter sur la file d’attente ou le débit de jetons. La réduction à zéro instance coûte un démarrage à froid qui inclut le chargement des poids en mémoire, souvent compté en minutes ; elle convient aux usages par lots, rarement à l’interactif.
Inférence par API. Pour un LLM (Large Language Model), les jetons de sortie sont en général facturés plus cher que ceux d’entrée, et un agent renvoie tout l’historique à chaque tour : le volume d’entrée cumulé croît donc comme le carré du nombre de tours. Le cache de prompt réduit ce coût, mais il repose sur un préfixe identique à l’octet près : un horodatage inséré en tête de prompt système l’annule entièrement, sans la moindre erreur dans les journaux.
RAG (Retrieval-Augmented Generation). Changer de modèle d’embeddings impose de recalculer tout le corpus, les vecteurs de deux modèles n’étant pas comparables. Ce coût de migration doit figurer dans la décision, pas dans le post-mortem.
Le reste, qu’on oublie. Points de reprise et artefacts conservés sans politique de rétention, évaluations automatiques qui appellent elles-mêmes un modèle juge à chaque exécution du pipeline, journaux de prompts stockés en entier, trafic sortant entre régions. Les leviers d’optimisation proprement dits sont détaillés dans l’optimisation du coût de déploiement des LLM à l’échelle.
Sur les engagements de capacité réservée : ils valent pour une charge d’inférence stable sur un matériel donné. Les prendre sur une génération de GPU alors que le modèle servi change tous les six mois revient à s’abonner à un journal dont on ne lit plus la langue.
Exemple : barrière de coût unitaire à la promotion d’un modèle
Section intitulée « Exemple : barrière de coût unitaire à la promotion d’un modèle »La logique ci-dessous s’insère dans le pipeline de promotion, après les tests de qualité. Elle rejoue un jeu de requêtes de référence figé sur la version candidate, mesure le coût par requête avec la grille de prix courante, et compare à la version en service.
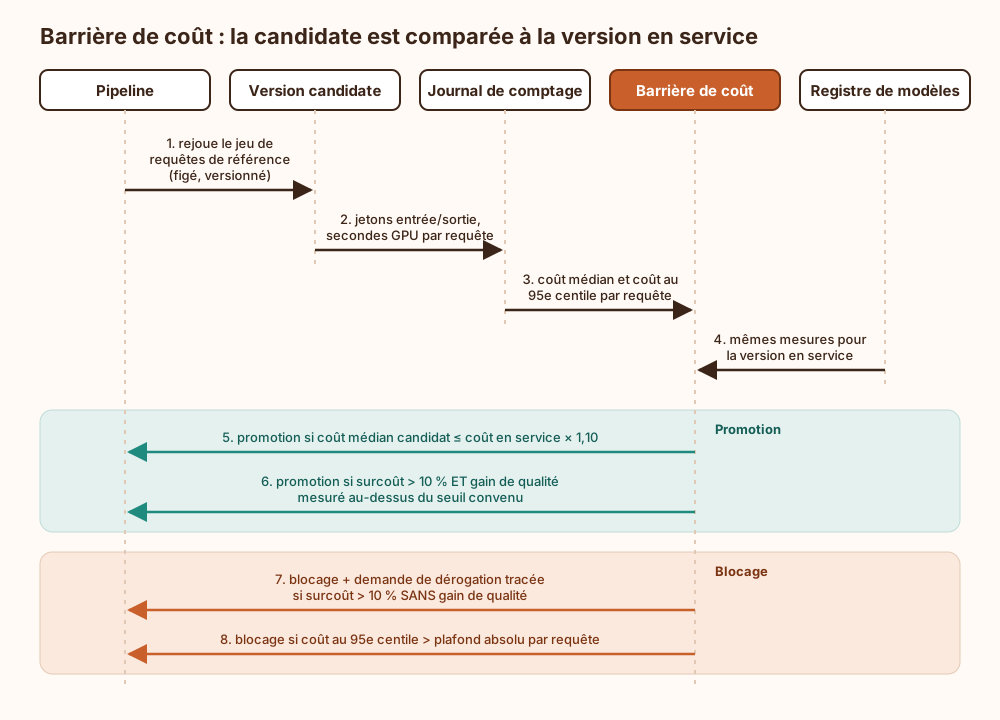
Trois choix à lire dans ce schéma. Le seuil est relatif à la version en service, ce qui évite de fixer un chiffre absolu que personne ne sait justifier. Le surcoût reste autorisé s’il achète de la qualité mesurée : la barrière arbitre un rapport, elle n’interdit pas de dépenser. Le plafond absolu porte sur le 95e centile, parce que la médiane masque les requêtes pathologiques (contexte saturé, boucle d’agent) qui font la facture. La valeur de 10 % est un point de départ à ajuster ; ce qui compte est qu’une dérogation laisse une trace et un nom.
Surface d’attaque du pilotage des coûts en IA
Section intitulée « Surface d’attaque du pilotage des coûts en IA »Un système qui transforme des requêtes en argent dépensé est une cible, et son dispositif de contrôle aussi.
Épuisement de budget. Un attaquant, ou un client mal codé, sature un point d’entrée avec des requêtes qui maximisent les jetons de sortie. Contre-mesure : quotas par identité à la passerelle, plafond de jetons de sortie par requête, limite du nombre de tours d’un agent. Le mécanisme est traité dans le denial of wallet sur les API d’IA.
Vol de clé de fournisseur. Une clé d’API de modèle se revend et se consomme à distance sans toucher à l’infrastructure de la victime. Contre-mesure : clé par usage, plafond de dépense par clé côté fournisseur, alerte sur le débit et non sur le total mensuel.
Détournement de GPU. Un pipeline d’entraînement compromis offre exactement le matériel recherché pour du calcul parasite. Contre-mesure : quotas de ressources par espace de noms, durée maximale par tâche, alerte sur l’occupation GPU hors fenêtre de tâche déclarée (voir les quotas et la limitation des ressources cloud).
Le coupe-circuit retourné contre le service. Un plafond global qui coupe l’inférence quand le budget est atteint donne à l’attaquant un interrupteur : il suffit de consommer pour éteindre. Contre-mesure : budgets cloisonnés par identité, production séparée de l’expérimentation, et dégradation (modèle plus petit, sortie plus courte, file d’attente) plutôt que coupure.
Fuite par les données de comptage. Les volumes par client et par fonctionnalité révèlent l’activité commerciale ; les journaux de prompts conservés pour expliquer un coût contiennent des données personnelles et parfois des secrets. Contre-mesure : compter les jetons sans stocker le contenu, et traiter le journal de comptage comme une donnée sensible avec son propre contrôle d’accès.
Fraude à l’attribution. Quand l’étiquette est déclarative, la retirer suffit à disparaître des rapports. L’attribution doit venir de l’identité authentifiée, que l’appelant ne choisit pas.
Ce que le couple FinOps et MLOps ne garantit pas
Section intitulée « Ce que le couple FinOps et MLOps ne garantit pas »Il ne garantit pas la qualité. Un coût unitaire en baisse signale aussi bien une optimisation qu’un modèle qui répond moins bien et plus court. La barrière de coût n’a de sens qu’adossée à des évaluations (voir les évaluations de LLM) ; sans elles, on optimise vers le silence, qui est gratuit.
Il ne garantit pas l’arrêt de la dépense. Les budgets natifs des fournisseurs cloud alertent, ils ne coupent pas, et les données de facturation arrivent avec plusieurs heures de retard, parfois davantage. Le seul plafond qui agit en minutes est le quota technique à la passerelle et à l’ordonnanceur.
Il ne garantit ni la sécurité ni la conformité du modèle : un modèle économe peut fuir des données avec une sobriété exemplaire. Il ne protège pas non plus d’un changement de tarif ou de retrait d’un modèle par le fournisseur ; cela relève du contrat et de la capacité à basculer, donc de l’architecture.
Exploitation : quotas, rotation des clés, supervision et reprise
Section intitulée « Exploitation : quotas, rotation des clés, supervision et reprise »Secrets et rotation. Les clés de fournisseur sont émises par usage, stockées dans un coffre, et tournées selon un calendrier ; la rotation est aussi le moment de vérifier que chaque clé a encore un propriétaire. Une clé sans consommation depuis un cycle se révoque.
Supervision. Quatre séries suffisent pour commencer : coût par requête par version de modèle, écart entre secondes GPU allouées et occupées, jetons par requête au 95e centile, taux de succès du cache de prompt. Les alertes portent sur la pente (débit de dépense par identité sur quelques minutes), avec un SLO (Service Level Objective) de coût unitaire par service. La page sur l’observabilité des LLM en production couvre l’instrumentation.
Panne de la passerelle de comptage. La question se décide avant l’incident. Pour l’expérimentation : échec fermé, rien ne passe sans comptage. Pour la production : poursuite du service avec des quotas locaux en mémoire et un comptage rattrapé ensuite par réconciliation avec la facture.
Sauvegarde et reprise. Le registre de modèles, la grille de prix versionnée et le jeu de requêtes de référence sont à sauvegarder ensemble : sans les trois, aucune comparaison de coût entre versions n’est reproductible. Le journal de comptage se conserve au moins le temps de contester une facture.
Revue. La réconciliation compté contre facturé se fait à chaque cycle de facturation. Un écart persistant désigne presque toujours un chemin d’appel qui contourne la passerelle, ce qui est aussi un problème de sécurité.
Faut-il refacturer les équipes ou seulement leur montrer leur consommation ?
Section intitulée « Faut-il refacturer les équipes ou seulement leur montrer leur consommation ? »Montrer d’abord. La refacturation interne suppose une attribution que personne ne conteste, donc un comptage par identité déjà fiable et réconcilié. Refacturer sur des clés partagées ou des étiquettes déclaratives produit des litiges internes, pas des économies.
Auto-héberger le modèle ou consommer une API : de quoi dépend le choix ?
Section intitulée « Auto-héberger le modèle ou consommer une API : de quoi dépend le choix ? »Du taux d’occupation atteignable et de sa stabilité. Une API facture à l’usage et absorbe les creux ; un GPU auto-hébergé ne devient moins cher qu’au-delà d’un remplissage soutenu, en comptant l’exploitation humaine. Le dimensionnement est traité dans le matériel pour l’inférence de LLM. Les contraintes de confidentialité peuvent trancher avant le calcul économique.
🐝 Ce qui arrive si on s’en passe
Section intitulée « 🐝 Ce qui arrive si on s’en passe »Sans comptage par identité ni contrôle à la promotion, une version de modèle deux fois plus chère par requête part en production sans que personne ne l’ait décidé, et l’écart n’apparaît qu’à la facture, agrégé avec tout le reste. Une clé volée ou un pipeline détourné vers du calcul parasite se confond avec la croissance normale de l’usage, faute de ligne de base par appelant. Les GPU alloués et inoccupés restent facturés indéfiniment, puisque rien ne mesure l’écart. Et le jour où un plafond global finit par être posé dans l’urgence, il devient un interrupteur que n’importe quel gros consommateur, légitime ou non, peut actionner contre le service.
🦫 Explication de la marmotte 🍫
Section intitulée « 🦫 Explication de la marmotte 🍫 »Un programme d’intelligence artificielle coûte de l’argent à deux moments : quand on le fabrique à partir d’exemples, et à chaque fois qu’il répond à une question. Le second poste dure tant que le service existe, et finit souvent par peser le plus lourd. Pour le maîtriser, il faut d’abord savoir qui consomme quoi. Chaque équipe et chaque service reçoit donc sa propre identité, et un point de passage unique compte tout ce qui est demandé au programme, en notant l’identité de l’appelant et la version utilisée. Ces comptes sont ensuite multipliés par une grille de prix pour obtenir le coût d’une réponse. Ce coût est vérifié avant chaque mise en service d’une nouvelle version : si la réponse devient trop chère sans devenir meilleure, la version est refusée. Des plafonds par identité bloquent les dépassements en quelques minutes, car la facture officielle arrive avec des heures de retard. Quand le comptage tombe en panne, les essais s’arrêtent et le service principal continue avec des plafonds locaux. Rien de tout cela ne dit si les réponses sont bonnes : des tests de qualité séparés restent nécessaires. Et un plafond mal réglé peut servir à un attaquant pour faire couper le service.
À lire aussi
- Comment fonctionne l'inférence d'un modèle de langagePréremplissage, décodage, cache de clés et valeurs, batching et surface d'attaque d'un serveur d'inférence, avec les compromis de latence et de débit à trancher avant la mise en production.
- Fenêtre de contexte et mémoire d’un LLM localChoisir, dimensionner et exploiter la fenêtre de contexte d’un LLM local sans sacrifier inutilement la performance, la sécurité ou la continuité des conversations.
- Apprentissage automatique et réseaux de neurones, attaques du modèleComment un réseau de neurones apprend à partir de données (poids, perte, descente de gradient, rétropropagation) et où se placent l'empoisonnement, l'évasion, l'extraction et l'inversion sur le cycle de vie du modèle.
- Fine-tuning en IA, définition, usages et limitesCe qu'est le fine-tuning d'un modèle d'IA, à quoi il sert vraiment, ce qu'il ne garantit pas, sa surface d'attaque et ses conditions d'exploitation.
Pages voisines
La citent
Relier FinOps et MLOps pour piloter le coût de l'IA en production
Elle cite
- Lien dans les deux sens :Calculer le coût d’un LLM local à grande échelle
- Comment observer un LLM en production
- Denial of wallet sur une application adossée à une API d'IA
- Dimensionner GPU et RAM pour un LLM local
- Evals LLM comment mesurer qu'un assistant IA répond juste
- Sécuriser les clés d'API des fournisseurs d'IA générative
- Mettre en place la fédération d’identité de charge
- Quotas cloud contre le déni de service par coût
: les deux pages se citent l’une l’autre.