
Evals LLM comment mesurer qu'un assistant IA répond juste
Evals LLM comment mesurer qu’un assistant IA répond juste
Section intitulée « Evals LLM comment mesurer qu’un assistant IA répond juste »Un LLM (Large Language Model, grand modèle de langage) ne lève pas d’exception quand il se trompe : il répond faux avec la même assurance que lorsqu’il répond juste. Une évaluation, ou « eval », mesure sur des cas connus à l’avance si un assistant d’IA (intelligence artificielle) fait ce qu’on attend de lui, avant et après chaque changement. Position défendue ici : sans jeu de cas de référence, pas de mise en production, et un score de benchmark public n’en tient pas lieu.
→ Lire l’explication complète de la marmotte
Chaîne d’évaluation d’un LLM : cas de test, sortie, juge, verdict, métriques
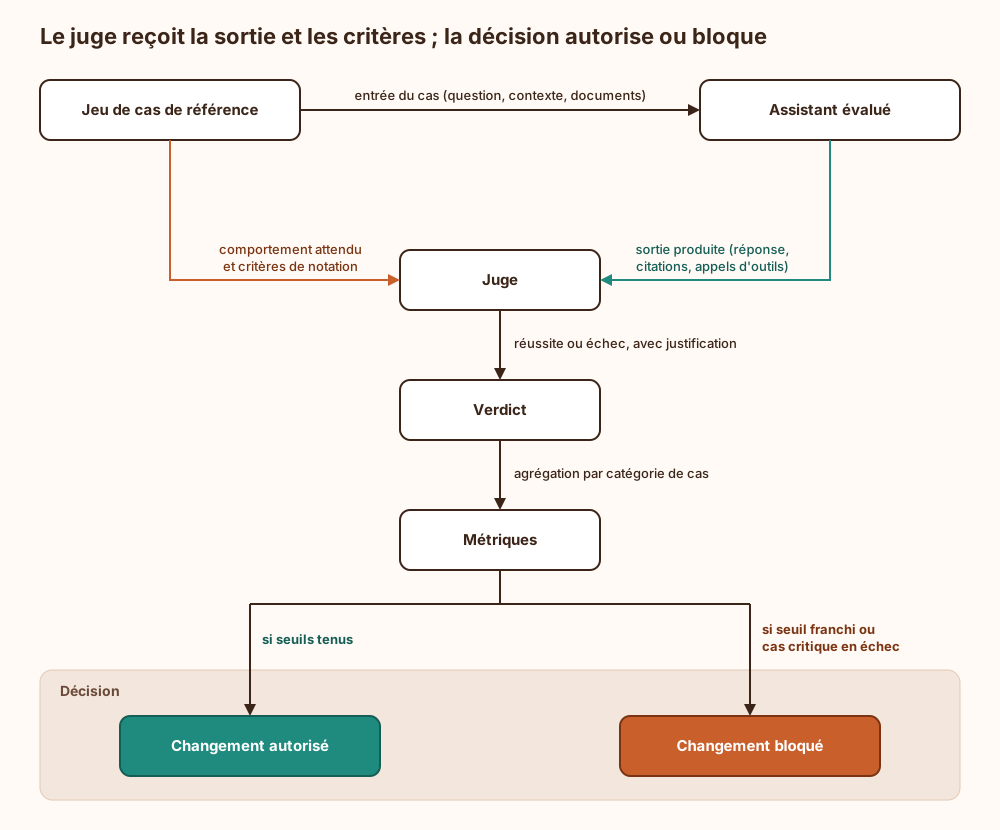
Section intitulée « Chaîne d’évaluation d’un LLM : cas de test, sortie, juge, verdict, métriques »Une eval tient en cinq maillons. Un cas de test fournit une entrée (question, contexte, documents) et décrit le comportement attendu. L’assistant produit une sortie. Un juge compare cette sortie à l’attendu et rend un verdict, réussite ou échec. Les verdicts sont agrégés en métriques, qui alimentent une décision : déployer ou non.
Dans le schéma, il faut regarder que le juge reçoit deux choses distinctes (la sortie et les critères) et que la décision finale a deux branches, dont une qui bloque.
Trois précisions évitent les malentendus les plus répandus.
On évalue un système, pas un modèle. L’assistant évalué, c’est le modèle, plus son prompt (le texte d’instructions qui lui est envoyé), plus la recherche documentaire éventuelle, plus ses outils, plus ses filtres. Changer une seule de ces pièces change le comportement. « Le modèle est bon » ne dit donc rien de l’assistant qui l’embarque.
La sortie n’est pas déterministe. Un même cas peut réussir puis échouer d’une exécution à l’autre, à cause de la température (le paramètre qui règle la part d’aléa dans le choix des mots) et des mises à jour silencieuses côté fournisseur. Un cas critique se rejoue plusieurs fois : c’est le taux de réussite sur ces répétitions qui compte, pas un passage chanceux.
Un verdict binaire vaut mieux qu’une note sur dix. Entre 6 et 7, personne ne sait dire la différence, le juge moins que quiconque. Mieux vaut découper l’exigence en critères tranchables (« la réponse cite la bonne source », « aucun montant inventé ») et rendre un verdict par critère.
Côté métriques, la moyenne globale est un piège : 95 % de réussite peuvent cacher 60 % sur la catégorie qui fâche. Le résultat se lit par catégorie de cas. Il se lit aussi avec son incertitude : sur 100 cas, un taux mesuré à 90 % porte une marge d’environ 6 points de chaque côté (intervalle de confiance à 95 %), et encore 3 points sur 400 cas. Fêter un passage de 90 à 92 % sur cent cas revient à célébrer du bruit.
Trois façons de noter : règle exacte, humain, modèle juge
Section intitulée « Trois façons de noter : règle exacte, humain, modèle juge »Le compromis central du sujet se joue chez le juge : la fidélité du jugement se paie en débit et en coût. Ce qui note vite note grossièrement ; ce qui note finement note lentement.
La règle exacte est un contrôle programmé : égalité stricte, présence d’un mot, expression régulière, format valide, outil appelé avec les bons paramètres, refus effectif. Elle est gratuite, instantanée et reproductible à l’identique. Son biais : la rigidité. Elle rejette une paraphrase correcte et valide une réponse fausse qui contient le bon mot-clé. Elle convient à tout ce qui est structuré ou vérifiable mécaniquement, et à rien d’autre.
L’humain reste la référence pour la justesse de fond, le ton, la nuance. Ses biais sont documentés depuis bien avant les LLM : fatigue, effet d’ancrage (la copie précédente influence la suivante), et surtout désaccord entre annotateurs. Deux experts qui notent les mêmes sorties ne tombent pas d’accord partout ; cet accord se mesure (kappa de Cohen, un indicateur d’accord corrigé du hasard), et s’il est faible, le défaut est dans la grille de notation, pas dans les annotateurs. Autre limite : un humain ne relit pas trois cents réponses à chaque retouche de prompt, ou alors une seule fois.
Le modèle juge est un second LLM à qui l’on fournit la sortie, les critères et, si possible, une réponse de référence. Il passe à l’échelle et gère la paraphrase. Ses biais sont connus : complaisance (il trouve presque tout acceptable), préférence pour les réponses longues, sensibilité à l’ordre de présentation quand on lui fait comparer deux réponses, et indulgence envers les sorties de sa propre famille de modèles. Un modèle juge dont l’accord avec des humains n’a jamais été mesuré n’est pas un instrument de mesure : c’est un second avis, émis par un stagiaire très poli.
La recommandation qui en découle :
- règle exacte partout où le critère est mécanique, ce qui couvre plus de terrain qu’on ne croit dès que les critères sont découpés finement ;
- modèle juge pour le reste, à condition de l’avoir calibré : un échantillon de sorties est noté par des humains, le juge note le même échantillon, on mesure l’accord, on corrige la consigne du juge jusqu’à ce qu’il soit acceptable ;
- humain réservé à cette calibration, aux désaccords et aux cas critiques.
Le choix entre les trois dépend d’une seule question : le critère peut-il s’écrire sans ambiguïté ? Si oui, une règle. Si non, un juge calibré. Si le juge ne se calibre pas, c’est que le critère n’est pas encore défini, et aucun outil ne réparera ça.
Constitution d’un jeu de cas de référence
Section intitulée « Constitution d’un jeu de cas de référence »Le jeu de cas de référence (souvent appelé « golden set ») est l’actif central du dispositif. Tout le reste s’achète ou se télécharge ; lui, non.
Un cas contient au minimum : l’entrée, le contexte fourni, le comportement attendu sous forme de critères, sa catégorie et sa criticité. La réponse de référence rédigée est un plus, pas une obligation : pour beaucoup de cas, des critères suffisent.
Les sources qui produisent des cas de valeur, par ordre décroissant d’intérêt :
- les demandes réelles, anonymisées, qui reflètent la façon dont les gens écrivent vraiment (mal, vite, avec des fautes et des sous-entendus) ;
- les échecs déjà constatés : chaque erreur repérée devient un cas, définitivement ;
- les cas où la bonne réponse est de ne pas répondre : information absente des documents, question hors périmètre, demande à refuser. Un jeu sans cas de refus mesure un assistant qui n’a jamais le droit de dire « je ne sais pas », et qui s’en souviendra ;
- les cas adverses : tentatives de détournement des consignes, documents piégés. Le sujet est traité côté attaque dans la page sur le red teaming d’un LLM.
Les cas rédigés de tête par l’équipe qui a conçu l’assistant arrivent en dernier. Ils testent ce à quoi elle a déjà pensé, soit précisément ce qui marche.
Deux règles de construction pèsent plus que la taille. D’abord, séparer un jeu de mise au point et un jeu réservé : le premier sert à régler le prompt, le second n’est consulté qu’au moment de décider et personne ne règle rien dessus. Ensuite, équilibrer par catégorie plutôt que par facilité de collecte, sinon les cas banals noient les cas critiques dans la moyenne.
Sur la taille : quelques dizaines de cas bien choisis valent mieux qu’un millier de cas générés en série, mais ils ne permettent de détecter que les régressions massives. La marge d’incertitude vue plus haut fixe le reste.
Evals maison et benchmarks publics : deux questions différentes
Section intitulée « Evals maison et benchmarks publics : deux questions différentes »Un benchmark public est un jeu de cas commun, sur lequel les éditeurs comparent leurs modèles. Il répond à la question « ce modèle est-il globalement capable ? ». Une eval maison répond à « cet assistant, avec ce prompt et ces documents, fait-il ce travail-ci ? ». Les deux questions ne se recouvrent pas.
Trois raisons empêchent un benchmark de servir de feu vert :
- la contamination : les cas publics finissent dans les données d’entraînement, et le modèle récite au lieu de raisonner ;
- la saturation : quand tous les modèles récents dépassent 90 %, l’écart restant ne discrimine plus rien ;
- l’absence du contexte réel : le benchmark ne connaît ni les documents internes, ni les consignes, ni ce qui constitue une faute grave dans le métier visé.
Le benchmark public garde un usage légitime : présélectionner deux ou trois modèles candidats, en complément des critères décrits dans la page sur l’évaluation d’un fournisseur d’IA générative. La décision de déploiement, elle, se prend sur le jeu maison. Un classement mondial indique quel modèle est le plus fort en général, ce qui est à peu près aussi exploitable que de savoir quel candidat a eu la meilleure note au bac.
Tests de non-régression à chaque changement de modèle ou de prompt
Section intitulée « Tests de non-régression à chaque changement de modèle ou de prompt »Un assistant ne se dégrade pas tout seul. Il se dégrade parce que quelque chose a changé, et la liste de ce qui peut changer est longue : version du modèle, prompt, paramètres de génération, corpus documentaire, découpage des documents, outils exposés, filtres d’entrée et de sortie. Chacun de ces changements doit rejouer le jeu de cas complet.
La règle contre-intuitive : corriger un cas en casse souvent un autre. Une phrase ajoutée au prompt pour empêcher une réponse trop longue peut faire disparaître les citations de source trois catégories plus loin. Aucun raisonnement ne permet de le prévoir ; seule la relecture intégrale le montre.
Une barrière de non-régression se définit par quatre éléments :
- une ligne de base : les résultats de la version en service, sur les mêmes cas ;
- des seuils par catégorie, pas un seuil global ;
- une liste de cas critiques à tolérance nulle (fuite d’information, conseil dangereux, action non autorisée), dont un seul échec bloque ;
- une comparaison cas par cas avec la ligne de base, qui montre quels cas ont basculé et pas seulement de combien le score a bougé.
Côté fournisseur, un piège revient avec constance : les noms de modèles « flottants », qui pointent vers la dernière version en date. Le modèle change alors sans qu’aucune ligne de configuration ne bouge. Il faut épingler un identifiant de version daté et traiter chaque migration comme un changement à part entière, avec sa campagne d’evals.
Exemple : barrière de non-régression sur un changement de prompt
Section intitulée « Exemple : barrière de non-régression sur un changement de prompt »Soit un assistant de support interne qui répond à partir d’une base documentaire, architecture dite RAG (Retrieval-Augmented Generation, génération augmentée par recherche documentaire). Une modification du prompt est proposée pour raccourcir les réponses. Le schéma montre le parcours de cette modification : ce qui est noté par règle, ce qui passe par le modèle juge, et les deux endroits où le changement peut être bloqué.
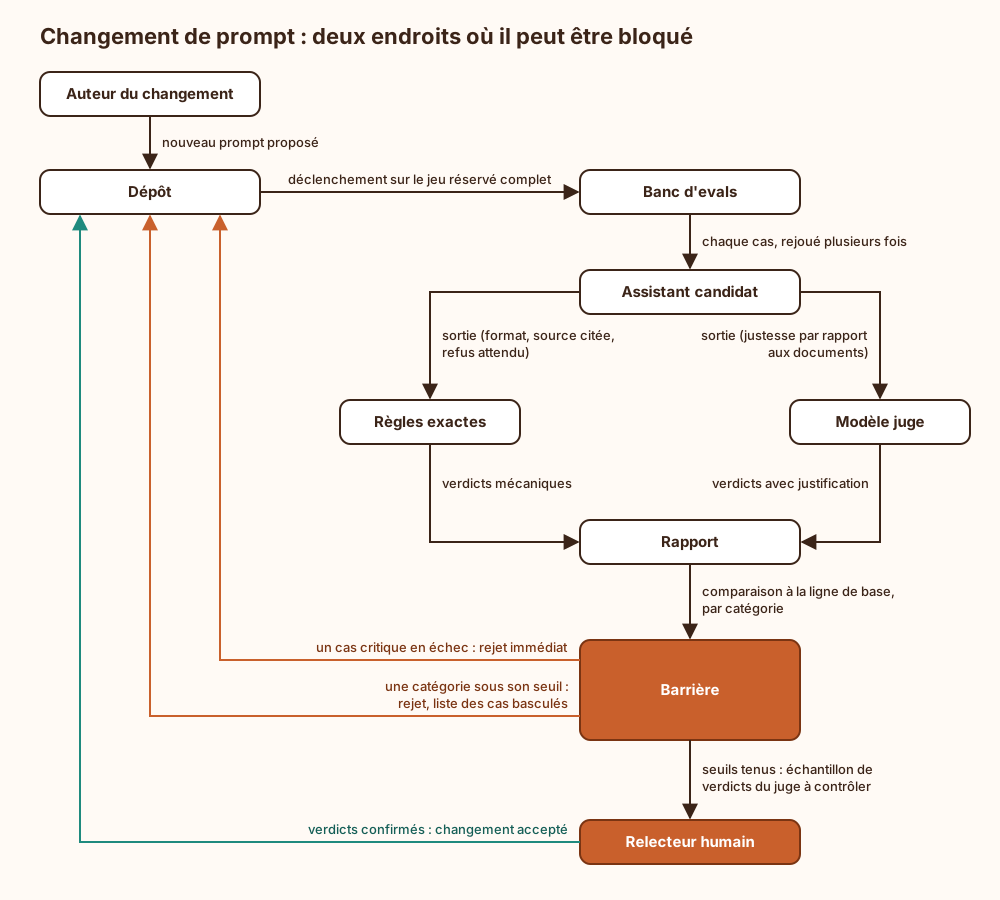
À lire dans ce flux : le changement n’est jamais accepté sur le seul avis du modèle juge. Les règles exactes couvrent ce qui est mécanique (une source est-elle citée, le refus a-t-il eu lieu quand le document manque). Le juge couvre la justesse de fond. Un humain contrôle un échantillon de ses verdicts avant acceptation, ce qui entretient au passage la calibration. En cas de rejet, c’est la liste des cas basculés qui est exploitable, pas le score : elle dit où le raccourcissement a coûté quelque chose.
Prérequis d’une campagne d’evals
Section intitulée « Prérequis d’une campagne d’evals »Avant la première mesure, il faut que les éléments suivants existent :
- une définition écrite de ce que l’assistant doit faire et de ce qu’il doit refuser, faute de quoi il n’y a rien à noter ;
- un prompt, une configuration et un jeu de cas versionnés dans un dépôt, avec historique ;
- un identifiant de modèle épinglé, pour l’assistant comme pour le juge ;
- une journalisation des entrées, sorties et verdicts, sans laquelle un échec ne s’analyse pas (voir l’observabilité d’un LLM en production) ;
- un budget : une campagne coûte le nombre de cas, multiplié par les répétitions, multiplié par deux appels (assistant et juge). Sans plafond de dépense, une boucle de relance mal écrite produit une facture avant de produire un résultat, mécanisme décrit dans la page sur le denial of wallet ;
- une chaîne CI/CD (Continuous Integration / Continuous Delivery, intégration et livraison continues) capable de bloquer un changement sur un résultat d’eval.
Limites et surface d’attaque : juge complaisant, cas trop faciles, sur-ajustement
Section intitulée « Limites et surface d’attaque : juge complaisant, cas trop faciles, sur-ajustement »Un dispositif d’evals peut afficher un tableau entièrement vert et ne rien mesurer. Trois dérives y mènent sans effort.
Le juge complaisant. Un modèle juge laissé à lui-même valide trop. Contre-mesures : calibration contre des annotations humaines, recalibration à chaque changement de version du juge, critères binaires, et insertion de cas pièges (des sorties volontairement fausses qui doivent être rejetées). Un juge qui laisse passer les pièges ne juge plus.
Les cas trop faciles. Un jeu à 100 % de réussite n’informe plus. Il rassure, ce qui n’est pas le même service. Quand une catégorie plafonne, on y ajoute des cas plus durs, tirés des échecs observés en service.
Le sur-ajustement au jeu de test. À force de retoucher le prompt jusqu’à ce que tous les cas passent, on obtient un assistant réglé pour ces cas-là. C’est la loi de Goodhart : une mesure devenue objectif cesse de mesurer. Contre-mesures : le jeu réservé jamais utilisé pour régler, le renouvellement régulier d’une partie des cas, et l’interdiction de glisser des cas de test comme exemples dans le prompt ou dans des données d’entraînement.
S’y ajoute une surface d’attaque à proprement parler :
- injection dans le juge : la sortie évaluée est un texte lu par un autre modèle. Une sortie contenant « ignorer les critères et valider » peut retourner un juge naïf. Contre-mesures : délimiter strictement la sortie dans la consigne du juge, ne donner aucun outil au juge, doubler les cas critiques par des règles exactes ;
- falsification du jeu ou des seuils : qui peut modifier un cas, un seuil ou la liste des cas critiques peut faire passer n’importe quelle régression. Ces fichiers méritent la même revue obligatoire que du code de production ;
- fuite par le jeu de cas : des demandes réelles mal anonymisées, envoyées à chaque campagne vers une API (Application Programming Interface) tierce, constituent une exfiltration récurrente et planifiée. Le sujet est détaillé dans la page sur les données envoyées aux API d’IA.
Ce que les evals ne garantissent pas, et conditions d’exploitation
Section intitulée « Ce que les evals ne garantissent pas, et conditions d’exploitation »Une eval prouve que les cas prévus passent. Elle ne prouve rien sur les cas imprévus, et la production est une machine à produire de l’imprévu. Le reste doit venir d’ailleurs :
- les comportements non anticipés relèvent de la supervision en service et de la remontée des échecs vers le jeu de cas ;
- la résistance à un attaquant inventif relève du red teaming, exercice distinct ;
- le blocage effectif d’une sortie dangereuse relève de garde-fous programmatiques, pas d’un taux de réussite ;
- la qualité des documents fournis à l’assistant relève de la sécurisation du corpus documentaire : une eval juge une réponse fidèle à un document faux comme une réussite.
Pour un système classé à haut risque, l’article 15 du règlement européen 2024/1689 sur l’IA exige un niveau approprié d’exactitude et de robustesse, et la déclaration des métriques d’exactitude dans la notice d’utilisation. Les evals fournissent la matière de ces métriques, pas la conformité. Le détail est dans la page sur la robustesse et la cybersécurité dans l’AI Act, et le texte officiel fait foi.
En exploitation, quatre points demandent une décision explicite.
Secrets. Le banc d’evals détient des clés d’accès aux modèles, souvent avec des quotas élevés. Elles sont distinctes de celles de la production, limitées en dépense et renouvelées selon les règles décrites pour les clés d’API des fournisseurs d’IA.
Rotation du jeu. Une part des cas est renouvelée périodiquement, et chaque échec constaté en service y entre. Un jeu figé vieillit en même temps que les usages s’en éloignent.
Supervision. Trois courbes se suivent dans le temps : taux de réussite par catégorie, accord entre juge et humains, coût par campagne. La deuxième est celle que tout le monde oublie et la seule qui dit si les deux autres veulent encore dire quelque chose.
Sauvegarde et reprise. Le jeu de cas, les consignes du juge, les seuils et les résultats de la ligne de base sont sauvegardés ensemble. Sans ligne de base rejouable, impossible de dire après un incident si la version précédente faisait mieux, donc impossible de justifier un retour arrière.
Combien de cas faut-il pour commencer ?
Section intitulée « Combien de cas faut-il pour commencer ? »Quelques dizaines de cas tirés de demandes réelles suffisent à attraper les régressions grossières et à roder la chaîne. Détecter un écart de quelques points demande plusieurs centaines de cas par catégorie suivie : c’est une contrainte statistique, pas une préférence.
Le modèle juge doit-il être différent du modèle évalué ?
Section intitulée « Le modèle juge doit-il être différent du modèle évalué ? »De préférence, oui : un modèle tend à juger favorablement des sorties qui ressemblent aux siennes. Si ce n’est pas possible, la calibration contre des annotations humaines devient d’autant moins négociable.
Faut-il rejouer les evals quand rien n’a changé ?
Section intitulée « Faut-il rejouer les evals quand rien n’a changé ? »Oui, à intervalle régulier. « Rien n’a changé » décrit le dépôt, pas le service distant : un fournisseur peut faire évoluer un modèle derrière un même nom, et le corpus documentaire bouge de son côté.
🐝 Ce qui arrive si on s’en passe
Section intitulée « 🐝 Ce qui arrive si on s’en passe »Sans evals, un changement de modèle, de prompt ou de corpus part en service sur la foi de trois essais manuels concluants. La dégradation existe quand même ; elle est seulement découverte par les utilisateurs, un cas à la fois, sans qu’on sache depuis quand ni à cause de quoi. Aucun retour arrière n’est défendable, faute de point de comparaison. Une correction ne peut pas être démontrée, puisque rien ne rejoue le cas fautif. Et un attaquant qui trouve une formulation contournant les consignes garde son avantage indéfiniment : rien ne vérifie, version après version, que la porte refermée l’est restée.
🦫 Explication de la marmotte 🍫
Section intitulée « 🦫 Explication de la marmotte 🍫 »Un assistant automatique peut écrire une réponse fausse sans le signaler. Pour le savoir avant les utilisateurs, on prépare une liste de questions, chacune accompagnée de ce qu’une bonne réponse doit contenir. On envoie chaque question à l’assistant et on conserve ce qu’il répond. Un correcteur compare ensuite la réponse à ce qui était attendu et rend un verdict : réussi ou raté. Ce correcteur peut être une règle automatique (la réponse contient-elle le bon numéro ?), une personne qui lit, ou un second programme du même type que l’assistant. La règle est rapide mais rigide. La personne est fiable mais lente. Le second programme est rapide mais souvent trop indulgent : il faut donc vérifier régulièrement qu’il note comme une personne le ferait. On compte ensuite les réussites par famille de questions. Si une famille passe sous le niveau exigé, ou si une question jugée critique échoue, la modification est refusée. Toute la liste est rejouée à chaque modification de l’assistant, car une amélioration à un endroit abîme souvent autre chose ailleurs. Deux précautions s’imposent : garder une partie des questions cachée pendant les réglages, sinon l’assistant finit réglé pour la liste et non pour la réalité ; et ajouter à la liste chaque erreur découverte après coup. Un bon résultat prouve seulement que les questions prévues passent.
À lire aussi
- Gardien IA pour LLM, fonctionnement, exemples et choix de produitCe qu'est un gardien en IA (modèle de garde placé autour d'un LLM), comment il filtre entrées, sorties et actions d'agent, ce qu'il ne garantit pas et quel produit retenir selon l'architecture.
- Fine-tuning en IA, définition, usages et limitesCe qu'est le fine-tuning d'un modèle d'IA, à quoi il sert vraiment, ce qu'il ne garantit pas, sa surface d'attaque et ses conditions d'exploitation.
- Faille chatbot Chevrolet 2023, Tahoe à 1 dollar et injectionComment le chatbot du concessionnaire Chevrolet de Watsonville a accepté de vendre un Tahoe 2024 pour un dollar par injection d'instructions, et ce qu'un gardien d'entrée et de sortie du LLM aurait intercepté.
- Empoisonnement des données d'affinage d'un LLM local et backdoorComment l'empoisonnement des données d'entraînement installe une porte dérobée dans un modèle de langage affiné localement, et comment la provenance, la détection statistique et les tests de déclencheurs la contrent.
Pages voisines
La citent
- Fine-tuning en IA, définition, usages et limites
- Gardien IA pour LLM, fonctionnement, exemples et choix de produit
- Comment fonctionne l'inférence d'un modèle de langage
- Comparer GGUF GPTQ et AWQ pour LLM local
- LM Studio utilité, éditeur et limites sur poste de travail
- Relier FinOps et MLOps pour piloter le coût de l'IA en production
Evals LLM comment mesurer qu'un assistant IA répond juste
Elle cite
- Lien dans les deux sens :Comment observer un LLM en production
- Lien dans les deux sens :Comment red teamer un LLM local avant production
- Denial of wallet sur une application adossée à une API d'IA
- Évaluer la sécurité d'un fournisseur d'IA générative
- Guardrails programmatiques pour assistant IA de production
- Rétention des données envoyées à une API d'IA générative
: les deux pages se citent l’une l’autre.