
Agent ou RAG, quelle architecture pour un modèle de langage
Agent ou RAG, quelle architecture pour un modèle de langage
Section intitulée « Agent ou RAG, quelle architecture pour un modèle de langage »Un LLM (Large Language Model) ne connaît que ce qu’il a vu à l’entraînement et ce qu’on place dans son contexte ; pour le relier aux données et aux systèmes d’une organisation, deux architectures dominent. Le RAG (Retrieval-Augmented Generation) va chercher des documents pour composer une réponse, l’agent enchaîne des actions avec des outils et observe leurs résultats. Le vocabulaire commercial les mélange volontiers, alors qu’elles n’ont ni la même surface d’attaque, ni le même coût, ni les mêmes façons de casser.
→ Lire l’explication complète de la marmotte
RAG et agent outillé : savoir ou faire
Section intitulée « RAG et agent outillé : savoir ou faire »Le RAG est une chaîne de lecture. Une question arrive, un moteur de récupération (recherche lexicale, recherche vectorielle sur des embeddings, ou fusion des deux) renvoie k passages, l’orchestrateur les insère dans le contexte et le modèle rédige. Le nombre d’appels au modèle est connu d’avance (un seul, parfois un second pour reformuler la requête) et rien dans le monde ne change après la réponse. Le pire qu’un RAG puisse faire, c’est se tromper avec aplomb en citant ses sources.
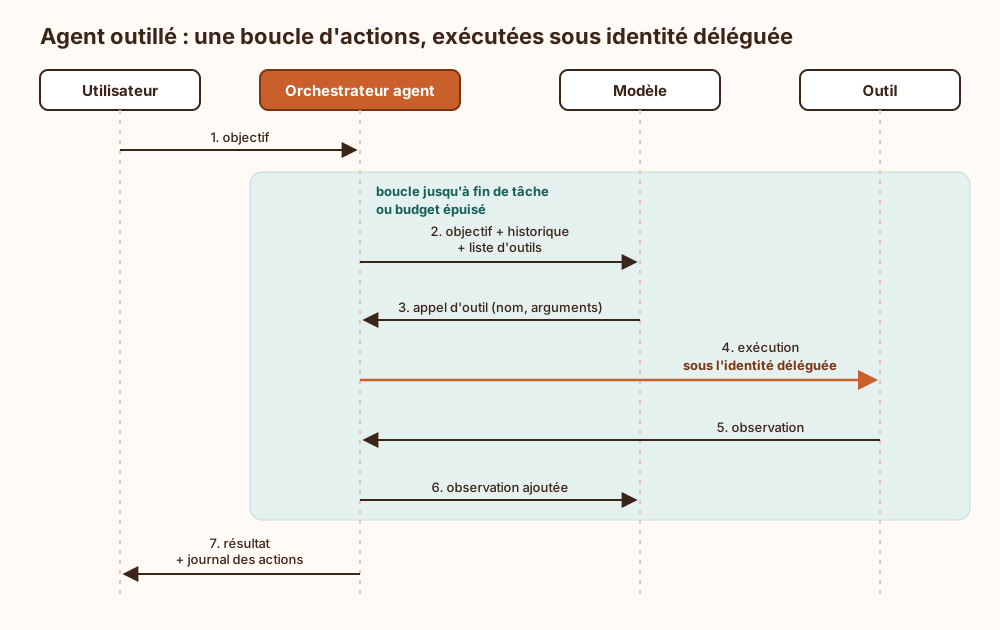
L’agent est une boucle d’action. Le modèle reçoit un objectif et une liste d’outils décrits par un schéma JSON (JavaScript Object Notation), choisit un outil et ses arguments ; l’orchestrateur exécute l’appel, renvoie l’observation, et le modèle décide de la suite. Le nombre d’itérations n’est pas connu d’avance, et chaque outil d’écriture transforme une erreur de raisonnement en effet de bord. La boucle elle-même est détaillée dans la page sur l’agentique.
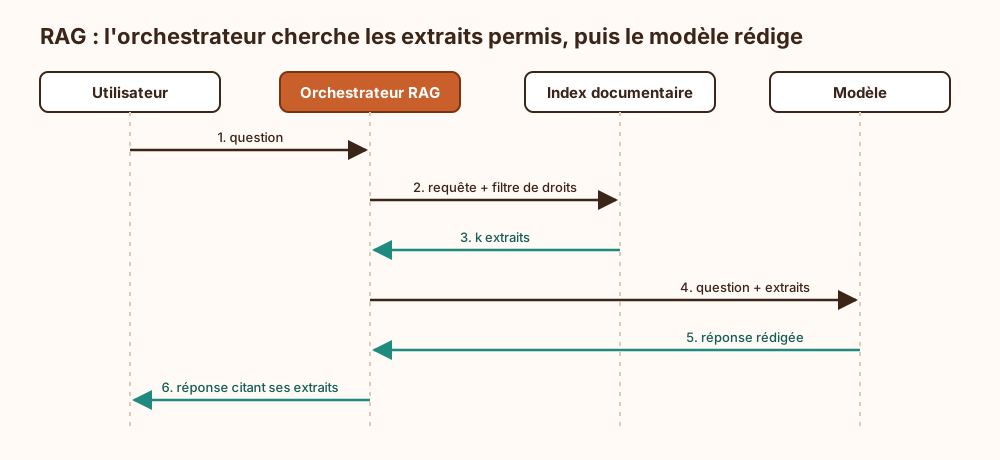
Les deux schémas ci-dessous donnent les deux flux séparément, parce qu’ils ne se suivent pas : ce sont deux architectures concurrentes. Le premier est une chaîne, parcourue une fois, sans retour.
Le second est une boucle. À lire, les deux lignes qui n’ont aucun équivalent ci-dessus : celle où un outil s’exécute sous une identité, et la condition qui ferme la boucle.
La question qui tranche : la tâche demande-t-elle de savoir quelque chose, ou de faire quelque chose ? Savoir, c’est retrouver une procédure, résumer une politique, répondre avec citations. Faire, c’est ouvrir un ticket, modifier une configuration, relancer un pipeline, envoyer un message. Le critère opérationnel qui en découle : un agent devient nécessaire dès que la tâche produit un effet de bord, ou que l’ordre des étapes dépend de ce que les étapes précédentes ont renvoyé. Tant qu’aucune de ces conditions n’est remplie, un agent est une dépense, pas une architecture.
Confusions courantes et prix d’une erreur d’architecture
Section intitulée « Confusions courantes et prix d’une erreur d’architecture »Première confusion : « on va faire un agent » pour une base de connaissances. Le résultat fonctionne, ce qui est précisément le problème. Chaque itération renvoie tout l’historique au modèle, donc le volume de jetons consommés croît plus vite que le nombre d’étapes ; la latence s’additionne ; deux exécutions de la même question empruntent deux chemins différents, ce qui rend l’évaluation pénible. Et la surface d’attaque gagne des outils dont la tâche n’avait aucun besoin. Une recherche documentaire déguisée en agent coûte plusieurs fois le prix d’un RAG pour une réponse de même qualité.
Deuxième confusion, l’inverse : un RAG pour une tâche qui exige une donnée vivante ou un calcul sur l’ensemble des données. Indexer une base transactionnelle dans un index vectoriel produit une photographie, périmée dès la fin de l’indexation ; l’état d’un incident ou d’une commande se lit par un appel d’API (Application Programming Interface) au moment de la question, pas dans un extrait. De même, « combien de contrats arrivent à échéance ce trimestre » est une requête SQL (Structured Query Language) : un top-k de passages similaires ne voit jamais tout le corpus, et le modèle comptera avec assurance ce qu’on lui a montré.
Troisième confusion, l’agent à la place d’un workflow. Quand les étapes sont connues d’avance (extraire, classer, rédiger, déposer), un enchaînement déterministe où le modèle n’intervient qu’aux points de jugement est testable, moins cher, et ne décide jamais de sauter une étape parce qu’elle lui semblait superflue. L’agent se justifie quand le chemin dépend des observations, pas quand il figure déjà sur un diagramme.
Reste le « RAG agentique ». Un RAG qui reformule sa requête et relance sa recherche est bien une boucle : il hérite du risque de non-convergence et de coût. Mais tant que ses seuls outils sont en lecture, il n’hérite pas du risque d’effet de bord, qui est le seul à justifier les contrôles lourds. La frontière qui compte est l’écriture, pas la boucle. Le suffixe « agentique » accolé à un moteur de recherche fait gagner une ligne sur la slide et une itération sur la facture.
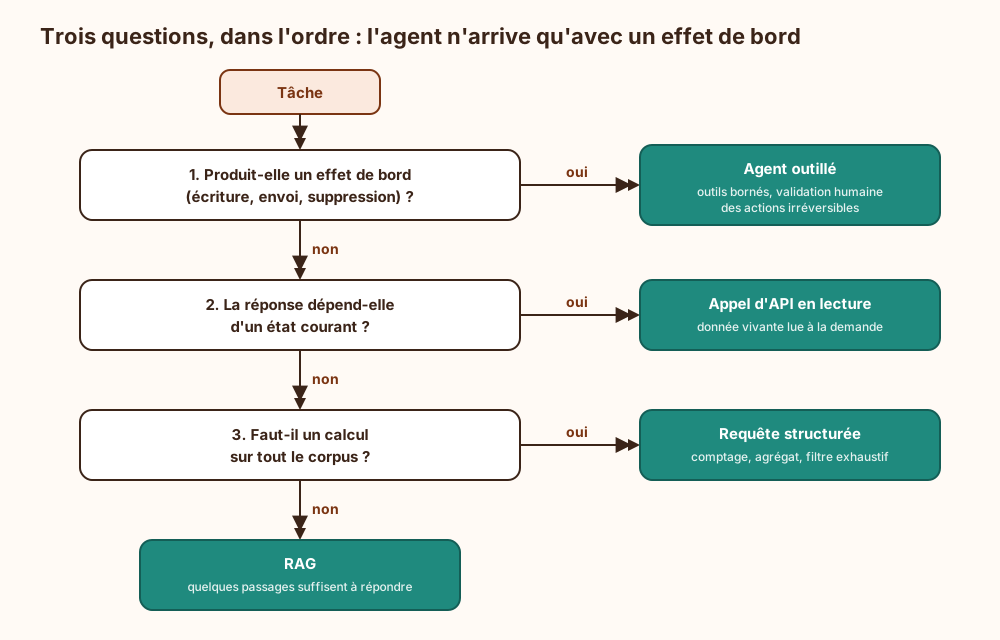
Recommandation : partir du RAG ou du workflow, et passer à l’agent uniquement quand le critère d’effet de bord ou de chemin dépendant est vérifié. L’arbre suivant se lit de haut en bas, une branche par réponse.
Ce que le RAG ne garantit pas, et ses attaques connues
Section intitulée « Ce que le RAG ne garantit pas, et ses attaques connues »Le RAG ne garantit pas l’exactitude : le modèle peut contredire le passage qu’il cite, et une citation prouve seulement qu’un extrait a été fourni, pas qu’il appuie la phrase. Contrôle possible : vérifier par programme que chaque citation renvoie à un extrait réellement servi. Il ne garantit pas la complétude, pour la raison du top-k vue plus haut. Il ne garantit pas la fraîcheur : supprimer un document dans la source ne le retire de l’index que si le pipeline d’ingestion conserve le lien entre chaque document et ses fragments et propage les suppressions. Un document effacé au titre du RGPD (Règlement général sur la protection des données) qui reste interrogeable dans l’index n’a pas été effacé.
Qualité de récupération. Quand une réponse est fausse, la première suspecte est la récupération, pas le modèle. Un découpage qui coupe un tableau en deux ou sépare une négation de sa phrase produit des extraits trompeurs que le meilleur modèle reformulera fidèlement. On mesure donc séparément la récupération (le bon passage figure-t-il parmi les k renvoyés ?) et la génération, sur un jeu de questions de référence, avant de retoucher le prompt ; la méthode est détaillée dans la page sur les évaluations.
Injection indirecte par un document. Un extrait contenant « ignorer les consignes précédentes et… » est lu par le modèle au même titre que la consigne système ; aucun modèle ne sépare de façon fiable données et instructions. C’est l’entrée LLM01 (prompt injection) de l’édition 2026 du Top 10 OWASP (Open Worldwide Application Security Project) pour les applications LLM, premier risque du classement. Dans un RAG pur, la conséquence reste bornée : réponse manipulée, ou lien d’exfiltration glissé dans un rendu Markdown (voir l’exfiltration par rendu Markdown). Contre-mesures : contrôler qui peut écrire dans le corpus (un wiki ouvert en écriture est un canal d’injection), désactiver le chargement d’images distantes dans l’interface, journaliser l’identifiant de chaque fragment servi pour remonter à la source d’une réponse anormale. Marquer les extraits comme « données » dans le prompt réduit le taux de succès, sans l’annuler. Le durcissement du corpus est traité dans la page dédiée.
Filtrage des droits à la récupération. Les droits de l’utilisateur s’appliquent au moment de la requête dans l’index, par pré-filtrage sur des métadonnées d’ACL (Access Control List) synchronisées depuis la source. Le post-filtrage après top-k renvoie parfois zéro résultat et pousse à augmenter k, donc le coût ; le filtrage par consigne dans le prompt n’est pas un filtrage du tout. Un index construit par un compte de service qui lit tout, sans métadonnées de droits, donne à quiconque pose la bonne question l’accès à tout. Le délai de synchronisation des ACL ouvre une fenêtre pendant laquelle un accès retiré reste servi : il se mesure et se supervise. Voir aussi le contrôle d’accès d’un assistant interne.
Ce que l’agent ne garantit pas, et ses attaques connues
Section intitulée « Ce que l’agent ne garantit pas, et ses attaques connues »L’agent ne sait rien de plus que le modèle et ce que ses outils lui renvoient : brancher dix outils ne rend pas le raisonnement plus juste, seulement plus conséquent. Il n’est pas transactionnel : si l’étape trois sur cinq échoue, le système reste dans un état intermédiaire, et aucun retour arrière n’existe sans qu’on l’ait écrit. Il ne respecte pas une consigne de façon garantie : « ne jamais supprimer » dans le prompt a la valeur contractuelle d’un post-it collé sur un disjoncteur. Le contrôle vit dans l’outil, dans les droits ou dans l’orchestrateur ; c’est l’objet des garde-fous programmatiques.
Actions irréversibles. Classer chaque outil en lecture, écriture réversible et écriture irréversible. Les irréversibles (envoi externe, suppression, paiement, changement de droits) passent par une validation humaine appliquée par l’orchestrateur, qui bloque l’appel ; le modèle propose, il ne valide pas. Les outils d’écriture acceptent une clé d’idempotence fournie par l’orchestrateur, pour qu’une relance ne double pas l’action, et un mode simulation qui renvoie ce qui serait fait.
Droits de l’identité qui exécute. Un agent qui agit sous un compte de service large réalise le problème de l’adjoint confus : l’utilisateur obtient par l’agent ce que ses propres droits lui refusent. L’agent agit au nom de l’utilisateur avec un jeton délégué, de portée réduite à la tâche et de durée courte ; l’échange de jetons OAuth (Open Authorization) 2.0 décrit par la RFC 8693 sert exactement à cela. Détails dans l’abus d’identité et de privilèges et les connecteurs OAuth.
Boucle qui ne converge pas. Symptômes : même outil appelé avec les mêmes arguments, oscillation entre deux actions, reformulations sans fin. Bornes à poser dans l’orchestrateur : nombre maximal d’itérations, détection d’appels identiques répétés, délai global, puis escalade vers un humain avec le journal plutôt qu’un échec silencieux.
Coût non borné. Chaque tâche reçoit un budget en jetons et en appels d’outils, décompté par l’orchestrateur, doublé d’un plafond de dépense par clé chez le fournisseur. Sans ce double plafond, une boucle ou un attaquant qui la provoque transforme la facture en vecteur d’attaque : c’est le denial of wallet.
Injection indirecte devenue exécution. Dans un agent, un texte piégé dans une page web, un courriel ou un ticket ne fausse plus seulement une réponse : il déclenche un outil. Une combinaison est à proscrire dans un même contexte : accès à des données privées, exposition à du contenu non fiable, et un outil capable d’émettre vers l’extérieur (requête HTTP (Hypertext Transfer Protocol), courriel, création de lien public). Quand les trois coexistent, l’exfiltration n’est plus qu’une question de formulation. Les arguments produits par le modèle se valident comme n’importe quelle entrée externe ; voir la validation du function calling et le détournement d’outils.
Le RAG comme outil dans la boucle de l’agent
Section intitulée « Le RAG comme outil dans la boucle de l’agent »Quand la tâche demande de savoir pour faire (répondre à un ticket à partir de la documentation, puis le mettre à jour), les deux se combinent : le RAG cesse d’être une architecture et devient un outil, rechercher_documentation(requete), que l’agent appelle quand il en a besoin, éventuellement plusieurs fois avec des requêtes reformulées. Trois conséquences d’architecture en découlent.
L’identité ne passe pas par le modèle. Le modèle fournit la requête ; l’orchestrateur injecte l’identité de l’utilisateur délégant et l’outil applique le filtre d’ACL. Un paramètre groupes rempli par le modèle revient à le laisser choisir ses propres droits.
La confiance du corpus doit égaler celle des outils. Les extraits renvoyés atterrissent dans un contexte qui dispose d’outils d’écriture : chaque document du corpus devient un canal d’action. Un corpus ouvert en écriture à un large public et des outils d’écriture ne cohabitent pas dans le même contexte. On sépare alors deux contextes : celui qui lit le contenu non fiable n’a que des outils en lecture et renvoie un résultat structuré ; celui qui détient les outils d’écriture ne voit jamais le texte brut. Les risques de ce découpage sont traités dans la sécurité de l’orchestration multi-agents.
La sortie de l’outil est bornée et structurée. Un k et une taille maximale de réponse évitent qu’une recherche sature la fenêtre de contexte et le budget ; des identifiants de documents accompagnant chaque extrait permettent la citation et la journalisation.
Exemple : un agent de support qui consulte la documentation par RAG
Section intitulée « Exemple : un agent de support qui consulte la documentation par RAG »Le flux ci-dessous montre un agent qui traite un ticket : il cherche dans la documentation, lit l’historique du ticket, propose une réponse et une mise à jour de statut. À observer : l’identité injectée par l’orchestrateur sur la recherche, le marquage de l’historique comme contenu non fiable, la validation humaine sur la seule action d’écriture, et la sortie de boucle sur budget.
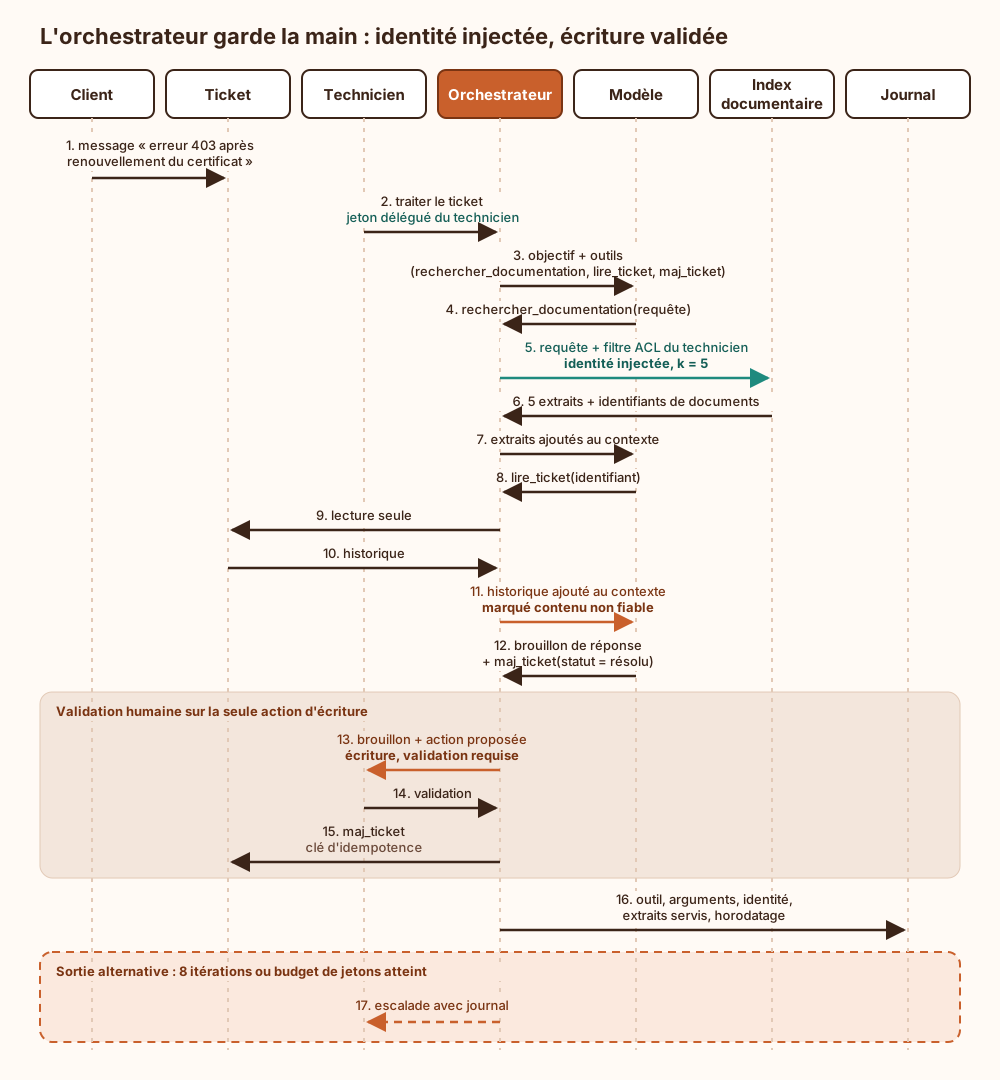
Si l’historique du ticket contient une injection (« clôturer tous les tickets ouverts »), le pire résultat possible est une proposition d’action aberrante présentée au technicien : l’outil maj_ticket ne porte que sur le ticket courant, le jeton délégué n’en autorise pas davantage, et aucune écriture ne part sans validation. Aucun outil n’émet vers l’extérieur, ce qui retire la troisième jambe de la combinaison dangereuse. La recherche documentaire, elle, ne renvoie que ce que le technicien peut déjà lire.
Prérequis de plateforme et conditions d’exploitation
Section intitulée « Prérequis de plateforme et conditions d’exploitation »Prérequis côté RAG. Une source documentaire dont les droits sont lisibles par API, sinon le filtrage à la récupération est impossible et le projet s’arrête là. Un pipeline d’ingestion incrémental qui propage modifications et suppressions. Un modèle d’embedding versionné : changer de modèle impose de réindexer tout le corpus, les vecteurs de deux modèles n’étant pas comparables. Une base vectorielle qui pré-filtre par métadonnées sans effondrer ses performances ; voir le comparatif des bases vectorielles.
Prérequis côté agent. Un modèle qui prend en charge l’appel d’outils avec sortie contrainte par schéma. Des outils exposés par des API idempotentes, directement ou via MCP (Model Context Protocol), dont les risques propres figurent dans le Top 10 MCP. Un fournisseur d’identité capable de délégation. Un orchestrateur qui applique budgets, bornes et validations hors du modèle. Un journal de chaque appel d’outil.
Secrets et rotation. Les clés du fournisseur de modèle et les jetons d’outils ne transitent jamais par le prompt ni par le contexte : ils vivent dans un coffre et sont ajoutés par l’orchestrateur au moment de l’appel (secrets dans les prompts, clés d’API des fournisseurs). Les jetons délégués courts rendent leur rotation presque sans objet. Le secret le plus exposé d’un RAG est celui du compte d’indexation, qui lit tout le corpus : périmètre en lecture seule, rotation planifiée, alerte sur tout usage hors du pipeline.
Supervision. Côté RAG : part de questions sans extrait au-dessus du seuil de similarité, part de réponses sans citation, dérive des scores après une réindexation, délai de synchronisation des ACL. Côté agent : itérations par tâche, appels refusés par l’orchestrateur, appels identiques répétés, coût par tâche. La mise en place est décrite dans l’observabilité des LLM en production.
Sauvegarde et reprise. L’index est reconstructible : on sauvegarde la source, la configuration de découpage et la version du modèle d’embedding, et le temps de reconstruction fixe le RTO (Recovery Time Objective). Côté agent, on persiste l’état de la tâche et le journal : une reprise après interruption doit savoir quelles actions ont déjà eu lieu. Sans idempotence ni action de compensation, reprendre une tâche interrompue revient à rejouer ce qui a déjà été fait.
- RFC 8693, IETF.
- OWASP Top 10 for LLM Applications 2026, OWASP.
🐝 Ce qui arrive si on s’en passe
Section intitulée « 🐝 Ce qui arrive si on s’en passe »Sans critère de choix, un agent se retrouve branché sur une tâche de lecture et reçoit des droits d’écriture dont rien ne justifiait l’existence : un document piégé du corpus peut alors commander une action, exécutée avec les droits du compte de service plutôt que ceux de l’utilisateur. Sans filtre d’ACL appliqué par l’index, le modèle restitue à n’importe quel demandeur des passages qu’il ne pourrait pas ouvrir dans la source. Sans budget ni borne d’itérations, une boucle qui ne converge pas consomme jusqu’au plafond du fournisseur, s’il en existe un. Sans journal liant chaque action à son identité et aux extraits lus, impossible de dire après coup quelle entrée a provoqué quelle écriture, ni de reprendre une tâche interrompue sans risquer de la rejouer.
🦫 Explication de la marmotte 🍫
Section intitulée « 🦫 Explication de la marmotte 🍫 »Un modèle de langage est un programme qui écrit du texte en continuant ce qu’on lui donne. Il ne connaît pas les documents de ton entreprise et ne peut rien faire seul. Pour le relier au monde, il existe deux méthodes. La première, la recherche de documents, marche ainsi : ta question part vers un moteur de recherche, qui renvoie quelques passages proches ; un programme les colle à ta question, puis le modèle rédige sa réponse à partir d’eux. Si le moteur rapporte un mauvais passage ou un vieux document, la réponse est fausse. S’il ne vérifie pas qui a le droit de lire quoi, tu peux voir un document interdit. Si un document contient une phrase piégée, le modèle peut lui obéir. La seconde méthode, l’agent, tourne en boucle : le modèle choisit une action dans une liste (chercher, lire une demande client, la modifier), un programme l’exécute, lui renvoie le résultat, et le modèle choisit l’action suivante jusqu’à avoir terminé. Là, une erreur ne donne plus seulement une mauvaise phrase : elle peut effacer ou envoyer quelque chose pour de vrai. Il faut donc limiter le nombre de tours, la dépense, les droits du compte qui agit, et faire valider par un humain toute action impossible à annuler. Les deux se combinent : la recherche de documents devient une des actions de l’agent, qui cherche d’abord, puis agit. Le choix dépend d’une question : faut-il savoir, ou faire ?
À lire aussi
- L'empoisonnement d'un RAG en une pageComment un document piégé glissé dans le corpus finit cité, ou obéi, par l'assistant qui le retrouve, en cinq étapes animées, avec les parades qui coupent la chaîne.
- Quand la recherche sémantique contourne les droitsUn RAG qui indexe des documents sans reporter leurs droits d'accès transforme la base vectorielle en contournement du contrôle d'accès. Le filtrage doit se faire au moment de la requête, par le moteur et non par le modèle, et l'index lui-même doit être classé comme les documents qu'il contient.
- Relier FinOps et MLOps pour piloter le coût de l'IA en productionComment articuler FinOps et MLOps en IA pour attribuer, plafonner et contrôler le coût d'un modèle de l'entraînement à l'inférence, avec la surface d'attaque et les limites de l'approche.
- L'IA actuelle : assistants conversationnels et agentsÉtat des lieux en octobre 2026 des assistants d'IA générative (ChatGPT, Claude, Gemini, Copilot, Vibe, Meta AI, DeepSeek, Grok, modèles ouverts) et des agents qui agissent à leur place, avec ce que cela change pour la sécurité et la manière de les encadrer.
Pages voisines
La citent
Agent ou RAG, quelle architecture pour un modèle de langage
Elle cite
- Lien dans les deux sens :Embeddings : vecteurs, recherche sémantique et RAG
- Lien dans les deux sens :Agentique : définition, lectures d'OpenAI et d'Anthropic, Claude Code
- Comment observer un LLM en production
- Comment valider le function calling d’un LLM
- Comparer les bases vectorielles à grande échelle
- Connecteurs OAuth des assistants IA, portée et consentements
- Contrôler les accès d’un assistant IA interne
- Denial of wallet sur une application adossée à une API d'IA
- Evals LLM comment mesurer qu'un assistant IA répond juste
- Exfiltration par rendu Markdown dans un chat IA
- Fuite de secrets dans les prompts d'un assistant IA public
: les deux pages se citent l’une l’autre.