
Apprentissage automatique et réseaux de neurones, attaques du modèle
Apprentissage automatique et réseaux de neurones, attaques du modèle
Section intitulée « Apprentissage automatique et réseaux de neurones, attaques du modèle »Un réseau de neurones n’est pas programmé, il est ajusté : des millions de nombres réglés jusqu’à ce que l’erreur baisse sur des exemples. Tout ce qui touche ces exemples, ces nombres ou les réponses du modèle devient donc une surface d’attaque, et aucune ne ressemble à une faille de code. Cette page décrit le mécanisme d’entraînement, puis place les quatre familles d’attaque (empoisonnement, évasion, extraction, inversion) à l’endroit exact où elles frappent.
→ Lire l’explication complète de la marmotte
Apprentissage supervisé, non supervisé et par renforcement
Section intitulée « Apprentissage supervisé, non supervisé et par renforcement »L’apprentissage automatique (Machine Learning, ML) désigne les méthodes où le comportement d’un programme est déduit de données plutôt qu’écrit à la main. C’est une branche de l’IA (intelligence artificielle), pas un synonyme : la carte complète des familles est sur la page différence entre IA et LLM. Trois régimes d’apprentissage se distinguent par ce que le modèle reçoit comme correction.
- Supervisé : chaque exemple arrive avec la réponse attendue (l’étiquette). Le modèle apprend la correspondance entrée vers étiquette. Classification de courriels, détection de fraude, reconnaissance d’images. La qualité des étiquettes plafonne la qualité du modèle, et celui qui écrit les étiquettes écrit le comportement.
- Non supervisé : aucune étiquette. Le modèle cherche une structure (groupes, axes de variation, écarts à la norme). Détection d’anomalies, regroupement, et construction de représentations vectorielles comme les embeddings. La variante dite auto-supervisée fabrique ses étiquettes à partir de la donnée elle-même (prédire le mot suivant) : c’est le régime de pré-entraînement des grands modèles de langage, ou LLM (Large Language Model).
- Par renforcement : un agent agit dans un environnement et reçoit une récompense. Il apprend une stratégie qui maximise la récompense cumulée. Celui qui contrôle la récompense contrôle la stratégie, ce qui devrait inquiéter davantage que cela n’inquiète.
Pour la sécurité, le régime détermine la ressource à protéger : les étiquettes en supervisé, la composition du corpus en non supervisé, le signal de récompense en renforcement.
Entraînement d’un réseau de neurones : poids, fonction de perte, descente de gradient
Section intitulée « Entraînement d’un réseau de neurones : poids, fonction de perte, descente de gradient »Un neurone artificiel fait une opération d’une modestie désarmante : il multiplie chacune de ses entrées par un poids, additionne le tout avec un biais, puis passe le résultat dans une fonction d’activation non linéaire. Sans cette non-linéarité, empiler des neurones ne servirait à rien : mille couches linéaires se réduisent à une seule. Les neurones sont rangés en couches ; la sortie d’une couche alimente la suivante. Poids et biais forment les paramètres du modèle. Ce sont eux, et eux seuls, qui changent pendant l’entraînement.
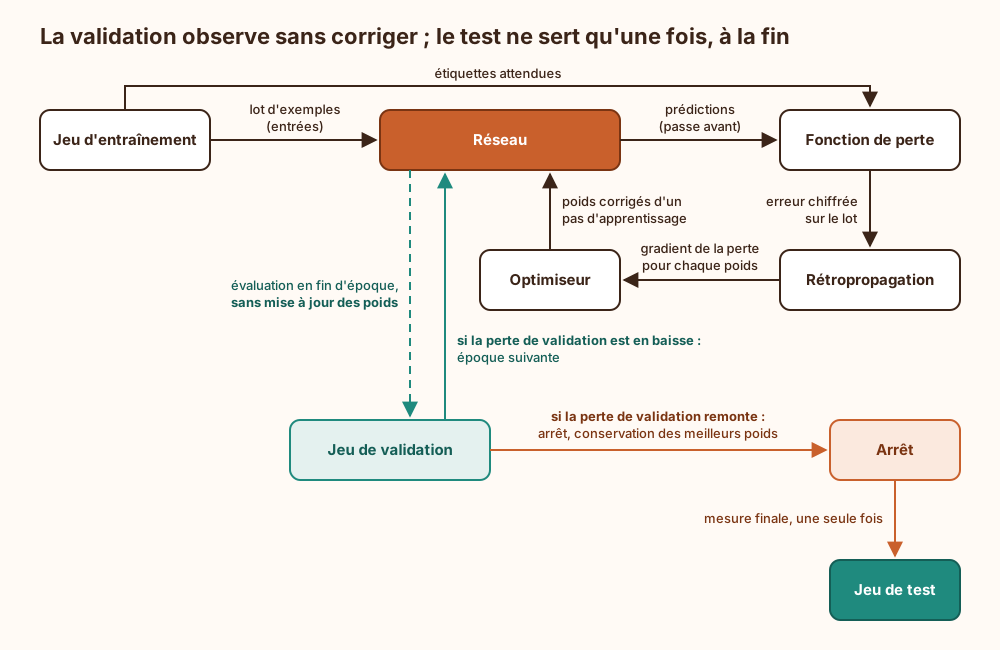
La fonction de perte transforme l’écart entre la prédiction et l’étiquette attendue en un nombre. Perte élevée : le modèle se trompe beaucoup. Tout l’entraînement consiste à faire baisser ce nombre.
La descente de gradient est la méthode pour y arriver. Le gradient indique, pour chaque poids, dans quel sens et avec quelle intensité la perte varie quand ce poids bouge. On déplace chaque poids d’un petit pas dans le sens qui fait baisser la perte ; la taille du pas s’appelle le pas d’apprentissage (learning rate). En pratique le gradient est estimé sur un lot d’exemples, pas sur tout le jeu de données, d’où le qualificatif « stochastique ».
La rétropropagation est l’algorithme qui calcule ce gradient pour tous les poids en une seule passe arrière : l’erreur part de la sortie et remonte couche par couche, chaque couche recevant sa part de responsabilité. Ni magie ni conscience émergente : de la dérivation en chaîne, exécutée très vite sur du matériel très cher.
Une époque correspond à un passage complet sur le jeu d’entraînement. Le schéma ci-dessous montre la boucle : y lire que la validation observe le modèle sans jamais le corriger, et que le test n’intervient qu’une fois, à la fin.
Deux conséquences d’architecture découlent de ce mécanisme, et elles structurent tout le reste de la page.
Première conséquence : le comportement du modèle vit entièrement dans un fichier de poids. Aucune règle à relire, aucune branche conditionnelle à auditer. Une revue de code du script d’entraînement ne dit rien de ce que le modèle a appris ; seule la donnée le dit, et encore, pas en la lisant.
Seconde conséquence : le gradient sert dans les deux sens. Le défenseur l’utilise pour modifier les poids afin de réduire l’erreur. L’attaquant utilise le même calcul pour modifier l’entrée afin d’augmenter l’erreur. L’outil d’apprentissage et l’outil d’attaque sont le même outil.
Jeux d’entraînement, de validation et de test : le surapprentissage
Section intitulée « Jeux d’entraînement, de validation et de test : le surapprentissage »Les données sont découpées en trois ensembles qui ne se recouvrent pas. Le jeu d’entraînement sert à ajuster les poids. Le jeu de validation sert à régler ce que la descente de gradient ne règle pas (nombre de couches, pas d’apprentissage, moment d’arrêt). Le jeu de test sert à mesurer la performance finale sur des données que rien n’a influencé.
Le surapprentissage survient quand le modèle mémorise ses exemples au lieu d’en extraire une règle. Le symptôme se lit sur deux courbes : la perte d’entraînement continue de baisser pendant que la perte de validation remonte. Les parades classiques sont l’arrêt anticipé, la régularisation (pénaliser les poids trop grands, désactiver aléatoirement des neurones pendant l’entraînement) et, plus prosaïquement, davantage de données.
Les pièges qui faussent la mesure sont toujours les mêmes :
- Fuite entre les jeux. Des doublons ou quasi-doublons répartis de part et d’autre du découpage gonflent le score de test. La déduplication se fait avant le découpage, jamais après. Pour des données datées, le découpage est chronologique : tester sur le passé un modèle entraîné sur le futur donne des résultats flatteurs et faux.
- Jeu de test usé. Un jeu de test consulté à chaque itération pour choisir une architecture devient un jeu de validation. Le chiffre final est alors optimiste, et personne ne sait de combien.
- Dérive. Le score de test vaut pour la distribution des données au moment de la collecte. Quand la production s’en éloigne, la performance baisse sans qu’aucune alerte technique ne se déclenche.
Le point qui compte pour la sécurité : un score de test mesure un comportement moyen sur des données honnêtes. Il ne dit rien du comportement face à une entrée fabriquée pour tromper, ni de la présence d’un comportement caché. Un modèle à 99 % en test prouve surtout que le jeu de test lui ressemble. Et le surapprentissage n’est pas qu’un défaut de qualité : un modèle qui mémorise est un modèle qui fuit, comme on le verra à l’inversion.
Cycle de vie du modèle et points d’entrée des quatre attaques
Section intitulée « Cycle de vie du modèle et points d’entrée des quatre attaques »Les quatre familles se distinguent par le moment où l’attaquant intervient et par ce qu’il doit pouvoir toucher. Le schéma suivant place chacune sur le cycle de vie : y lire que deux attaques exigent un accès en écriture en amont, et que les trois autres flèches ne demandent qu’un accès légitime au service.
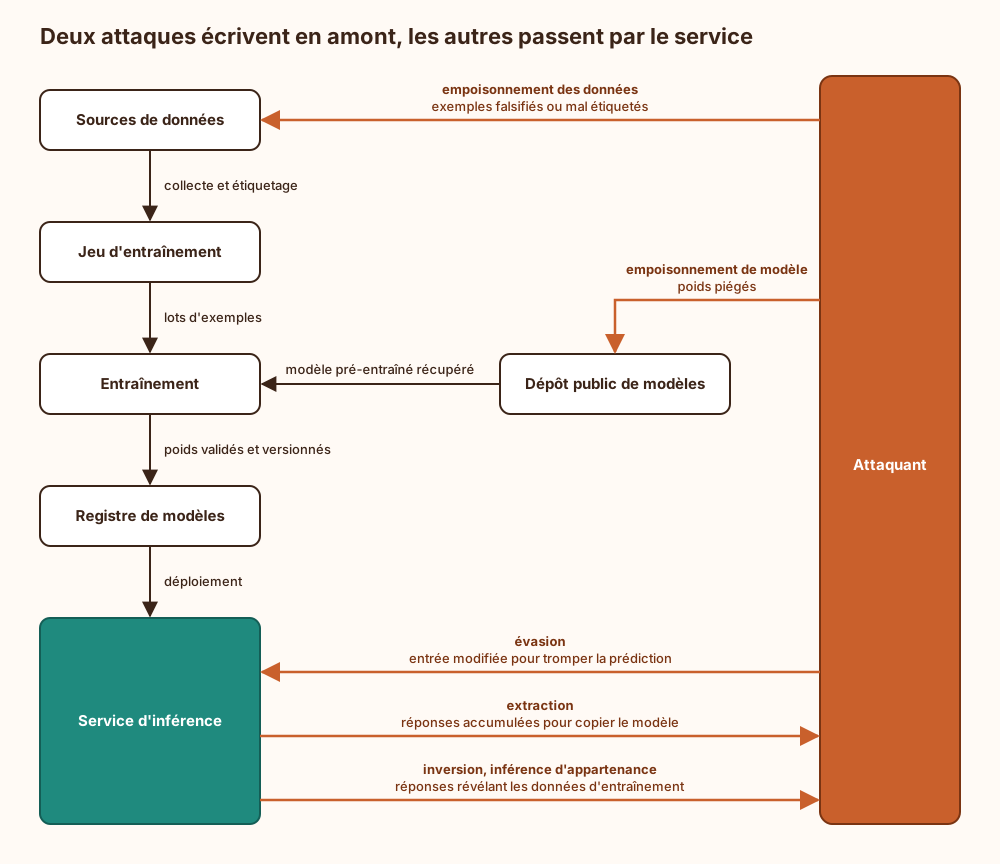
L’empoisonnement vise l’intégrité à l’entraînement. L’évasion vise l’intégrité à l’usage. L’extraction vise la confidentialité du modèle. L’inversion et l’inférence d’appartenance visent la confidentialité des données. Ce qui se passe côté service au moment de la prédiction est détaillé sur la page inférence.
Empoisonnement des données et du modèle à l’entraînement
Section intitulée « Empoisonnement des données et du modèle à l’entraînement »Ce que l’attaquant doit toucher. Soit une fraction des données d’entraînement (une source collectée automatiquement, un canal de retours utilisateurs, un prestataire d’étiquetage), soit le modèle pré-entraîné qui sert de point de départ. Aucun accès à l’infrastructure d’entraînement n’est nécessaire : il suffit d’écrire là où le pipeline viendra lire.
Ce qu’il obtient. Trois variantes, de la plus bruyante à la plus discrète. La dégradation générale : le modèle devient mauvais partout, ce qui se voit. L’empoisonnement ciblé : le modèle se trompe sur une classe ou une entrée précise. La porte dérobée : le modèle se comporte normalement, sauf en présence d’un déclencheur choisi par l’attaquant (un motif, une chaîne, un détail visuel), auquel cas il produit la sortie voulue. Cette dernière variante passe la validation et le test sans broncher, puisque ni l’un ni l’autre ne contient le déclencheur.
Contre-mesures. Provenance tracée de chaque source, jeux de données versionnés avec empreintes, plafond sur la contribution d’une source unique, détection de valeurs aberrantes et d’étiquettes incohérentes avant entraînement. Pour les poids récupérés : empreinte vérifiée, signature de l’éditeur, et un format de fichier qui ne contient que des tenseurs. Certains formats de sérialisation, pickle de Python en tête, exécutent du code au chargement : le sujet n’est alors plus l’empoisonnement mais l’exécution de code arbitraire sur la machine d’entraînement.
Ce que cela ne garantit pas. Une signature prouve qui a publié le fichier, pas que les poids sont sains. Un fichier de poids téléchargé sur un dépôt public reste un binaire de provenance inconnue, avec un meilleur service de presse. Le filtrage statistique rate les empoisonnements conçus pour ressembler à des exemples légitimes. Et aucune méthode ne certifie l’absence de porte dérobée dans un modèle donné. Le cas particulier de l’affinage d’un LLM, porte dérobée comprise, est traité sur la page empoisonnement des données d’affinage d’un LLM local.
Évasion par exemples adverses à l’inférence
Section intitulée « Évasion par exemples adverses à l’inférence »Ce que l’attaquant doit toucher. L’entrée, rien d’autre. Un exemple adverse (la version française de l’AI Act écrit « exemple contradictoire ») est une entrée modifiée de façon minime, souvent imperceptible pour un humain, calculée pour faire basculer la prédiction. Avec accès aux poids (boîte blanche), la modification se calcule directement par le gradient de la perte par rapport à l’entrée. Sans accès aux poids (boîte noire), deux voies restent ouvertes : sonder le service par requêtes successives, ou fabriquer l’exemple sur un modèle de substitution, car les exemples adverses se transfèrent d’un modèle à l’autre avec une régularité déprimante.
Ce qu’il obtient. Une erreur choisie, sur une entrée choisie, sans rien modifier au modèle. Un filtre qui laisse passer, un classifieur qui range dans la mauvaise case.
Contre-mesures. L’entraînement adverse (inclure des exemples adverses dans le jeu d’entraînement) est la défense empirique de référence. La validation et la normalisation des entrées réduisent l’espace de manœuvre. La limitation de débit et la détection de séries de requêtes quasi identiques gênent le sondage en boîte noire.
Ce que cela ne garantit pas. L’entraînement adverse protège contre le type et l’amplitude de perturbation vus à l’entraînement, pas contre les autres. Il coûte de la précision sur les entrées normales et multiplie le temps de calcul. La plaquette dira « IA robuste » ; l’article scientifique dira « robuste pour une perturbation bornée, sur ce jeu de données ». La règle d’architecture qui en découle : une décision de sécurité ne repose jamais sur la seule sortie d’un modèle. Il faut un second contrôle d’une autre nature (règle déterministe, seuil métier, revue humaine sur les cas à fort enjeu).
Extraction et vol de modèle par les requêtes
Section intitulée « Extraction et vol de modèle par les requêtes »Ce que l’attaquant doit toucher. L’interface de prédiction, typiquement une API (Application Programming Interface), avec un compte parfaitement légitime. Il envoie des entrées, collecte les sorties, et entraîne un modèle de substitution sur ces couples.
Ce qu’il obtient. Une copie fonctionnelle : pas les poids exacts, mais un modèle qui répond presque pareil. Le coût d’entraînement est économisé, la propriété intellectuelle est partie, et surtout la copie donne une boîte blanche pour préparer des exemples adverses qui se transféreront sur l’original. L’extraction est souvent une étape, rarement une fin.
Contre-mesures. Authentification et quotas par client, journalisation des requêtes, détection de volumes et de distributions d’entrées anormales. Réduire ce que la réponse expose : renvoyer une étiquette plutôt qu’un vecteur complet de scores de confiance divise l’information cédée à chaque requête. Le tatouage du modèle (un comportement signature sur des entrées secrètes) permet de prouver la copie après coup.
Ce que cela ne garantit pas. Les quotas ralentissent, ils n’empêchent pas : un attaquant patient ou réparti sur plusieurs comptes passe sous les seuils. Le tatouage constate le vol, il ne l’évite pas. Et pour tout modèle embarqué sur un appareil livré à l’utilisateur, la question est réglée d’avance : les poids sont déjà chez lui.
Inversion de modèle et inférence d’appartenance
Section intitulée « Inversion de modèle et inférence d’appartenance »Ce que l’attaquant doit toucher. Là encore, seulement les réponses du modèle, idéalement avec les scores de confiance.
Ce qu’il obtient. L’inférence d’appartenance répond à une question binaire : cet enregistrement précis faisait-il partie du jeu d’entraînement ? Elle exploite l’écart de comportement du modèle entre les données vues et les données inconnues : confiance plus haute, perte plus basse sur ce qui a été appris. Quand le jeu d’entraînement est lui-même sensible (une liste de clients en contentieux, un fichier de salariés sanctionnés), la seule appartenance est une fuite. L’inversion de modèle va plus loin : reconstruire des caractéristiques représentatives des données d’entraînement, voire des exemples approchés, à partir des sorties.
Contre-mesures. Tout ce qui réduit le surapprentissage réduit le signal exploité : régularisation, arrêt anticipé, plus de données. Limiter la précision des sorties aide aussi. La confidentialité différentielle appliquée à l’entraînement (borner l’influence de chaque exemple sur le gradient, puis ajouter du bruit) est la défense qui fournit une garantie mathématique plutôt qu’un constat empirique. La minimisation en amont reste la plus efficace : une donnée absente du jeu d’entraînement ne fuit pas.
Ce que cela ne garantit pas. La confidentialité différentielle se paie en précision, et la garantie obtenue dépend d’un paramètre de budget dont la valeur retenue en pratique est parfois si large qu’elle ne borne plus grand-chose. La régularisation diminue le risque sans le chiffrer. La version LLM du problème (restitution mot pour mot de passages appris) est sur la page éviter la mémorisation dans un LLM interne.
Exemple : choisir les contrôles d’un classifieur exposé par API
Section intitulée « Exemple : choisir les contrôles d’un classifieur exposé par API »Soit un classifieur supervisé, entraîné à partir d’un modèle pré-entraîné public et de données internes enrichies par des retours utilisateurs, puis exposé par une API à des clients authentifiés. Le schéma suivant déroule les quatre questions à poser, une par famille d’attaque ; chaque réponse positive active un bloc de contrôles et rappelle ce qui reste découvert.
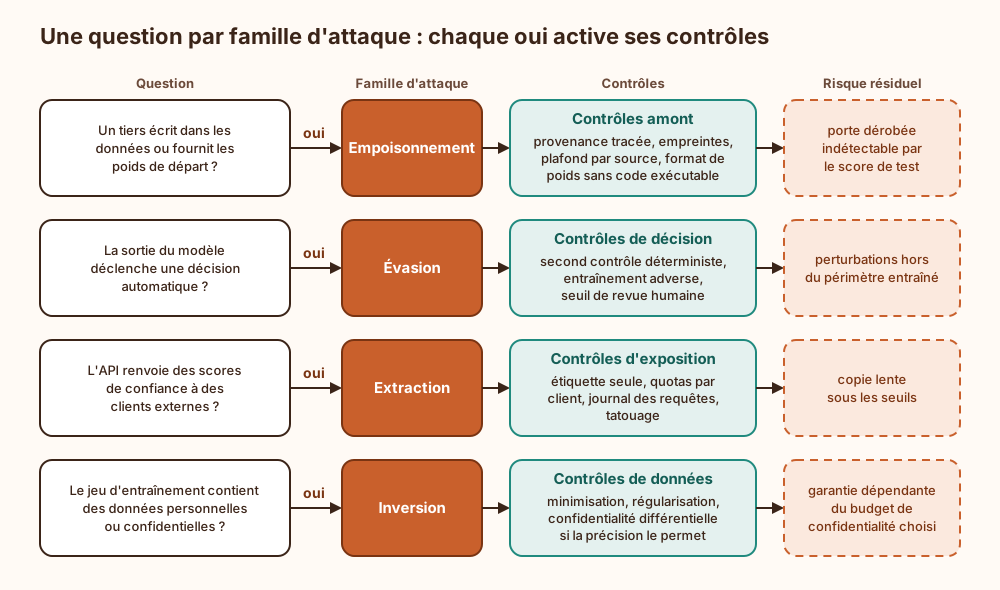
Dans ce cas, les quatre branches s’activent, ce qui est la situation normale et non un mauvais jour. L’ordre de traitement recommandé suit le coût : les contrôles amont et d’exposition relèvent de l’hygiène d’infrastructure classique et se posent en premier ; l’entraînement adverse et la confidentialité différentielle modifient le modèle lui-même, coûtent de la précision, et ne se décident qu’après avoir mesuré ce coût sur le jeu de validation.
Prérequis, exploitation et limites des défenses d’un modèle entraîné
Section intitulée « Prérequis, exploitation et limites des défenses d’un modèle entraîné »Le compromis central tient en une phrase : chaque défense appliquée au modèle lui-même (entraînement adverse, bruit de confidentialité, sorties appauvries) se paie en précision, en coût de calcul ou en confort d’usage, et aucune ne ferme sa famille d’attaque. La position défendue ici en découle : traiter le modèle comme un composant non fiable et placer l’essentiel de l’effort autour de lui (ce qui entre dans l’entraînement, ce qui sort de l’API, ce que la décision aval accepte sans vérifier). Les défenses internes au modèle viennent ensuite, quand l’enjeu les justifie. Le choix entre les deux dépend d’une seule question : que peut toucher l’attaquant, et que déclenche une erreur ?
Prérequis. Avant de parler robustesse, quatre choses doivent exister : un inventaire des sources de données avec leur provenance et leur niveau de confiance ; des jeux de données et des poids versionnés, identifiés par empreinte dans un registre ; un découpage entraînement, validation, test figé et documenté ; une API d’inférence authentifiée et journalisée. Sans le premier, l’empoisonnement n’est pas détectable. Sans le dernier, l’extraction n’est même pas observable.
Secrets et actifs. Le fichier de poids est un actif à double titre : sa confidentialité (il vaut le coût de l’entraînement, et il porte la trace des données) et son intégrité (le modifier, c’est modifier le comportement). Il se protège comme un binaire signé, pas comme un fichier de configuration. Les clés d’API des clients et la clé de signature des artefacts suivent les règles habituelles de gestion des secrets.
Rotation. L’équivalent de la rotation pour un modèle est le réentraînement. Il doit pouvoir se faire en excluant une source reconnue compromise, ce qui suppose de savoir quelle version du modèle a vu quelle version de quelles données.
Supervision. Trois signaux au minimum : la distribution des entrées et des scores en production (dérive), le volume et la diversité des requêtes par client (extraction, sondage adverse), le taux de désaccord entre le modèle et le second contrôle (évasion). Des exercices offensifs réguliers complètent la mesure ; la méthode appliquée à un LLM est décrite sur la page red teamer un LLM local avant production.
Sauvegarde et reprise. Sauvegarder les poids ne suffit pas : restaurer un modèle empoisonné redonne un modèle empoisonné. La reprise exige de pouvoir reconstruire, donc de conserver les données versionnées, le code, les réglages d’entraînement et les graines aléatoires.
Ce que rien de tout cela ne garantit. L’absence de porte dérobée ne se prouve pas. La robustesse hors du périmètre testé ne se déduit pas. La correction du modèle sur un cas individuel n’est jamais acquise : un modèle statistique se trompe par construction, la seule question est où.
Référentiels : MITRE ATLAS, NIST AI 100-2, OWASP et article 15 de l’AI Act
Section intitulée « Référentiels : MITRE ATLAS, NIST AI 100-2, OWASP et article 15 de l’AI Act »Quatre références structurent le sujet, chacune pour un usage différent.
- MITRE ATLAS (Adversarial Threat Landscape for Artificial-Intelligence Systems) : une base de tactiques et de techniques d’attaque contre les systèmes d’IA, sur le modèle de la base ATT&CK du même organisme, consacrée aux attaques contre les systèmes d’information classiques. Elle sert à la modélisation de menace et à la préparation d’exercices offensifs.
- NIST AI 100-2 (National Institute of Standards and Technology), intitulé « Adversarial Machine Learning: A Taxonomy and Terminology of Attacks and Mitigations » : la taxonomie de référence. Elle classe les attaques selon l’étape du cycle de vie, l’objectif de l’attaquant, ses capacités et sa connaissance du système. C’est le vocabulaire à adopter pour éviter que chaque équipe invente le sien.
- OWASP Machine Learning Security Top 10 (Open Worldwide Application Security Project) : une liste de risques orientée développement, qui couvre notamment la manipulation des entrées, l’empoisonnement des données, l’inversion de modèle, l’inférence d’appartenance, le vol de modèle et la chaîne d’approvisionnement.
- Règlement (UE) 2024/1689, dit AI Act, article 15, paragraphe 5 : pour les systèmes d’IA à haut risque, les solutions techniques destinées à remédier aux vulnérabilités spécifiques à l’IA comprennent, au besoin, des mesures pour prévenir, détecter, contrer, résoudre et maîtriser les attaques visant à manipuler le jeu de données d’entraînement (empoisonnement des données) ou les composants préentraînés utilisés en entraînement (empoisonnement de modèle), les entrées destinées à induire le modèle en erreur (« exemples contradictoires ou invasion de modèle » dans la version française, qui traduit ainsi adversarial examples or model evasion), les attaques visant la confidentialité et les défauts du modèle. Le texte nomme donc l’empoisonnement et l’évasion, et range l’extraction, l’inversion et l’inférence d’appartenance sous les attaques de confidentialité sans les citer une à une ; l’analyse est sur la page exactitude, robustesse et cybersécurité. Les exigences sur les jeux d’entraînement, de validation et de test relèvent de l’article 10, traité sur la page gouvernance des données d’entraînement. État du texte au 10 octobre 2026 : le règlement (UE) 2026/1744 (omnibus numérique) ne modifie pas l’article 15, il reporte la date d’application des exigences du haut risque, détaillée sur la page calendrier d’application. Savoir si un système donné entre dans la catégorie à haut risque se lit dans le texte officiel, pas dans cette page.
🐝 Ce qui arrive si on s’en passe
Section intitulée « 🐝 Ce qui arrive si on s’en passe »Sans provenance tracée ni versions reliées entre données et poids, une compromission découverte après coup ne se date pas : impossible de dire quel modèle en production a appris d’une source polluée, donc impossible de choisir vers quelle version revenir. Sans journal des requêtes, une copie du modèle se constitue sans laisser de trace, et les entrées trompeuses mises au point sur cette copie arrivent ensuite sans signe avant-coureur. Sans second contrôle derrière la prédiction, chaque erreur provoquée devient une décision exécutée, et le taux de désaccord qui aurait signalé l’attaque n’existe pas. Sans conservation de quoi reconstruire, la seule reprise possible consiste à redéployer le fichier qu’on soupçonne.
🦫 Explication de la marmotte 🍫
Section intitulée « 🦫 Explication de la marmotte 🍫 »Un réseau de neurones est un très grand calcul fait de millions de nombres réglables, appelés poids. Au départ, ces poids sont choisis au hasard, donc les réponses sont fausses. On montre alors au réseau des exemples dont on connaît la bonne réponse. Pour chaque groupe d’exemples, on mesure l’erreur par un nombre. Puis un calcul remonte de la sortie vers l’entrée pour savoir quel poids a contribué à l’erreur, et chaque poids est corrigé un tout petit peu. On recommence des milliers de fois, jusqu’à ce que l’erreur soit faible. Des exemples mis de côté servent à vérifier que le réseau a compris une règle générale et n’a pas retenu ses exemples par cœur.
Quatre attaques existent. Avant l’entraînement, quelqu’un peut glisser de faux exemples ou fournir un réseau déjà piégé : le réseau apprend alors un mauvais comportement, parfois caché. Après l’entraînement, quelqu’un peut modifier légèrement ce qu’il envoie pour provoquer une erreur précise. Il peut aussi poser énormément de questions pour fabriquer une copie du réseau. Enfin, il peut étudier les réponses pour deviner quelles données ont servi à l’entraînement. Aucune protection ne bloque tout : il faut contrôler d’où viennent les données, limiter ce que le réseau révèle et vérifier ses décisions par un autre moyen.
À lire aussi
- Fine-tuning en IA, définition, usages et limitesCe qu'est le fine-tuning d'un modèle d'IA, à quoi il sert vraiment, ce qu'il ne garantit pas, sa surface d'attaque et ses conditions d'exploitation.
- Relier FinOps et MLOps pour piloter le coût de l'IA en productionComment articuler FinOps et MLOps en IA pour attribuer, plafonner et contrôler le coût d'un modèle de l'entraînement à l'inférence, avec la surface d'attaque et les limites de l'approche.
- AI Act : définition du système d'IA (article 3, point 1)Ce que l'article 3, point 1 de l'AI Act appelle un système d'IA, ses sept éléments, les quatre familles exclues par la Commission et la méthode pour qualifier un logiciel.
- L'IA actuelle : assistants conversationnels et agentsÉtat des lieux en octobre 2026 des assistants d'IA générative (ChatGPT, Claude, Gemini, Copilot, Vibe, Meta AI, DeepSeek, Grok, modèles ouverts) et des agents qui agissent à leur place, avec ce que cela change pour la sécurité et la manière de les encadrer.
Pages voisines
La citent
- Fine-tuning en IA, définition, usages et limites
- AI Act : définition du système d'IA (article 3, point 1)
Apprentissage automatique et réseaux de neurones, attaques du modèle
Elle cite
- Comment fonctionne l'inférence d'un modèle de langage
- Différence entre IA et LLM : un champ entier, un type de modèle
- Embeddings : vecteurs, recherche sémantique et RAG
- Comment éviter la mémorisation dans un LLM interne
- Comment red teamer un LLM local avant production
- Empoisonnement des données d'affinage d'un LLM local et backdoor
- AI Act : calendrier d'application 2025-2030 et ce qui s'applique déjà
- AI Act : exactitude, robustesse et cybersécurité d'une IA à haut risque (article 15)
- AI Act : gouvernance des données d'entraînement (article 10)
- Confidentialité différentielle pour télémétrie produit