
Comment observer un LLM en production
Comment observer un LLM en production
Section intitulée « Comment observer un LLM en production »Un modèle de langage de grande taille (LLM) en production ne se surveille pas comme une API métier déterministe. La disponibilité et la latence comptent, mais une réponse techniquement réussie peut être factuellement fausse, dangereuse ou devenue médiocre après un changement de corpus, de modèle ou de règle système.
→ Lire l’explication complète de la marmotte
Contrat d’observabilité du LLM
Section intitulée « Contrat d’observabilité du LLM »Le compromis central est brutal : plus on conserve de traces riches, plus on diagnostique vite les dérives ; plus ces traces contiennent de contenu utilisateur, plus on augmente l’exposition aux données sensibles et aux instructions malveillantes. La recommandation est de journaliser systématiquement les métadonnées et les empreintes de contenu, puis d’autoriser la conservation chiffrée d’échantillons complets uniquement pour des flux explicitement classifiés et soumis à une rétention courte.
Avant toute instrumentation, définir trois catégories d’indicateurs :
- les indicateurs de niveau de service, ou SLI (Service Level Indicator) : durée de réponse, taux d’échec, débit, saturation des ressources ;
- les objectifs de niveau de service, ou SLO (Service Level Objective) : par exemple, 99 % des requêtes interactives sous une durée donnée, hors annulation client ;
- les indicateurs de qualité : taux de réponses refusées à tort, citations invalides, réponses hors sujet, échec des outils appelés et score sur un jeu de contrôle stable.
Un tableau de bord qui affiche uniquement la latence moyenne est décoratif. Une moyenne masque une file d’attente qui sature et quelques requêtes très longues. Suivre au minimum les percentiles 50, 95 et 99, séparés par route, modèle, version de consigne système, langue, longueur d’entrée et longueur de sortie. Sans ces dimensions, une régression est visible mais inexpliquée, ce qui est la forme la plus coûteuse de visibilité.
L’horodatage doit provenir d’une source synchronisée et chaque requête doit porter un identifiant de corrélation généré au point d’entrée. Cet identifiant relie passerelle, orchestrateur, moteur d’inférence, recherche documentaire et appel d’outil. Le propager dans les en-têtes et les journaux structurés, sans le dériver d’un identifiant utilisateur. Une corrélation prévisible devient vite un lien de pistage offert avec un nœud papillon.
La rubrique IA traite le choix et l’exposition d’un déploiement local. L’observabilité complète ce socle : elle ne corrige ni un modèle mal choisi ni une architecture réseau ouverte par optimisme.
Latence, erreurs et saturation d’inférence
Section intitulée « Latence, erreurs et saturation d’inférence »Mesurer quatre durées distinctes : attente en file, préparation de la requête, temps jusqu’au premier fragment de réponse, puis durée totale. Le temps jusqu’au premier fragment révèle la réactivité perçue ; la durée totale révèle la consommation réelle. Les fusionner produit un graphique propre et une incapacité remarquable à localiser le problème.
Distinguer les erreurs client, les refus de politique, les dépassements de délai, les indisponibilités du moteur, les erreurs d’outil et les réponses interrompues par le client. Un code de succès du protocole Hypertext Transfer Protocol (HTTP) ne prouve pas qu’une réponse soit exploitable : un flux peut démarrer, émettre trois mots, puis s’interrompre. Le compteur d’échecs doit donc être complété par un compteur de générations incomplètes et par la cause terminale.
La saturation apparaît avant l’indisponibilité : croissance de la file, recul du débit par accélérateur graphique, augmentation du temps au premier fragment et évictions de requêtes. Une alerte sur la seule utilisation processeur ne détecte rien de fiable sur un moteur d’inférence. Les ressources de calcul peuvent sembler calmes pendant que la mémoire dédiée refuse la prochaine requête.
Définir un budget d’erreur séparé pour les appels interactifs et les traitements par lot. Une synthèse nocturne peut attendre ; une réponse dans une interface de support qui arrive après l’abandon utilisateur n’a plus de valeur. Lorsque le budget est consommé, réduire la longueur de sortie, limiter la concurrence ou basculer vers une réponse déterministe. Ajouter des répliques sans contrôler la file déplace parfois le problème avec une grande élégance comptable.
Exemple de métriques et d’alertes Prometheus
Section intitulée « Exemple de métriques et d’alertes Prometheus »Prometheus collecte des métriques numériques exposées par les services. Les libellés doivent rester bornés : modèle, version, route et résultat sont acceptables ; identifiant de session, texte de requête et adresse réseau ne le sont pas. Une cardinalité non bornée transforme la supervision en expérience de combustion spontanée de mémoire.
Deux règles d’alerte couvrent l’essentiel : l’une surveille la part des requêtes en échec, l’autre la durée de génération par version de modèle. Chacune exige que le dépassement dure avant de prévenir quelqu’un.
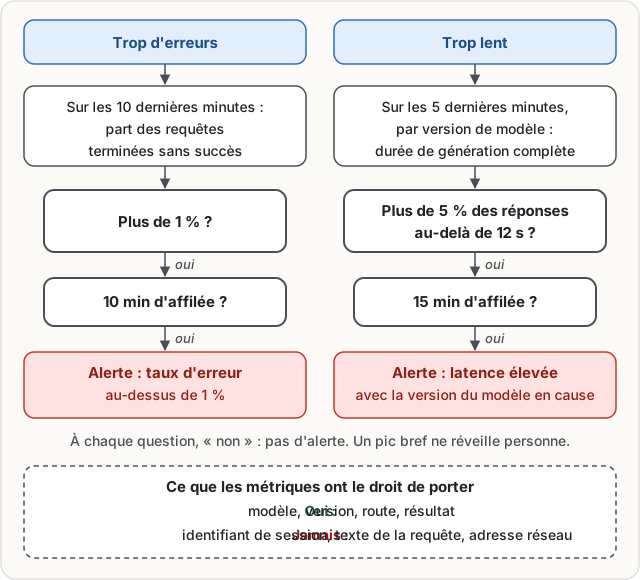
L’instrumentation doit exposer llm_requests_total, llm_generation_seconds_bucket, llm_input_units_total, llm_output_units_total et llm_queue_seconds_bucket. Le mot « units » évite de figer une métrique sur la tokenisation d’un seul fournisseur ou moteur. Changer de modèle peut changer ce comptage sans changer le texte généré.
Dérive de qualité et échantillons contrôlés
Section intitulée « Dérive de qualité et échantillons contrôlés »La dérive de qualité n’est pas une baisse générale détectable par magie. Elle est souvent segmentée : une langue, un domaine documentaire, une catégorie de demande, une nouvelle version d’index ou un connecteur défaillant. Mesurer globalement un score de qualité revient à relever la température moyenne d’un entrepôt et à déclarer la chambre froide conforme.
Conserver un jeu de contrôle versionné, représentatif des tâches critiques, mais distinct des évaluations qui ont autorisé la mise en production. Il sert à comparer chaque jour la version active à une référence fixée. Chaque cas doit comporter une attente vérifiable : présence d’une source autorisée, absence d’information interdite, appel d’outil attendu, format de sortie ou décision de refus.
Pour la recherche augmentée, suivre séparément le taux de récupération documentaire, la fraîcheur des documents, le rang de la première source attendue et le taux de citation réellement étayante. Une réponse peut être fluide tout en s’appuyant sur un document obsolète ou sans rapport. La page sur les embeddings aide à traiter la partie indexation ; elle ne dispense pas de mesurer le résultat final.
Compléter les contrôles automatisés par un échantillonnage humain aveugle, stratifié par risque. Les évaluateurs ne doivent pas connaître la version comparée. Noter l’exactitude, l’utilité, la sûreté et la conformité au format selon une grille stable. Le désaccord entre évaluateurs est une métrique : s’il augmente, le critère est ambigu ou la tâche n’est pas évaluée de façon reproductible.
Déclencher une investigation sur une baisse relative, pas seulement sur un seuil absolu. Une chute de 8 % après modification du corpus mérite une alerte même si le score reste au-dessus du minimum. Les dégradations lentes sont les plus dangereuses : elles ressemblent longtemps à une variabilité normale, puis deviennent une nouvelle norme que personne n’a validée.
Surface d’attaque de la télémétrie LLM
Section intitulée « Surface d’attaque de la télémétrie LLM »Les journaux de requêtes concentrent des secrets, des données personnelles, des documents internes et parfois les consignes système. Une plateforme d’observabilité doit être considérée comme une zone sensible, pas comme une poubelle chiffrée avec interface de recherche.
Ne jamais enregistrer par défaut le texte brut des requêtes et réponses. Produire plutôt une empreinte avec un HMAC (Hash-based Message Authentication Code) utilisant une clé dédiée : elle permet de repérer des répétitions sans exposer le contenu. La clé doit être stockée dans un gestionnaire de secrets, faire l’objet d’une rotation planifiée et être séparée des clés de chiffrement des échantillons.
Les échantillons complets exigent chiffrement au repos, contrôle d’accès par rôle, journalisation des consultations et purge automatique. La suppression doit couvrir les index de recherche, les sauvegardes selon leur politique de rétention, les files d’échec et les exports analytiques. Effacer la table principale puis oublier la file d’événements, c’est classer un incendie parce que le tableau de bord ne fume plus.
Les attaques attendues incluent l’injection d’instructions destinées à faire recopier des secrets dans les traces, l’empoisonnement des métriques par valeurs de libellé infinies, et l’aveuglement par génération massive de requêtes lentes. Limiter la taille des champs, normaliser les libellés, appliquer des quotas par identité et isoler les droits de lecture des traces sont des contre-mesures minimales.
L’observabilité ne garantit pas la confidentialité des conversations, la véracité des réponses ni la détection de toutes les attaques. Ces propriétés dépendent aussi du contrôle d’accès, du filtrage d’entrée, de la gouvernance des données et de la segmentation réseau, sujets couverts par les pages données et architecture cybersécurité.
Exploitation, rétention et reprise
Section intitulée « Exploitation, rétention et reprise »Versionner ensemble le modèle, la consigne système, les outils disponibles, l’index documentaire et le schéma de télémétrie. Sans cette empreinte de configuration, comparer deux périodes n’a pas de sens : on compare des systèmes différents sous la même étiquette.
Tester les alertes par injection contrôlée d’échecs et de lenteur. Une règle jamais déclenchée n’est pas rassurante ; elle est inconnue. Vérifier aussi le chemin complet : collecte, stockage, calcul, notification, acquittement et escalade. Les alertes qui arrivent uniquement dans une messagerie non supervisée ont le statut scientifique d’un post-it dans une cave.
Sauvegarder les règles, tableaux de bord, définitions d’indicateurs et clés de vérification. Les métriques brutes peuvent avoir une rétention courte, mais les agrégats et les résultats de contrôles qualité doivent survivre assez longtemps pour comparer les versions et justifier une décision de retour arrière. Prévoir un mode dégradé : si la plateforme de télémétrie tombe, l’inférence doit continuer avec des compteurs locaux bornés, sans bloquer sur l’export de traces.
🐝 Ce qui arrive si on s’en passe
Section intitulée « 🐝 Ce qui arrive si on s’en passe »Sans observabilité, un moteur d’inférence dégradé continue de renvoyer des codes de succès : les réponses tronquées, les citations d’un document obsolète ou l’appel d’outil détourné par une instruction injectée passent pour du service rendu. Aucun seuil ne se déclenche, et une campagne de requêtes lentes consomme les ressources sans qu’aucune identité soit rattachée à la charge. Lorsqu’un incident finit par être signalé par un utilisateur, l’absence d’identifiant de corrélation et d’empreinte de configuration interdit de reconstituer quelle version du modèle, de la consigne ou de l’index a produit la réponse en cause ; le retour arrière se décide alors à l’intuition, et la preuve qu’une donnée sensible a ou non quitté le système n’existe tout simplement pas.
🦫 Explication de la marmotte 🍫
Section intitulée « 🦫 Explication de la marmotte 🍫 »Un système de génération de texte reçoit une demande, attend parfois son tour, prépare les informations nécessaires, puis produit une réponse. Pour savoir s’il fonctionne, on enregistre le temps d’attente, le temps avant les premiers mots, le temps total et le résultat final. Ces mesures sont regroupées par version du modèle, type de demande et cause d’échec. Cela permet de voir si un changement rend le service plus lent ou plus fragile.
La qualité demande une vérification différente. Un ensemble de questions connues est conservé avec les réponses ou les règles attendues. À intervalles réguliers, le système répond à ces questions et les résultats sont comparés à une référence. Des personnes vérifient aussi un échantillon sans savoir quelle version a produit quelle réponse. Si la qualité baisse pour un sujet précis, la recherche porte sur les documents, les règles données au modèle, les outils appelés ou le modèle lui-même.
Les textes envoyés peuvent contenir des informations privées. Les journaux conservent donc surtout des mesures et des empreintes, pas le contenu complet. Les rares extraits conservés sont chiffrés, protégés par des droits d’accès et supprimés selon une durée fixée. Si la surveillance tombe en panne, le service doit continuer à répondre, tout en gardant des traces locales limitées jusqu’au retour du système de suivi.
À lire aussi
- Gardien IA pour LLM, fonctionnement, exemples et choix de produitCe qu'est un gardien en IA (modèle de garde placé autour d'un LLM), comment il filtre entrées, sorties et actions d'agent, ce qu'il ne garantit pas et quel produit retenir selon l'architecture.
- Fine-tuning en IA, définition, usages et limitesCe qu'est le fine-tuning d'un modèle d'IA, à quoi il sert vraiment, ce qu'il ne garantit pas, sa surface d'attaque et ses conditions d'exploitation.
- Relier FinOps et MLOps pour piloter le coût de l'IA en productionComment articuler FinOps et MLOps en IA pour attribuer, plafonner et contrôler le coût d'un modèle de l'entraînement à l'inférence, avec la surface d'attaque et les limites de l'approche.
- Réduire l’alert fatigue sans perdre la détectionL’alert fatigue survient lorsque le volume et le bruit des alertes rendent la détection des incidents moins fiable.
Pages voisines
La citent
- Fine-tuning en IA, définition, usages et limites
- Gardien IA pour LLM, fonctionnement, exemples et choix de produit
- Comment fonctionne l'inférence d'un modèle de langage
- Connecteurs OAuth des assistants IA, portée et consentements
- Denial of wallet sur une application adossée à une API d'IA
- Déployer Ollama sur un poste de travail et dimensionner la mémoire
- Différence entre IA et LLM : un champ entier, un type de modèle
- Empoisonnement des données d'affinage d'un LLM local et backdoor
- Exfiltration par rendu Markdown dans un chat IA
- Fuite de secrets dans les prompts d'un assistant IA public
Comment observer un LLM en production
Elle cite
: les deux pages se citent l’une l’autre.