
Effacement des données dans une architecture distribuée
Effacement des données dans une architecture distribuée
Section intitulée « Effacement des données dans une architecture distribuée »Le droit à l’effacement ne se réalise pas par un DELETE lancé sur la base principale avec un air satisfait. Dans une architecture distribuée, une donnée personnelle peut survivre dans des réplicas, index, caches, journaux, exports, files de messages et sauvegardes longtemps après sa suppression applicative.
→ Lire l’explication complète de la marmotte
Effacement logique, purge physique et preuve d’exécution
Section intitulée « Effacement logique, purge physique et preuve d’exécution »Le Règlement général sur la protection des données (RGPD) encadre le droit à l’effacement, mais ne fournit pas une topologie de réplication ni un protocole de restauration. L’architecture doit donc transformer une demande validée en opérations techniques traçables, sans prétendre produire ici une interprétation juridique.
Il faut distinguer trois états. L’effacement logique retire la donnée des parcours applicatifs, souvent par un marqueur deleted_at, une désactivation ou une tombstoning. La purge physique retire les octets des stockages actifs. La preuve d’exécution relie une demande, les identifiants concernés, les systèmes ciblés, les erreurs et la date de fin. Confondre ces états fabrique des tableaux de bord verts et des données encore présentes. Le vert est une couleur très accommodante.
La recommandation est nette : traiter l’effacement comme un workflow asynchrone idempotent, piloté par un identifiant de demande immuable. Chaque système détenteur reçoit un ordre de suppression ou de rendu inaccessible, puis accuse réception avec son périmètre réel. L’état terminal ne doit être atteint qu’après convergence des cibles actives et enregistrement d’un traitement séparé pour les sauvegardes.
L’idempotence est obligatoire. Un consommateur peut recevoir deux fois le même événement, redémarrer après l’opération ou traiter les messages dans un ordre différent. Une purge fondée sur une suppression conditionnelle par identifiant stable supporte ces cas. Une séquence qui exige qu’un événement arrive exactement une fois repose sur une promesse que les systèmes distribués n’ont jamais signée.
L’effacement ne garantit pas l’effacement chez un tiers, dans une boîte de réception humaine, dans une capture d’écran ou dans un export téléchargé avant la demande. Ces flux doivent être recensés, limités et contractuellement gouvernés, mais aucune tâche planifiée ne rappelle un fichier déjà copié sur un poste hors contrôle. La gouvernance des données doit définir les responsabilités avant que l’incident ne les invente.
Réplicas, caches et index de recherche
Section intitulée « Réplicas, caches et index de recherche »Une base primaire n’est presque jamais seule. Les réplicas de lecture reçoivent les mutations avec un délai, les moteurs de recherche réindexent selon leur cadence, les caches servent des objets déjà calculés et les entrepôts analytiques consomment des événements différés. Une suppression doit donc porter un identifiant de propagation, une échéance et une liste de classes de stockage.
Un réplica transactionnel finit généralement par recevoir le DELETE, sauf rupture de réplication ou promotion d’un nœud retardataire. Le risque sérieux apparaît lors d’une restauration ou d’un basculement : restaurer un point antérieur à l’effacement peut réintroduire l’enregistrement. Il faut conserver un registre d’effacements, distinct de la base restaurée, puis le rejouer avant de rouvrir le service. Ce registre doit avoir une rétention au moins égale à la fenêtre maximale de restauration.
Les caches posent une autre question. Une clé de cache dérivée d’un identifiant personnel doit être invalidée explicitement lors de l’effacement. Attendre l’expiration du temps de vie n’est acceptable que si ce délai fait partie de l’objectif documenté et si la donnée n’est plus accessible par aucun autre chemin. Les caches partagés, les réseaux de diffusion de contenu et les caches applicatifs en mémoire doivent chacun recevoir leur traitement. Le cache est souvent présenté comme un détail de performance, jusqu’au jour où il devient une base de données clandestine avec une durée de rétention choisie par défaut.
Les index de recherche exigent une suppression par identifiant de document, suivie d’une vérification après rafraîchissement d’index. Une requête de recherche négative ne prouve pas l’absence des termes dans les segments non fusionnés, journaux ou instantanés. Il faut distinguer indisponibilité à la recherche et purge des supports sous-jacents.
Les files de messages sont plus délicates. Un événement historique contenant des données personnelles ne peut pas être retiré sélectivement d’un journal append-only sans réécriture coûteuse ou sans mécanisme de chiffrement par sujet. La meilleure décision est préventive : ne pas publier la donnée personnelle brute dans les événements quand un identifiant interne suffit. Les fondations d’architecture doivent imposer cette minimisation avant que la file ne devienne une archive involontaire.
Sauvegardes et restauration après effacement
Section intitulée « Sauvegardes et restauration après effacement »Une sauvegarde est une copie volontairement conçue pour survivre à une panne, à une corruption et parfois à une erreur humaine. Exiger la suppression immédiate d’un enregistrement dans chaque sauvegarde historique revient souvent à casser les propriétés qui justifient l’existence de la sauvegarde. Le compromis central est là : plus la restauration historique est riche et durable, plus l’effacement physique immédiat coûte cher ou devient impossible.
La position recommandée est de ne pas modifier sélectivement les sauvegardes immuables. Il faut chiffrer les sauvegardes, fixer une durée de rétention bornée, documenter cette fenêtre, puis appliquer le registre d’effacements lors de toute restauration. Cette approche est valide seulement si la restauration passe par une procédure contrôlée, si le registre est disponible hors de la sauvegarde restaurée, et si aucune sauvegarde n’est remise en production sans rejeu.
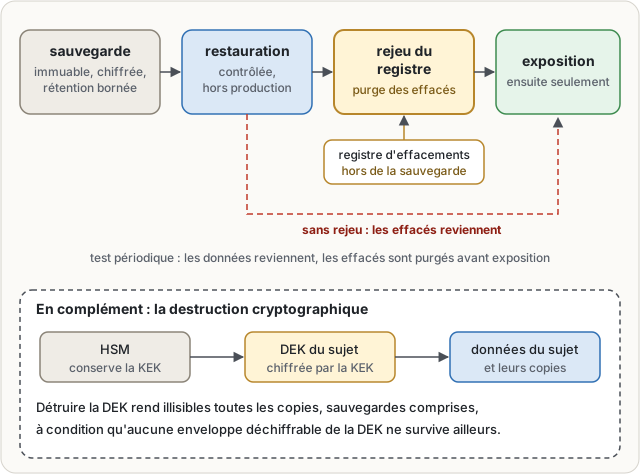
La destruction cryptographique peut réduire la fenêtre d’exposition. Chaque sujet ou groupe réduit de sujets reçoit une clé de chiffrement de données, appelée DEK (Data Encryption Key). Cette DEK est chiffrée par une clé de chiffrement de clés, appelée KEK (Key Encryption Key), conservée dans un HSM (Hardware Security Module), ou module matériel de sécurité. Détruire la DEK rend les copies chiffrées illisibles, y compris dans des sauvegardes qui ne peuvent pas être réécrites.
Cette technique n’est pas magique. Une clé par ligne augmente les métadonnées, les appels au HSM et les contraintes de rotation. Une clé par tenant rend l’effacement individuel impossible sans réécriture. Une DEK conservée dans une sauvegarde avec son enveloppe encore déchiffrable ne détruit rien du tout. Le chiffrement de disque ne suffit pas non plus : la clé protège le volume entier, pas l’enregistrement visé. Pour ces frontières, consulter chiffrement et gestion des clés évite de confondre verrouillage du support et contrôle d’accès aux données.
Les sauvegardes doivent être testées par restauration périodique. Le test doit vérifier deux propriétés : les données attendues reviennent, les identifiants effacés sont purgés par le registre avant exposition. Tester seulement que l’archive se décompresse est du théâtre opérationnel, avec davantage de stockage.
Exemple reproductible : registre d’effacement PostgreSQL
Section intitulée « Exemple reproductible : registre d’effacement PostgreSQL »L’exemple suivant utilise PostgreSQL pour séparer la suppression de la donnée active du registre nécessaire aux restaurations. Il ne couvre pas les index, caches ni systèmes externes : chacun doit consommer le même identifiant de demande.
-- Table métier : la purge retire la ligne active.CREATE TABLE customer (  customer_id UUID PRIMARY KEY,  email TEXT NOT NULL,  created_at TIMESTAMPTZ NOT NULL DEFAULT now());
-- Registre hors du jeu de données restauré.-- Ne pas y conserver l'adresse électronique ou le profil complet.CREATE TABLE erasure_registry (  request_id UUID PRIMARY KEY,  subject_id UUID NOT NULL,  requested_at TIMESTAMPTZ NOT NULL DEFAULT now(),  completed_at TIMESTAMPTZ,  status TEXT NOT NULL CHECK (status IN ('pending', 'completed', 'failed')));
-- Transaction idempotente : rejouable sans recréer de donnée.BEGIN;
DELETE FROM customerWHERE customer_id = '11111111-1111-1111-1111-111111111111';
INSERT INTO erasure_registry (request_id, subject_id, status, completed_at)VALUES (  '22222222-2222-2222-2222-222222222222',  '11111111-1111-1111-1111-111111111111',  'completed',  now())ON CONFLICT (request_id) DO NOTHING;
COMMIT;
-- Après restauration d'une sauvegarde, rejouer les suppressions enregistrées.DELETE FROM customer AS cUSING erasure_registry AS eWHERE c.customer_id = e.subject_id  AND e.status = 'completed';
Le registre ne doit pas devenir une base de profils résiduels. Il contient le minimum permettant de supprimer à nouveau, idéalement un identifiant technique non réutilisable. Si l’identifiant lui-même permet une réidentification dans un autre système, son accès, sa rétention et son chiffrement doivent être traités comme ceux d’une donnée personnelle.
Surface d’attaque et conditions d’exploitation
Section intitulée « Surface d’attaque et conditions d’exploitation »Le premier risque est la réintroduction par restauration. Une sauvegarde restaurée hors procédure, dans un environnement de test ou d’analyse, contourne le rejeu du registre. La contre-mesure est organisationnelle et technique : restaurations uniquement via un outillage qui applique automatiquement les effacements, droits d’accès restreints, journalisation et contrôle des environnements non productifs.
Le second risque est l’effacement malveillant. Un attaquant qui obtient le droit de soumettre ou valider des demandes peut détruire des données critiques et transformer la conformité en outil de sabotage. Il faut séparer demande, validation et exécution, journaliser les décisions, imposer une authentification forte et prévoir une fenêtre de suspension avant purge irréversible. Cette fenêtre ne doit pas laisser la donnée accessible : l’effacement logique intervient immédiatement.
Le troisième risque est la fuite par observabilité. Les journaux applicatifs, traces distribuées et rapports d’erreur capturent volontiers des adresses, identifiants ou charges de requêtes. Une règle de masquage à l’ingestion réduit le problème, mais n’efface pas l’historique déjà collecté. Les politiques de rétention des journaux doivent donc être bornées et les accès surveillés. Les menaces et contrôles d’architecture aident à poser ces flux dans le modèle de menace, plutôt qu’à les découvrir pendant une recherche d’incident.
Enfin, la supervision doit mesurer le délai entre demande validée et convergence par classe de stockage, le nombre de cibles en erreur, les restaurations ayant nécessité un rejeu et les sauvegardes arrivant à expiration. Une alerte sur une purge bloquée vaut plus qu’un indicateur global de conformité. Le mot conformité n’a jamais réparé une réplication cassée.
🐝 Ce qui arrive si on s’en passe
Section intitulée « 🐝 Ce qui arrive si on s’en passe »Sans workflow d’effacement propagé, chaque copie résiduelle reste lisible par tous les comptes qui accèdent aux stockages secondaires (réplicas de lecture, entrepôts analytiques, index), dont les contrôles d’accès sont souvent moins stricts que ceux de la base primaire : la suppression applicative ne réduit donc pas la population capable de lire la donnée. Si un identifiant de sujet est un jour réattribué, une entrée de cache ou d’index non invalidée peut servir les informations de la personne effacée au nouveau titulaire de cet identifiant. En cas de compromission d’un stockage secondaire ou d’une sauvegarde, le périmètre exposé inclut des personnes dont l’effacement avait été acté ; faute de registre, il devient impossible d’établir lesquelles, ce qui empêche une évaluation exacte de l’incident et des notifications fondées sur des faits vérifiables.
🦫 Explication de la marmotte 🍫
Section intitulée « 🦫 Explication de la marmotte 🍫 »Quand une personne demande l’effacement de ses données, le service doit d’abord vérifier que la demande est recevable. Il crée ensuite un numéro de suivi et retire les données du service visible. Cette première action empêche leur affichage, mais ne suffit pas : les mêmes informations peuvent exister dans plusieurs copies.
Chaque copie active doit recevoir l’ordre de suppression. Cela concerne les bases de données secondaires, les moteurs qui permettent de rechercher du texte, les mémoires temporaires et les systèmes qui reçoivent des messages plus tard. Chaque système renvoie un résultat : supprimé, déjà absent ou en échec. Une demande ne doit pas être considérée comme terminée tant que les erreurs ne sont pas traitées.
Les sauvegardes posent un cas différent. Elles servent à remettre le service en état après une panne et ne sont pas toujours modifiables une par une. Il faut donc conserver une liste séparée des personnes effacées. Si une ancienne sauvegarde est restaurée, cette liste est appliquée avant de rendre les données accessibles, afin de supprimer à nouveau les informations revenues avec la restauration.
Le chiffrement peut aussi aider : les données sont rendues illisibles si la clé qui permet de les lire est détruite. Cela fonctionne seulement si chaque personne possède une clé suffisamment séparée des autres. Enfin, il faut surveiller les échecs, protéger le droit de demander un effacement contre les abus et éviter que les journaux techniques conservent les informations supprimées.
À lire aussi
- Cycle de vie de la donnée de la collecte à la destruction prouvéeConcevoir le cycle de vie d’une donnée, depuis sa collecte contrôlée jusqu’à sa destruction vérifiable et prouvée.
- Pourquoi supprimer un fichier ne l'efface pasSupprimer un fichier retire souvent sa référence, mais ne détruit ni ses blocs, ni ses copies, ni les clés qui peuvent encore le rendre lisible.
- Classifier les données avant de les protégerLa classification des données permet de décider quelles protections appliquer, où les appliquer et ce qu’elles ne couvrent pas.
- Résidence des données et souveraineté cloudRésidence des données et souveraineté : distinguer la localisation réelle des données, le contrôle technique et les dépendances juridiques.
Pages voisines
La citent
- Cycle de vie de la donnée de la collecte à la destruction prouvée
- Pourquoi supprimer un fichier ne l'efface pas
- Comment minimiser la collecte de données sensibles
- Gouvernance d'un data lake et copie des données
- Déployer Qdrant local pour recherche sémantique interne
- Fine-tuning en IA, définition, usages et limites
- L'effacement impossible
- Principes et architecture de l'événementiel
- Quand la recherche sémantique contourne les droits
- Rétention des données envoyées à une API d'IA générative
Effacement des données dans une architecture distribuée
Elle cite
: les deux pages se citent l’une l’autre.