
FinOps Framework : responsabilité partagée des dépenses cloud et IA
FinOps Framework : responsabilité partagée des dépenses cloud et IA
Section intitulée « FinOps Framework : responsabilité partagée des dépenses cloud et IA »Le FinOps Framework de la FinOps Foundation propose une méthode pour rendre chaque équipe responsable de ce que coûte la technologie qu’elle consomme. Il ne s’agit ni d’un outil ni d’une norme certifiable : c’est un modèle opérationnel qui fixe qui décide, qui paie et qui optimise. Pour un architecte, il compte surtout pour ses effets de bord. Une optimisation de coût mal cadrée supprime d’abord ce qui ne produit aucun chiffre d’affaires visible : les journaux, la redondance et la marge de capacité.
→ Lire l’explication complète de la marmotte
FinOps Framework 2026 : périmètres, domaines, capacités et personas
Section intitulée « FinOps Framework 2026 : périmètres, domaines, capacités et personas »FinOps (Financial Operations) désigne, selon la FinOps Foundation (projet de la Linux Foundation), un cadre opérationnel et une pratique culturelle qui maximisent la valeur métier de la technologie, permettent des décisions rapides fondées sur les données et créent une responsabilité financière par la collaboration entre ingénierie, finance et métier. La version en vigueur à la rédaction de cette page est le FinOps Framework 2026, présenté par la Fondation le 19 mars 2026. Le cadre est révisé chaque année, en mars : on vérifie la page du Framework sur finops.org avant d’en citer la structure dans un document contractuel.
Le Framework s’organise autour de cinq éléments :
- Les périmètres (Scopes). Un périmètre est un segment de dépenses technologiques auquel on applique la pratique, rattaché à une construction métier (produit, centre de coûts, environnement). Le cloud public, le SaaS (Software as a Service), les licences, le cloud privé, le centre de données, les plateformes de données et l’IA en sont des exemples, et chaque organisation définit les siens. Ajoutés en 2025, approfondis en 2026, ils expliquent que le cadre ne se limite plus à la facture d’un hyperscaler.
- Quatre domaines. Understand Usage & Cost regroupe l’ingestion des données, l’allocation, le reporting et la gestion des anomalies. Quantify Business Value couvre la planification, la prévision, le budget, les KPI (Key Performance Indicators) et l’économie unitaire. Optimize Usage & Cost traite l’architecture et le placement des charges, l’optimisation de l’usage et des tarifs, les licences et le SaaS, la durabilité. Manage the FinOps Practice porte la gouvernance, la politique et le risque, la formation, la refacturation et l’évaluation de la pratique.
- Une vingtaine de capacités, réparties dans ces domaines. Chacune se décrit en trois niveaux de maturité : Crawl, Walk, Run. La révision 2026 ajoute Executive Strategy Alignment dans le dernier domaine (relier la dépense technologique à la stratégie et aux priorités de la direction) et renomme deux capacités pour qu’elles valent pour tous les périmètres, pas seulement le cloud : Usage Optimization et Governance, Policy & Risk.
- Des personas. Les personas cœur sont engagés dans toute pratique : le praticien FinOps, l’ingénierie, la finance, la direction, les achats et le produit. Les personas alliés regroupent des disciplines voisines (gestion des actifs IT, gestion financière IT, gestion des services IT, sécurité, durabilité) avec lesquelles la pratique doit s’articuler plutôt que de les ignorer.
- Les principes. Six, dont celui qui structure tout le reste : chacun prend la responsabilité de son usage de la technologie.
Le cycle se déroule en trois phases (Inform, Optimize, Operate). Le format de données associé, FOCUS (FinOps Open Cost and Usage Specification), normalise les exports de facturation entre fournisseurs. Sans lui, on rapproche à la main des colonnes qui portent le même nom et pas le même sens.
Le cadre est descriptif. Il dit quelles capacités existent, il n’impose aucun seuil, aucun contrôle et aucun audit. Un référentiel sans contrôle finit volontiers dans un tableur de maturité colorié avec soin une fois par an.
Responsabilité partagée des dépenses : qui décide, qui paie, qui optimise
Section intitulée « Responsabilité partagée des dépenses : qui décide, qui paie, qui optimise »Le cœur du cadre est un déplacement de la décision. L’ingénieur qui choisit une taille d’instance, une rétention de journaux ou un modèle de langage engage une dépense au moment même où il déploie. La finance ne la découvre qu’à la facture. FinOps rapproche ces deux moments : les données de coût remontent vers ceux qui consomment, et les engagements tarifaires remontent vers ceux qui achètent.
Le schéma montre les flux entre personas. L’élément décisif est l’absence de flèche directe entre le praticien FinOps et la suppression d’une ressource.
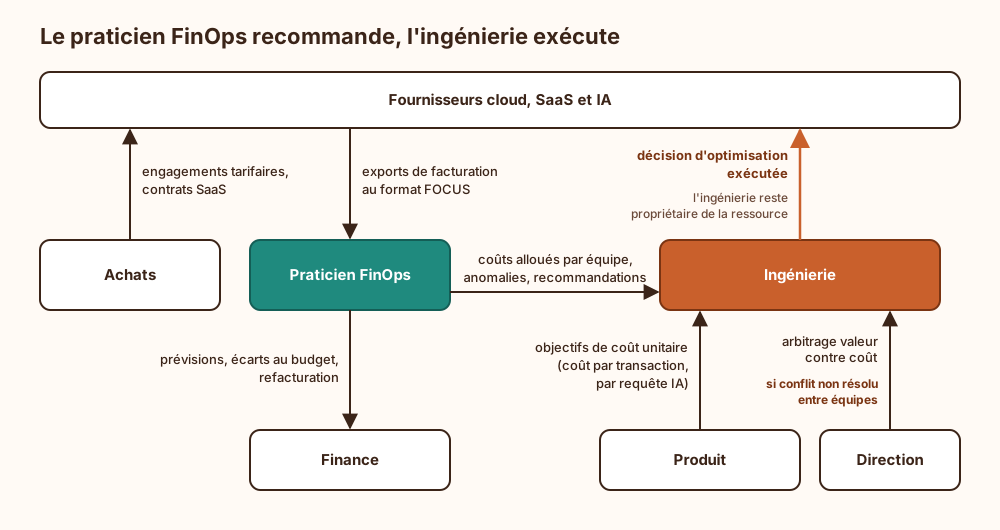
La règle à retenir est la suivante : le praticien FinOps informe et recommande, et l’équipe propriétaire décide et exécute. Dès que l’équipe centrale reçoit le droit de supprimer elle-même ce qu’elle juge inutile, la responsabilité partagée devient une responsabilité diluée. Elle devient aussi un compte à hauts privilèges supplémentaire, ce qui ressemble moins à de la gouvernance.
Prérequis : ce que la pratique FinOps coûte à tenir
Section intitulée « Prérequis : ce que la pratique FinOps coûte à tenir »Le cadre se présente comme une démarche culturelle. En pratique, il repose sur un socle technique qui doit exister avant la première revue de coûts :
- Allocation fiable. Il faut une convention de balisage (tags ou labels) appliquée par politique au moment de la création, et pas corrigée après coup. Elle s’appuie sur une hiérarchie de comptes, d’abonnements ou de projets qui reflète la structure de responsabilité. Les guides AWS Well-Architected et Microsoft Cloud Adoption Framework décrivent cette structuration côté fournisseur. Un tag facultatif est, dans les faits, un tag absent sur une bonne part des ressources.
- Ingestion des données de facturation. On exporte les données vers un entrepôt, en FOCUS quand le fournisseur le propose. On les complète par les données d’usage SaaS, souvent disponibles seulement en CSV mensuel. Il faut aussi les compteurs d’IA (jetons, heures GPU, Graphics Processing Unit), dont la granularité varie d’un fournisseur à l’autre.
- Coûts partagés. Il faut décider comment répartir le réseau, le support, la plateforme Kubernetes et la sécurité elle-même. Sans règle écrite, chaque équipe conteste la clé de répartition, et c’est le seul sujet sur lequel la pratique produit alors un consensus rapide.
- Un praticien identifié. La capacité FinOps Practice Operations suppose quelqu’un dont c’est le métier, et pas une ligne de plus dans la fiche de poste de l’architecte.
Le compromis central se formule ainsi. On gagne une décision de dépense prise par ceux qui en maîtrisent la cause technique. On paie un entrepôt de données de facturation, une discipline de balisage imposée à toutes les équipes et un temps d’animation récurrent. Ce coût ne se justifie que si la dépense variable est assez élevée et assez dispersée pour que l’allocation change des décisions. Avec deux comptes et une facture stable, un budget avec alerte suffit, et le cadre complet relève de la cérémonie. Le raisonnement rejoint celui du coût total de possession d’un contrôle.
Optimisation de coût contre sécurité : journaux, redondance, marge
Section intitulée « Optimisation de coût contre sécurité : journaux, redondance, marge »Une optimisation de coût attaque d’abord ce qui consomme sans produire de fonctionnalité visible. En sécurité, c’est précisément la définition d’un contrôle. Les recommandations automatiques des outils FinOps et des fournisseurs ne voient qu’un taux d’usage. Elles ne savent pas qu’une ressource inactive est un secours ni qu’un volume de journaux est une obligation de rétention.
Les cibles classiques, avec ce qu’elles emportent :
- Journalisation. Plusieurs postes sont visés : la réduction de la rétention des journaux d’audit, la désactivation des événements de données (lecture d’objets, accès aux secrets), l’échantillonnage des journaux de flux réseau ou le filtrage à l’entrée du SIEM (Security Information and Event Management) pour réduire le volume facturé. Chaque coupe réduit la fenêtre d’investigation. Un journal supprimé avant la détection d’une intrusion ne se reconstitue pas. Or le délai entre compromission et détection peut se compter en semaines, alors que les rétentions « optimisées » se comptent parfois en jours.
- Redondance. Plusieurs mesures relèvent de la même logique : le passage d’un déploiement multi-zones à une seule zone, l’arrêt de la réplication inter-régions, la suppression des instances de secours « inactives » ou le raccourcissement de la rétention des sauvegardes. Le RPO (Recovery Point Objective) et le RTO (Recovery Time Objective) se dégradent sans que personne ne les ait renégociés. Pour une entité soumise à DORA, réduire une capacité de reprise sans réévaluer le plan de continuité revient à modifier un engagement réglementaire par un ticket d’optimisation.
- Marge de capacité. Le redimensionnement agressif retire la réserve qui absorbe un pic, y compris un déni de service. Les instances préemptibles (spot) conviennent à du calcul interruptible, pas à un relais d’authentification.
- Engagements tarifaires. Un engagement sur trois ans fige une famille d’instances ou une région. Il rend coûteuse une migration rendue nécessaire par un correctif de sécurité, une contrainte de souveraineté ou un changement de fournisseur.
- Chiffrement. La consolidation des clés KMS (Key Management Service) pour réduire le coût par clé revient à élargir le rayon d’impact d’une clé compromise et à fusionner des périmètres de révocation.
La règle d’architecture qui en découle tient en une phrase : les contrôles de sécurité et de résilience constituent un plancher déclaré, et pas une variable d’ajustement. Concrètement, on balise ces ressources (par exemple avec un tag de classe « contrôle »), on les exclut des remédiations automatiques et on soumet toute recommandation qui les touche à une revue sécurité. Le domaine Optimize Usage & Cost n’interdit rien de tout cela. Il n’en parle pas non plus.
Le flux inverse existe aussi, et il est favorable : FinOps rend des services à la sécurité. La détection d’anomalies de coût repère le minage de cryptomonnaie sur un compte compromis ou une clé d’API d’IA (Intelligence Artificielle) volée et consommée par un tiers. L’allocation fait apparaître l’informatique fantôme. Le balisage obligatoire sert d’inventaire d’actifs. La page gouverner les coûts cloud contre un compte compromis traite ce volet détectif et ses limites de latence.
Surface d’attaque de l’outillage FinOps
Section intitulée « Surface d’attaque de l’outillage FinOps »Une pratique FinOps outillée crée trois expositions nouvelles :
- Rôles de lecture inter-comptes. Les plateformes FinOps tierces demandent un rôle IAM (Identity and Access Management) en lecture sur toute l’organisation. « Lecture » inclut souvent la configuration complète : groupes de sécurité, politiques, noms de ressources, parfois des métadonnées sensibles. Contre-mesure : un rôle limité aux exports de facturation et aux API de coût, avec un identifiant externe pour empêcher l’usurpation par un tiers (confused deputy) et une revue dans le cadre de la gestion des risques tiers.
- Données de facturation. Un export de coûts révèle la cartographie de l’infrastructure, les volumes par service, les projets non annoncés et les fournisseurs d’IA retenus. Contre-mesure : un entrepôt dédié, un accès par rôle et le même niveau de classification que les schémas d’architecture.
- Remédiation automatique. Les scripts qui arrêtent ou suppriment les ressources « orphelines » détiennent des droits destructeurs sur toute l’organisation. Compromis, ce compte devient un outil de sabotage parfaitement légitime dans les journaux. Contre-mesure : pas de suppression automatique, seulement l’arrêt ou le balisage, avec suppression par l’équipe propriétaire après un délai de grâce. Les ressources balisées « contrôle » sont exclues par une politique de refus au niveau de l’organisation, et pas par une convention.
Ce que le FinOps Framework ne garantit pas
Section intitulée « Ce que le FinOps Framework ne garantit pas »- Aucune maîtrise des coûts en temps réel. Les données de facturation arrivent avec des heures, parfois des jours de retard. Une clé d’API d’IA exfiltrée génère une dépense bien avant la première alerte. Le garde-fou préventif relève des quotas, des limites de débit et des plafonds côté fournisseur, pas du cadre.
- Aucune exigence de sécurité. Le cadre ne fixe ni rétention minimale, ni niveau de redondance, ni contrôle d’accès à ses propres outils. Ces exigences viennent de la politique de sécurité, de l’analyse de risque et des textes applicables.
- Aucune conformité. Une maturité Run sur toutes les capacités ne démontre rien à un auditeur NIS 2 ou DORA.
- Aucune vérité sur la valeur. L’économie unitaire mesure un coût par unité choisie. Si l’unité est mal choisie, on optimise avec rigueur un indicateur sans rapport avec le métier, travers décrit dans mesurer la sécurité : indicateurs utiles ou façade.
- Aucune allocation exacte des coûts partagés. La répartition reste une convention, donc un objet de négociation.
Exemple : revue d’une recommandation d’optimisation touchant journaux ou redondance
Section intitulée « Exemple : revue d’une recommandation d’optimisation touchant journaux ou redondance »Ce flux montre la règle de décision à mettre en place pour qu’une recommandation de coût ne supprime pas un contrôle sans qu’on le sache. Il faut y lire deux choses : la porte de revue déclenchée par le balisage, et le fait que l’arbitrage final revient à la direction quand sécurité et budget s’opposent.
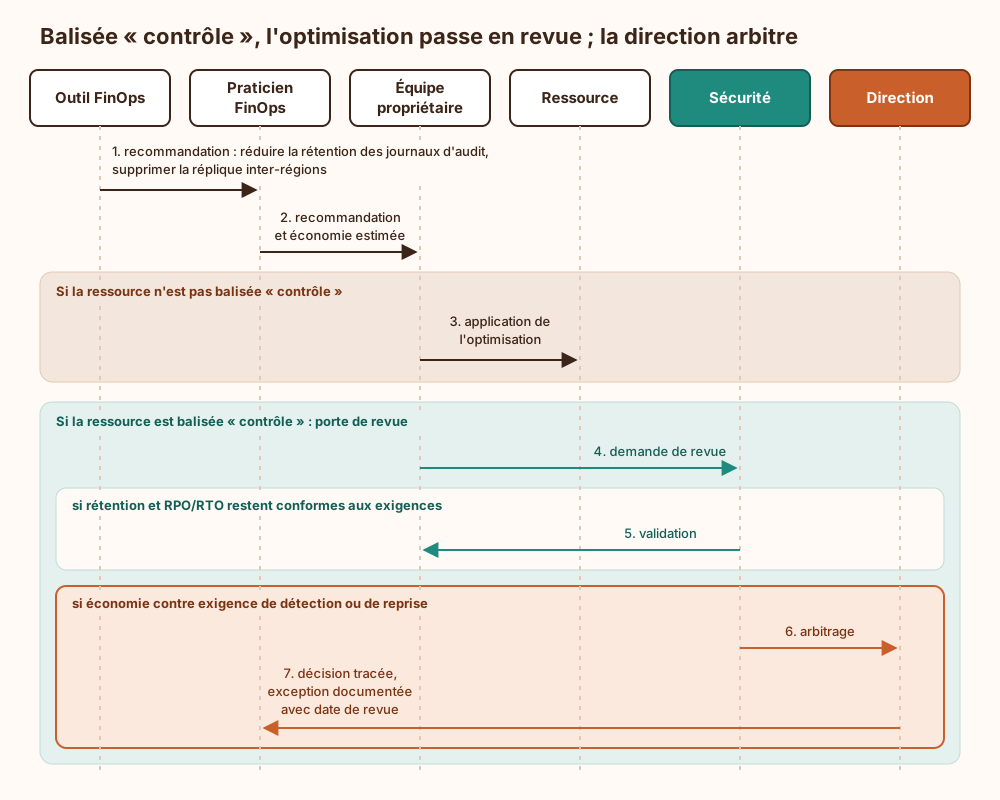
Trois règles rendent ce flux opérant. Le balisage « contrôle » est imposé par politique à la création, sinon la porte ne se déclenche jamais. Chaque refus d’optimisation est enregistré avec son coût : la sécurité devient alors une dépense visible et argumentée, ce qui sert directement à justifier le budget sécurité devant la direction financière. Enfin, l’exception porte une date de revue, faute de quoi elle devient permanente par oubli plutôt que par décision.
Exploitation d’une pratique FinOps : secrets, supervision, reprise
Section intitulée « Exploitation d’une pratique FinOps : secrets, supervision, reprise »- Secrets et accès. Les identifiants des connecteurs de facturation (SaaS, fournisseurs d’IA) sont des secrets de production. On les place en coffre, avec une rotation alignée sur celle des autres comptes de service. Les rôles inter-comptes font l’objet d’une revue au moins trimestrielle et d’une alerte sur toute modification de politique.
- Supervision. Les alertes d’anomalies de coût sont routées vers l’équipe propriétaire et en copie vers le centre de supervision sécurité, puisqu’une partie d’entre elles signale une compromission. On surveille aussi les signaux inverses : une chute brutale de volume de journaux ou de trafic de réplication est un incident, même quand elle fait baisser la facture.
- Sauvegarde et reprise. L’entrepôt de données de facturation alimente les prévisions et la refacturation. On sauvegarde les exports bruts, car les fournisseurs ne conservent pas tous l’historique détaillé indéfiniment. Les engagements tarifaires et les contrats SaaS font partie du plan de reprise : basculer vers une autre région peut faire perdre la couverture d’un engagement et doubler le coût du site de secours.
- Cadence. Le cycle Inform / Optimize / Operate n’a de sens que s’il tourne. On prévoit une revue mensuelle par équipe, une revue trimestrielle des engagements et une mise à jour annuelle face à la version du cadre en vigueur.
- FinOps Framework 2026, FinOps Foundation, mars 2026
- FinOps Open Cost and Usage Specification (FOCUS), FinOps Foundation.
- Règlement (UE) 2022/2554 (DORA).
- Directive (UE) 2022/2555 (NIS 2).
🐝 Ce qui arrive si on s’en passe
Section intitulée « 🐝 Ce qui arrive si on s’en passe »Sans responsabilité partagée, la dépense reste un total que personne ne relie à une décision technique. La finance l’arbitre alors de loin, par coupes uniformes, et ces coupes tombent sur ce qui paraît inactif : répliques de secours, rétention de journaux, marge de capacité. La capacité de reprise baisse sans révision du plan de continuité. La fenêtre d’investigation se réduit sans que la sécurité soit consultée. Côté détection, l’absence d’allocation et d’alerte d’anomalie laisse une consommation frauduleuse (minage sur un compte compromis, clé d’IA exploitée par un tiers) se confondre avec la croissance normale jusqu’à la facture suivante. L’inventaire perd aussi le balisage qui permettait de rattacher une ressource à son propriétaire au moment d’un incident.
🦫 Explication de la marmotte 🍫
Section intitulée « 🦫 Explication de la marmotte 🍫 »Une entreprise loue des ordinateurs à distance, des logiciels payés à l’abonnement et des services d’intelligence artificielle. Chaque fois qu’un développeur lance une machine ou envoie une question à une intelligence artificielle, l’entreprise paie, et la facture arrive plus tard. La démarche décrite ici s’appelle FinOps. Elle commence par coller une étiquette sur chaque ressource pour savoir quelle équipe l’utilise. Ensuite, les factures sont récupérées automatiquement et rangées équipe par équipe. Chaque équipe voit alors ce qu’elle dépense et décide elle-même où réduire. La finance prévoit le budget, les acheteurs négocient les prix et la direction tranche quand deux équipes ne sont pas d’accord. Le danger vient des économies faciles : effacer plus tôt les journaux qui enregistrent qui a fait quoi, ou supprimer la copie de secours d’un serveur. La facture baisse, mais si un pirate entre, il n’y a plus de traces pour comprendre ce qu’il a fait. Si une panne arrive, il n’y a plus de serveur de secours pour redémarrer. C’est pourquoi on marque ces protections d’une étiquette spéciale, et toute idée d’économie qui les touche doit passer par l’équipe sécurité. Il faut aussi limiter les droits de l’outil qui lit les factures : s’il pouvait tout supprimer et qu’il était piraté, il deviendrait une arme. Enfin, les factures arrivent en retard : elles ne bloquent jamais une dépense à temps, elles la constatent après coup.
À lire aussi
- COBIT 2019 gouvernance informatique : objectifs et capacitéCOBIT 2019 pour gouverner l'informatique d'entreprise, avec ses 40 objectifs de gouvernance et de gestion, ses facteurs de conception et ses niveaux de capacité.
- ITIL : incidents, changements et problèmes vus de la sécuritéITIL (Version 5) et ITIL 4 vus de l'architecture et de la sécurité, du cycle de vie d'un service à la gestion des incidents, des changements et des problèmes.
- IT4IT 3.0 : flux de valeur et modèle de données de la DSIComprendre IT4IT 3.0, le modèle opérationnel du numérique de The Open Group, avec ses sept flux de valeur autour du produit numérique, son modèle de référence fonctionnel et son modèle de données.
- TOGAF et méthode ADM : architecture d'entreprise en pratiqueTOGAF appliqué à l'architecture d'entreprise, avec la méthode ADM, les vues métier, données, applications et technologie, les feuilles de route de transition et la gouvernance d'architecture.
Pages voisines
FinOps Framework : responsabilité partagée des dépenses cloud et IA
Elle cite
- AWS Well-Architected Framework : piliers, revue et limites
- Microsoft Cloud Adoption Framework : phases, landing zones, limites
- Calculer le coût total de possession d'un contrôle de sécurité
- Gérer les risques tiers et la chaîne logicielle
- Justifier un budget sécurité à la direction financière
- Quels indicateurs mesurer pour la sécurité
- Comment gouverner les coûts cloud contre un compte compromis
- DORA et résilience opérationnelle numérique financière