
Pipeline
Infrastructure
Chaîne d'étapes exécutées automatiquement et dans un ordre fixé, où la sortie de chaque étape devient l'entrée de la suivante. Le terme désigne aussi bien la chaîne qui construit, teste et livre du code que le traitement de données ou l'exécution des instructions dans un processeur.
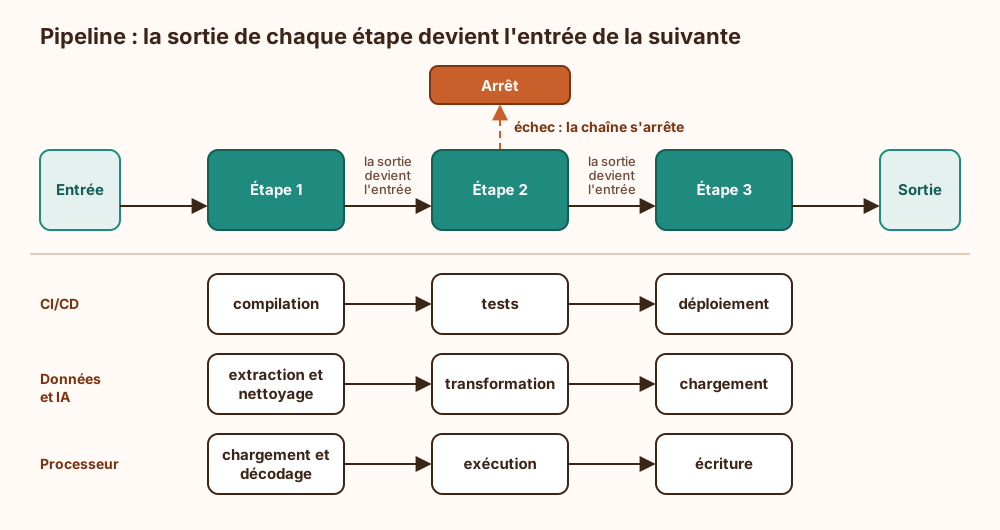
Principe : Chaque étape fait une seule chose : elle reçoit un résultat, le transforme, puis le transmet. Si une étape échoue, la chaîne s'arrête, ce qui évite de livrer un artefact à moitié construit.
Pipeline CI/CD : À chaque commit, le code passe automatiquement par la compilation, les tests, l'analyse puis le déploiement. Les étapes sont décrites en code, souvent en YAML, et versionnées avec l'application : le fichier qui décide de ce qui part en production a donc exactement le même statut qu'un fichier de traduction, et bien moins de relecteurs.
Données et IA : Un pipeline de données extrait, nettoie, transforme et charge les informations vers leur destination. En IA, il enchaîne le prétraitement, l'inférence du modèle et le post-traitement des résultats.
Processeur : Le pipeline d'instructions découpe l'exécution en étages (chargement, décodage, exécution, écriture). Plusieurs instructions avancent ainsi en même temps, chacune à un étage différent.
Ce qui arrive si on s'en passe
Sans pipeline, chaque étape (compilation, tests, analyse, livraison) repose sur une exécution manuelle : rien n'empêche d'en sauter une, de l'exécuter dans le désordre ou de livrer un artefact qui n'a jamais été testé. La sortie d'une étape n'étant plus transmise automatiquement à la suivante, rien ne garantit que le code livré soit celui qui a été vérifié ; un binaire construit sur un poste local peut atteindre la production sans aucun contrôle. Les vérifications de sécurité (analyse des dépendances, recherche de secrets dans le code) ne s'appliquent plus de façon systématique et ne bloquent plus une livraison fautive. La traçabilité disparaît aussi : aucun journal ne relie une version déployée à son commit ni à ses résultats de tests, ce qui ralentit l'analyse d'un défaut et rend incertaine la reconstruction à l'identique d'une version antérieure.
Explication de la marmotte
Imagine une chaîne de fabrication de sandwichs. Une première personne coupe le pain, la deuxième ajoute le jambon, la troisième met la salade, la dernière emballe. Chacune ne fait qu'une tâche, puis passe le sandwich à la suivante. Pendant que la dernière emballe, la première coupe déjà le pain du sandwich d'après : tout le monde travaille en même temps. Si quelqu'un remarque un pain moisi, on arrête tout avant que le sandwich arrive chez le client. En informatique, c'est pareil : un programme découpe un gros travail en étapes qui s'enchaînent toutes seules, et chaque étape transmet son résultat à la suivante.
Où ce terme est utilisé
- CICD-SEC-4 : exécution de pipeline empoisonnée (21 occurrences)
- OIDC pour sécuriser les identifiants CI/CD (20 occurrences)
- Intégration continue avec Git : automatiser vos workflows (17 occurrences)
- OWASP Top 10 CI/CD : les dix risques de la chaîne de livraison (15 occurrences)
- Sécuriser un monorepo avec des permissions fines (15 occurrences)
- Réconcilier inventaire IaC et cloud réel (14 occurrences)
- CICD-SEC-5 : contrôles d'accès du pipeline insuffisants (13 occurrences)
- Les secrets dans les dépôts Git (13 occurrences)
- Protéger les branches Git et permissions entreprise (13 occurrences)
- AI Act : gouvernance des données d'entraînement (article 10) (12 occurrences)