
Kubernetes
Infrastructure
Orchestrateur de conteneurs open source, né chez Google en 2014 et confié à la CNCF depuis 2015 : on lui décrit l'état voulu d'une application (nombre de copies, ressources, exposition réseau) et il fait converger en permanence un groupe de machines vers cet état.
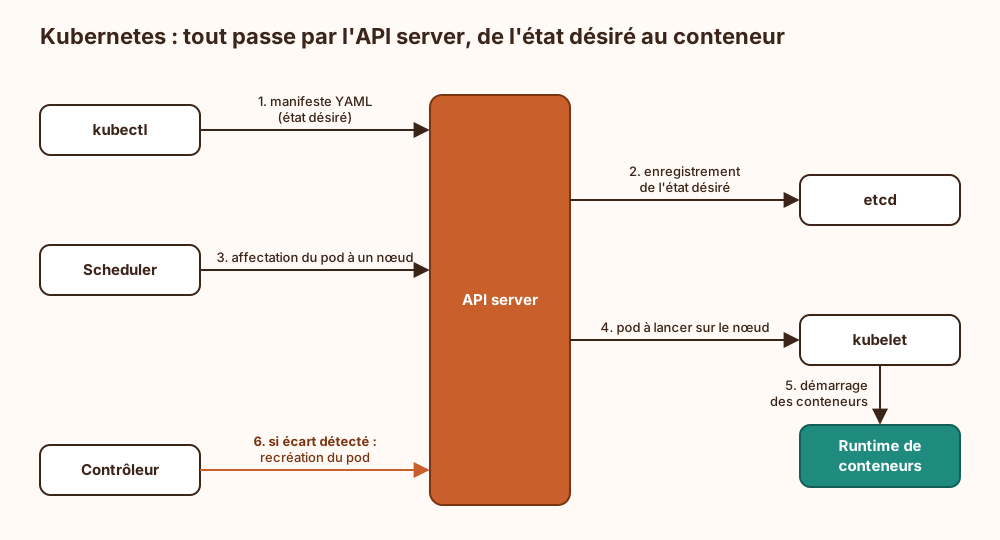
Déclaratif : On écrit des manifestes YAML qui décrivent le résultat attendu, pas la procédure pour y arriver. Des boucles de contrôle comparent sans arrêt l'existant à la cible et corrigent l'écart : un pod qui tombe est recréé sans intervention humaine.
Plan de contrôle et nœuds : Le plan de contrôle (API server, etcd, scheduler, contrôleurs) décide et mémorise l'état du cluster. Les nœuds de travail exécutent les pods grâce au kubelet et à un runtime de conteneurs comme containerd.
Briques de base : Le pod regroupe un ou plusieurs conteneurs qui partagent réseau et stockage ; le Deployment gère le nombre de répliques et les mises à jour progressives ; le Service offre une adresse stable devant des pods par nature jetables.
Coût d'entrée : Kubernetes règle des problèmes de flotte, pas ceux de trois conteneurs posés sur un seul serveur. Vingt ans de métier apprennent qu'un cluster monté pour un site vitrine finit surtout par héberger son propre monitoring.
Ce qui arrive si on s'en passe
Sans orchestrateur qui fait converger les machines vers un état déclaré, rien ne ramène l'application à sa forme voulue lorsqu'elle s'en écarte. Un conteneur qui s'arrête reste arrêté jusqu'à une intervention humaine. La perte d'une machine retire du service les copies qu'elle hébergeait, sans redistribution automatique sur les autres. Les modifications faites à la main sur un serveur (ressources, ports exposés, version d'image) persistent sans être corrigées : la dérive s'accumule, et aucun mécanisme ne signale l'écart entre ce qui tourne et ce qui est décrit. La reprise après incident dépend alors de procédures manuelles et de la mémoire des équipes, et non d'une description relisible et rejouable. Cette absence ne crée pas de faille en soi, mais elle supprime la référence qui permet de repérer une configuration anormale.
Explication de la marmotte
Imagine un grand restaurant avec des dizaines de cuisiniers. Le gérant ne cuisine pas : il affiche au mur ce qu'il veut, par exemple « toujours cinq pizzas prêtes et trois salades ». Si un cuisinier tombe malade, il en appelle un autre. Si la salle se remplit, il ajoute du monde en cuisine. Kubernetes joue ce rôle de gérant pour les programmes informatiques : on lui indique combien de copies d'une application doivent tourner, et il les répartit sur plein d'ordinateurs, relance celles qui plantent et en ajoute quand beaucoup de gens se connectent en même temps. Personne n'a besoin de surveiller chaque machine à la main.
Où ce terme est utilisé
- OWASP Kubernetes Top 10 2025 : les dix risques d'un cluster (18 occurrences)
- Mettre en place la fédération d’identité de charge (15 occurrences)
- Réduire RBAC Kubernetes et bloquer les pods dangereux (13 occurrences)
- Auditer et durcir un cluster Kubernetes avec kube-bench (11 occurrences)
- Conteneurs, Kubernetes, CNI et service mesh (11 occurrences)
- Déployer des NetworkPolicy Kubernetes pas à pas (10 occurrences)
- Auditer la couverture réelle du mTLS service mesh (9 occurrences)
- Jeton de compte de service Kubernetes monté par défaut (8 occurrences)
- Séparer plan de contrôle et plan de données (8 occurrences)
- Isolation réseau multi-tenant avec VPC et NetworkPolicy (7 occurrences)