
QUIC, HTTP moderne, TLS et proxys applicatifs
QUIC, HTTP moderne, TLS et proxys applicatifs
Section intitulée « QUIC, HTTP moderne, TLS et proxys applicatifs »Une requête web n’a plus grand-chose d’un dialogue entre un navigateur et un serveur. Elle traverse un CDN (Content Delivery Network, réseau de diffusion de contenu), un WAF (Web Application Firewall, pare-feu applicatif), un répartiteur de charge et un reverse proxy (mandataire inverse), chacun capable de la déchiffrer, de la réécrire ou de la refuser. Elle voyage en HTTP (HyperText Transfer Protocol), protégée par TLS (Transport Layer Security), et de plus en plus souvent sur QUIC, un transport bâti sur UDP (User Datagram Protocol). Cette fiche relie ces pièces pour comprendre le chemin réel d’un flux web, ce que chaque intermédiaire voit, et pourquoi le diagnostic a changé de nature.
→ Lire l’explication complète de la marmotte
HTTP et ses intermédiaires
Section intitulée « HTTP et ses intermédiaires »Requête, réponse, en-têtes, méthodes et codes
Section intitulée « Requête, réponse, en-têtes, méthodes et codes »HTTP est un protocole de requête et de réponse. Le client envoie une méthode (GET pour lire, POST pour soumettre, PUT et DELETE pour remplacer ou supprimer, HEAD pour obtenir les seuls en-têtes), une cible (/api/commandes?id=42) et des en-têtes qui précisent le contexte : Host, User-Agent, Accept-Encoding, Cookie, Authorization. Le serveur répond par un code d’état et, le plus souvent, un corps.
Les codes se lisent par centaine. Les 2xx signalent un succès (200 OK, 204 No Content), les 3xx une redirection (301 permanente, 302 ou 307 temporaire, 304 Not Modified pour un cache encore valide), les 4xx une erreur imputée au client (401 authentification requise, 403 refus, 404 ressource absente, 429 trop de requêtes), les 5xx une erreur du côté serveur. Trois codes trahissent presque toujours un intermédiaire : 502 Bad Gateway (le proxy a reçu une réponse invalide de l’amont), 503 Service Unavailable (aucun serveur disponible, souvent après des sondes de santé négatives) et 504 Gateway Timeout (l’amont n’a pas répondu à temps). Savoir qui a produit le code est la moitié du diagnostic : un 502 généré par le CDN ne se corrige pas dans le code de l’application.
La sémantique de HTTP est commune à toutes les versions (RFC 9110, 2022). Ce qui change, c’est la manière de la transporter :
| Version | Transport | Format | Multiplexage | Référence |
|---|---|---|---|---|
| HTTP/1.1 | TCP (+ TLS) | texte | non : une requête à la fois par connexion | RFC 9112 |
| HTTP/2 | TCP + TLS en pratique | binaire, trames | oui, flux sur une connexion TCP | RFC 9113 (initialement RFC 7540, 2015) |
| HTTP/3 | QUIC sur UDP | binaire, trames | oui, flux indépendants | RFC 9114 (2022) |
Avec HTTP/1.1, les navigateurs ouvrent plusieurs connexions TCP (Transmission Control Protocol) en parallèle pour contourner l’absence de multiplexage. HTTP/2 regroupe toutes les requêtes sur une seule connexion, compresse les en-têtes et entrelace les flux. Il garde cependant une faiblesse héritée de TCP : un segment perdu bloque la livraison de tout ce qui le suit, y compris les flux qui n’ont rien à voir avec lui. C’est le blocage en tête de ligne au niveau transport, que HTTP/3 a précisément pour objet de supprimer.
Reverse proxy, load balancer, CDN et WAF
Section intitulée « Reverse proxy, load balancer, CDN et WAF »Ces quatre fonctions sont souvent assurées par le même logiciel, ce qui n’aide pas à les distinguer.
Le reverse proxy reçoit les connexions au nom des serveurs applicatifs, termine éventuellement TLS, puis ouvre sa propre connexion vers l’amont. Il ne se contente pas de modifier des adresses comme le ferait une NAT (Network Address Translation, traduction d’adresses) : il comprend HTTP, lit les en-têtes, route selon le nom d’hôte ou le chemin, peut mettre en cache, compresser, réécrire. Deux connexions TCP distinctes existent, l’une côté client, l’autre côté serveur. Une NAT, elle, ne fait que réécrire les en-têtes IP et les ports d’une seule et même connexion (voir la fiche sur la NAT).
Le répartiteur de charge (load balancer) distribue les connexions entre plusieurs serveurs. On distingue deux niveaux :
- en L4 (couche transport), il choisit une cible à partir de l’adresse IP et du port, sans lire le contenu ; il est rapide, ne voit pas les URL et ne peut pas router
/apiailleurs que/static; - en L7 (couche application), il termine la connexion, lit la requête HTTP et décide selon l’hôte, le chemin, un cookie ou un en-tête ; il peut aussi réessayer une requête idempotente sur un autre serveur.
Le CDN est un réseau de points de présence répartis géographiquement, qui servent des copies en cache au plus près des utilisateurs et absorbent une partie des attaques volumétriques. Il n’héberge pas l’application : l’origine reste chez son propriétaire, et le CDN se contente de la relayer et de mémoriser ce qui peut l’être. Confondre CDN et hébergement conduit à oublier que l’origine reste joignable directement si son adresse fuit, ce qui permet de contourner toutes les protections placées en façade.
Le WAF inspecte les requêtes HTTP déchiffrées et bloque celles qui correspondent à des motifs d’attaque (injection, traversée de répertoire, charges anormales). Il ne voit que ce qu’on lui laisse voir : placé avant la terminaison TLS, il est aveugle.
Enfin, les sondes de santé (health checks) permettent au répartiteur de retirer un serveur défaillant. Une sonde L4 vérifie seulement que le port accepte une connexion ; une sonde L7 demande une URL dédiée, par exemple /healthz, et attend un 200. Sans sonde, le répartiteur continue d’envoyer un tiers du trafic vers un serveur mort avec une constance remarquable. Une sonde trop naïve, qui répond 200 même quand la base de données est injoignable, produit le même effet avec plus de discrétion.
Le chemin d’un flux web réel
Section intitulée « Le chemin d’un flux web réel »Un parcours typique, tel qu’on le dessine en atelier :
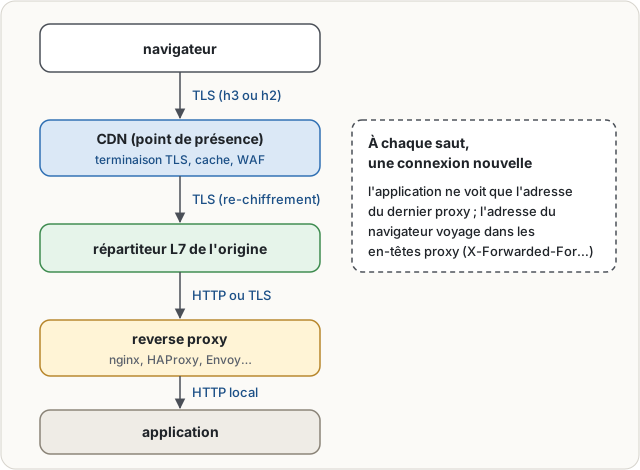
À chaque saut, la connexion est nouvelle : l’application ne voit jamais l’adresse IP du navigateur, seulement celle du dernier proxy. Pour la lui transmettre, les intermédiaires ajoutent des en-têtes proxy : X-Forwarded-For (chaîne des adresses clientes), X-Forwarded-Proto (schéma d’origine, https), X-Forwarded-Host, ou leur équivalent normalisé Forwarded (RFC 7239). En L4, où il n’y a pas d’en-tête HTTP à modifier, on utilise le PROXY protocol de HAProxy, qui préfixe la connexion d’une ligne décrivant le client d’origine.
Ces en-têtes sont de simples déclarations. Si le premier proxy ne les écrase pas et que l’application fait confiance au premier élément de X-Forwarded-For, un client peut se déclarer en 127.0.0.1 et franchir une restriction par adresse. La règle est de ne croire l’en-tête que s’il vient d’un proxy de confiance identifié, et de ne lire que l’entrée ajoutée par ce dernier.
Request smuggling
Section intitulée « Request smuggling »La contrebande de requêtes (request smuggling) exploite un désaccord entre deux intermédiaires sur la fin d’une requête. En HTTP/1.1, la longueur du corps est donnée soit par Content-Length, soit par Transfer-Encoding: chunked. Si le proxy frontal se fie à l’un et le serveur dorsal à l’autre, une seule requête vue par le premier devient deux requêtes pour le second, et la seconde n’a jamais été inspectée par le WAF. Les variantes se multiplient lorsqu’un proxy reçoit du HTTP/2 et le retraduit en HTTP/1.1 vers l’amont. Les parades sont connues : rejeter les requêtes ambiguës (les deux en-têtes à la fois), aligner les versions de bout en bout, utiliser des proxys à jour et éviter de mélanger des implémentations d’interprétation différente.
TLS vu du réseau
Section intitulée « TLS vu du réseau »Certificat, chaîne, SNI et ALPN
Section intitulée « Certificat, chaîne, SNI et ALPN »TLS chiffre et authentifie le canal. Les versions à retenir sont TLS 1.3 (RFC 8446, 2018), à privilégier, et TLS 1.2 (RFC 5246), encore acceptable avec des suites modernes. TLS 1.0 et 1.1 sont dépréciés depuis la RFC 8996 (2021) et n’ont plus rien à faire sur un service exposé.
Le serveur présente un certificat qui lie une clé publique à un ou plusieurs noms, signé par une autorité intermédiaire, elle-même signée par une racine présente dans le magasin du client. Le serveur doit envoyer sa chaîne complète, intermédiaires compris : un certificat feuille seul fonctionne parfois dans un navigateur qui a mis l’intermédiaire en cache, et échoue dans curl ou une application mobile, ce qui alimente de belles conversations sur le thème « chez moi, ça marche ». Le détail des mécanismes est traité dans TLS expliqué.
Deux extensions du message ClientHello comptent beaucoup pour le réseau. Le SNI (Server Name Indication) annonce le nom du site visé, ce qui permet à une même adresse IP de servir des centaines de domaines avec le bon certificat. Il circule en clair, sauf déploiement d’ECH (Encrypted Client Hello), extension qui le chiffre et reste encore peu répandue. L’ALPN (Application-Layer Protocol Negotiation) négocie le protocole applicatif : h2 pour HTTP/2, http/1.1, h3 pour HTTP/3.
Dans le mTLS (mutual TLS), le client présente lui aussi un certificat. C’est un mécanisme d’authentification de machine ou de service, fréquent entre microservices ou pour des clients d’API. Il ne remplace pas l’authentification de l’utilisateur : chiffrer le canal et prouver l’identité d’un logiciel ne dit rien de la personne qui l’utilise. Voir mTLS.
Terminaison, passthrough et re-chiffrement
Section intitulée « Terminaison, passthrough et re-chiffrement »| Mode | Où TLS s’arrête | Ce que l’intermédiaire voit | Usage |
|---|---|---|---|
| Terminaison | sur le proxy ; HTTP en clair vers l’amont | tout le contenu | réseau dorsal de confiance, WAF, cache |
| Passthrough | sur le serveur final ; le proxy relaie en L4 | SNI et métadonnées seulement | mTLS de bout en bout, exigences réglementaires |
| Re-chiffrement | sur le proxy, puis nouvelle session TLS vers l’amont | tout le contenu | WAF ou routage L7 avec chiffrement maintenu |
En passthrough, le répartiteur peut encore router selon le SNI, mais il ne peut ni inspecter, ni ajouter X-Forwarded-For, ni faire de sondes L7 chiffrées sans configuration dédiée.
Horloge, DNS et certificats
Section intitulée « Horloge, DNS et certificats »Un certificat a une date de début et une date de fin : une machine dont l’horloge dérive rejette des certificats parfaitement valides, ou en accepte un expiré. Le nom présenté doit aussi correspondre à celui que le client a résolu via le DNS (Domain Name System) : un enregistrement qui pointe vers l’ancien répartiteur après une migration produit une erreur de nom, pas une panne réseau. Ces dépendances sont décrites dans DNS, DHCP, NTP.
QUIC et HTTP/3
Section intitulée « QUIC et HTTP/3 »Ce que QUIC change
Section intitulée « Ce que QUIC change »QUIC (RFC 9000, mai 2021) est un transport fiable construit au-dessus d’UDP, qui intègre TLS 1.3 (RFC 9001) au lieu de l’empiler. La poignée de main transport et la poignée de main cryptographique ne font plus qu’une : un aller-retour suffit à commencer à échanger des données, contre au moins deux avec TCP puis TLS 1.3.
Trois propriétés en découlent :
- Multiplexage sans blocage en tête de ligne : chaque flux est ordonné séparément ; une perte n’arrête que le flux concerné.
- Migration de connexion : une connexion est identifiée par un identifiant de connexion (connection ID) et non par le quadruplet adresses-ports. Un téléphone qui passe du Wi-Fi au réseau mobile conserve sa connexion.
- 0-RTT : un client qui a déjà parlé au serveur peut envoyer des données applicatives dès le premier paquet. Ces données peuvent être rejouées par un attaquant ; elles doivent donc être réservées aux requêtes idempotentes, un
GETsans effet de bord, et jamais à un paiement.
Le navigateur découvre HTTP/3 par l’en-tête Alt-Svc: h3=":443" reçu lors d’une première connexion en HTTP/2, ou par un enregistrement DNS de type HTTPS (RFC 9460). Si UDP 443 est bloqué, il revient silencieusement sur TCP : le service fonctionne, simplement plus lentement, et personne ne remarque rien.
Pourquoi le diagnostic change
Section intitulée « Pourquoi le diagnostic change »Avec TCP, une capture montre la poignée de main SYN, SYN-ACK, ACK, les numéros de séquence, les retransmissions, puis le ClientHello en clair. Avec QUIC, presque tout est chiffré, y compris les numéros de paquets et les acquittements. Les paquets Initial sont bien protégés par une clé dérivée d’une valeur publique, ce qui permet à un équipement sur le chemin d’en extraire le SNI, mais au-delà, l’observateur ne voit plus que des datagrammes UDP, leurs tailles et leurs horaires. Chercher une négociation TLS classique dans une capture QUIC revient à chercher la serrure sur une porte murée.
Pour l’exploitation, cela implique :
- pare-feu : autoriser ou non UDP 443 est un choix explicite ; un pare-feu à états qui gère mal UDP coupe les connexions longues ou les migrations ;
- inspection : les boîtiers qui déchiffrent TLS par interception ne savent souvent pas faire de même avec QUIC ; beaucoup d’organisations bloquent UDP 443 pour forcer le repli sur TCP inspectable ;
- journaux : la visibilité doit venir des extrémités, journaux du proxy ou du serveur, et des traces qlog qu’exposent certaines implémentations, plutôt que du réseau.
Côté adoption, les navigateurs majeurs et les grands CDN prennent en charge HTTP/3, tandis que nombre de proxys internes et d’outils d’inspection restent en HTTP/2 ou HTTP/1.1. Le parc mixte est la norme, et il faut s’attendre à voir les deux transports cohabiter longtemps.
Exemples commentés
Section intitulée « Exemples commentés »Lire curl -v
Section intitulée « Lire curl -v »L’option -v affiche la résolution, la connexion, la négociation TLS et les en-têtes. Extrait simplifié :
$ curl -v https://www.example.com/* Trying 203.0.113.10:443...* Connected to www.example.com (203.0.113.10) port 443* ALPN: curl offers h2,http/1.1* SSL connection using TLSv1.3 / TLS_AES_256_GCM_SHA384* ALPN: server accepted h2* Server certificate:* subject: CN=www.example.com* expire date: Jan 15 23:59:59 2027 GMT* issuer: C=US; O=Exemple CA; CN=Exemple Intermediate> GET / HTTP/2> Host: www.example.com< HTTP/2 200< content-type: text/html< age: 312< x-cache: HITChaque ligne répond à une question précise : l’adresse résolue est-elle la bonne, la connexion TCP aboutit-elle, quelle version TLS et quel protocole ALPN sont retenus, quel certificat est présenté, et qui répond. Les en-têtes age et x-cache (ce dernier non normalisé, variable selon les fournisseurs) indiquent ici une réponse servie depuis le cache du CDN : l’origine n’a même pas été consultée. Pour tester HTTP/3, curl --http3 fonctionne si l’outil a été compilé avec la prise en charge de QUIC.
Diagnostiquer un certificat expiré ou un SNI incorrect
Section intitulée « Diagnostiquer un certificat expiré ou un SNI incorrect »Un certificat expiré produit côté curl une erreur de vérification mentionnant l’expiration, et rien n’est envoyé en HTTP. Le contrôle direct :
openssl s_client -connect www.example.com:443 -servername www.example.com </dev/null \ | openssl x509 -noout -subject -datesSi la commande sans -servername renvoie un autre certificat que la commande avec, le serveur dépend du SNI ; un client ancien ou un script qui se connecte par adresse IP recevra le certificat par défaut, au nom d’un autre site. Pour tester un serveur précis derrière un répartiteur sans toucher au DNS, curl --resolve www.example.com:443:10.0.0.12 https://www.example.com/ force l’adresse tout en conservant le bon SNI. D’autres cas sont détaillés dans diagnostiquer les erreurs de validation TLS.
À ne pas confondre
Section intitulée « À ne pas confondre »TLS et HTTP : TLS protège un canal, HTTP définit ce qui y circule. Une erreur de certificat survient avant toute requête HTTP ; un 403 survient après une négociation TLS réussie.
CDN et hébergement : le CDN relaie et met en cache, l’origine héberge. Protéger le CDN sans restreindre l’accès à l’origine laisse une porte de service grande ouverte.
Load balancing L4 et L7 : le premier répartit des connexions, le second des requêtes. Une application qui exige l’affinité de session par cookie a besoin du second.
Chiffrement et authentification utilisateur : un cadenas dans la barre d’adresse prouve que le serveur détient la clé du nom affiché, pas que l’utilisateur est celui qu’il prétend, ni que le site est honnête.
🐝 Ce qui arrive si on s’en passe
Section intitulée « 🐝 Ce qui arrive si on s’en passe »Sans vision d’ensemble de la chaîne, chaque intermédiaire applique ses propres règles de découpage des requêtes, et l’écart entre deux interprétations devient un canal de contrebande : une requête cachée dans une autre franchit le pare-feu applicatif puis atteint l’application sans avoir été inspectée. Les en-têtes ajoutés par les relais, acceptés sans vérification de provenance, permettent à un client de se déclarer à l’adresse de son choix, et les journaux enregistrent cette fiction avec le plus grand sérieux. Lorsque le trafic passe par un transport chiffré que le pare-feu ne sait pas lire, l’inspection s’arrête sans bruit ; il ne reste que des volumes et des adresses.
🦫 Explication de la marmotte 🍫
Section intitulée « 🦫 Explication de la marmotte 🍫 »Quand un navigateur affiche une page, il envoie une requête au serveur selon le protocole HTTP, qui règle les échanges du web : une méthode, par exemple lire ou envoyer, une adresse, et des informations complémentaires appelées en-têtes. Le serveur répond avec un code, qui indique le succès ou l’échec, puis le contenu. Pour que personne ne puisse lire ni modifier l’échange, il est chiffré par TLS, un protocole de chiffrement : le serveur présente un certificat qui prouve son nom, et le navigateur indique dès le départ quel site il veut joindre, car une même machine en héberge souvent plusieurs. Entre le navigateur et l’application, la requête traverse souvent plusieurs intermédiaires : un réseau de diffusion qui garde des copies près des utilisateurs, un pare-feu applicatif qui bloque les requêtes suspectes, un répartiteur de charge qui choisit un serveur disponible en vérifiant régulièrement qu’il répond, puis un relais placé devant l’application. Chacun peut déchiffrer la requête, la transmettre chiffrée sans l’ouvrir, ou la rechiffrer vers la suite. Si deux intermédiaires découpent différemment une même requête, un attaquant peut en glisser une seconde à l’intérieur. La version récente, HTTP/3, repose sur QUIC, un transport qui intègre le chiffrement et fait circuler plusieurs échanges en parallèle sur une seule connexion. Comme presque tout y est chiffré dès le début, les pare-feu et les outils de diagnostic voient beaucoup moins de choses qu’avant.
À lire aussi
- Suivre un flux de bout en boutApprendre à raconter un échange complet depuis une action utilisateur jusqu’au service distant, en distinguant nom, adresse, chemin, transport, chiffrement et réponse applicative.
- DNSSEC, DoH, DoT, ODoH et perte de visibilité pour la défenseComparaison de DNSSEC, DoT, DoH, DoQ et ODoH, ce que chacun protège et contre qui, ce que la résolution chiffrée retire à la détection et comment la défense reprend la main.
- UDP, TCP et comportements de transportComprendre les transports classiques, leurs états, timeouts, performance et risques de sécurité.
- Couches, normes et vocabulaire de paquetsConstruire le vocabulaire nécessaire pour lire une communication réseau : couche, protocole, encapsulation, trame, paquet, segment, datagramme, message et plans réseau.
Pages voisines
La citent
- Services applicatifs, partage et protocoles hérités
- UDP, TCP et comportements de transport
- DNSSEC, DoH, DoT, ODoH et perte de visibilité pour la défense
- Suivre un flux de bout en bout
- La poignée de main TLS 1.3 en une page
QUIC, HTTP moderne, TLS et proxys applicatifs
Elle cite
- DNS, DHCP, NTP : services d'infrastructure réseau
- NAT, translations et publication de services
- Comment contourner un rate limit par rotation d’en-têtes
- Comprendre TLS : mécanismes, garanties et limites
- Configurer un WAF sans casser les fonctions métier
- Diagnostiquer les erreurs de validation TLS en production
- mTLS