
Linux shell, permissions et processus, le modèle de contrôle d'accès
Linux shell, permissions et processus, le modèle de contrôle d’accès
Section intitulée « Linux shell, permissions et processus, le modèle de contrôle d’accès »Sous Linux, aucun utilisateur n’ouvre jamais un fichier : ce sont des processus qui le font, avec les identités qu’ils portent, et le noyau ne regarde rien d’autre. Le shell n’est qu’un interprète qui fabrique ces processus et leur lègue presque tout ce qu’il possède. Cette page décrit ce modèle d’exécution et de contrôle d’accès, puis tranche sur le mécanisme à retenir pour chaque besoin de privilège.
→ Lire l’explication complète de la marmotte
Le processus, seul porteur d’identité devant le noyau
Section intitulée « Le processus, seul porteur d’identité devant le noyau »Le noyau Linux ne connaît ni les prénoms ni les intentions. Il connaît des nombres : un UID (User IDentifier) et un GID (Group IDentifier), attachés à chaque processus et comparés à ceux qu’affichent un fichier, une socket ou un autre processus. Le nom alice n’existe que dans /etc/passwd ou dans un annuaire ; il sert à l’affichage, jamais à la décision.
La question « qui a accès » est donc mal posée. La bonne est « quel processus, avec quelles identités, héritées de qui ». Un navigateur, un éditeur et un script téléchargé à la va-vite, lancés depuis la même session, sont indistinguables pour le contrôle d’accès classique : même UID, mêmes droits, mêmes clés privées lisibles.
Le compromis central est là. L’héritage par défaut rend le système composable : un tube entre deux commandes fonctionne sans cérémonie. Il se paie par une autorité ambiante : chaque processus embarque la totalité des droits de son lanceur, y compris ceux dont il n’a aucun besoin. Position défendue ici : réduire ce qu’un processus hérite au moment du lancement, plutôt que lui ajouter des droits en cours de route. Un privilège fixé au lancement se relit dans une configuration ; une élévation en cours d’exécution se relit dans un rapport d’incident.
Shell : interprète de commandes et lanceur de processus
Section intitulée « Shell : interprète de commandes et lanceur de processus »Le shell lit une ligne, la transforme, puis demande au noyau de créer un processus. La plupart des surprises viennent de la transformation.
Expansion avant exécution
Section intitulée « Expansion avant exécution »Avant toute exécution, le shell réécrit la ligne : accolades, tilde, variables, substitutions de commandes, arithmétique, puis découpage en mots et remplacement des motifs (*, ?) par des noms de fichiers. Le programme lancé ne voit jamais l’étoile, il reçoit une liste d’arguments déjà fabriquée. Une variable sans guillemets doubles est redécoupée et ses motifs développés ; un fichier nommé -rf devient une option pour la commande qui reçoit *. La parade : des guillemets, et -- pour marquer la fin des options. L’écriture de scripts Bash relève d’une page à part.
PATH et environnement hérité
Section intitulée « PATH et environnement hérité »Un nom de commande sans barre oblique est cherché dans les répertoires de PATH, dans l’ordre : premier trouvé, premier servi. Un élément vide ou un . dans la liste désigne le répertoire courant : il suffit de déposer un ls piégé dans /tmp et d’attendre qu’un compte privilégié y passe.
L’environnement est un tableau de chaînes recopié de parent en enfant. Il transporte des réglages qui modifient le programme lancé : LD_PRELOAD et LD_LIBRARY_PATH pour le chargeur dynamique, BASH_ENV pour un shell non interactif, plus les variables de chaque interpréteur. Le noyau ne protège qu’un cas : quand l’exécution change les privilèges, il signale un mode d’exécution sécurisé et le chargeur écarte ou restreint les variables LD_*. Le reste est à la charge du programme, voir la pollution des variables d’environnement.
Un secret placé dans l’environnement est légué à tous les descendants et reste lisible dans /proc/<pid>/environ par tout processus de même UID. La variable d’environnement comme coffre-fort revient pourtant à chaque génération d’outillage, avec une régularité qui force le respect.
Redirections et descripteurs
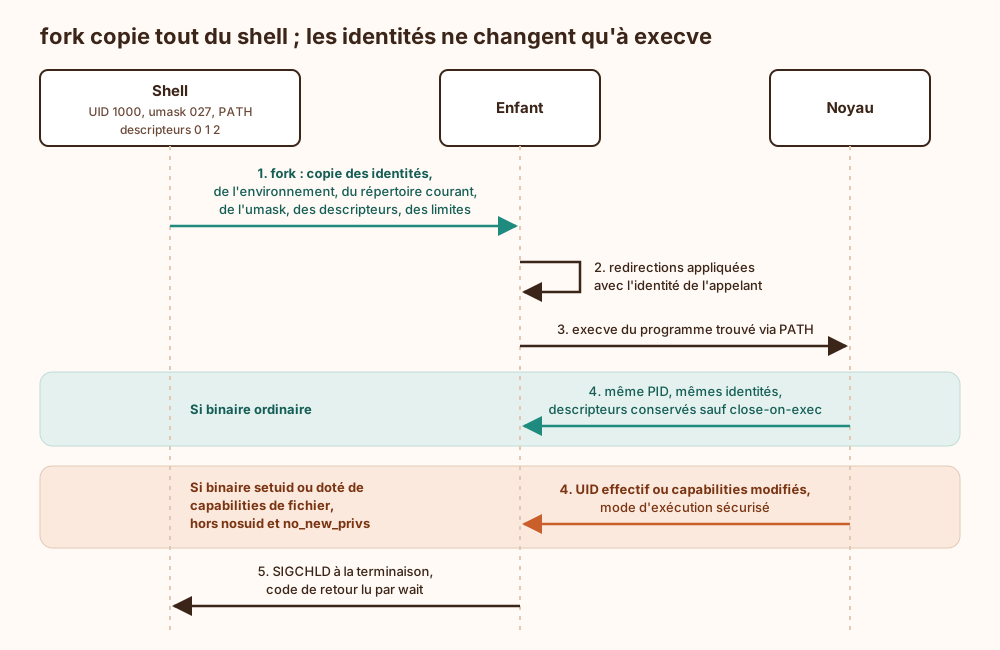
Section intitulée « Redirections et descripteurs »Un descripteur est un petit entier (0 entrée, 1 sortie, 2 erreurs) qui désigne un fichier déjà ouvert. Deux faits structurent le reste. Les redirections sont réalisées par le shell avant l’exécution : sudo commande > /etc/fichier échoue parce que le fichier est ouvert avec l’identité de l’appelant. Et la permission est vérifiée à l’ouverture, pas à chaque lecture : un descripteur ouvert par un processus privilégié, puis hérité par un enfant qui a rendu ses privilèges, fonctionne toujours. C’est une capacité au sens de la sécurité par capacités : la posséder suffit. Tout descripteur qui ne doit pas survivre à execve s’ouvre avec le drapeau close-on-exec (O_CLOEXEC).
Le schéma suit une commande du shell jusqu’au programme : repérer ce qui est copié, et le seul point où les identités changent.
Shell de connexion ou non
Section intitulée « Shell de connexion ou non »Un shell de connexion lit les fichiers de profil (/etc/profile, puis celui du compte) ; un shell interactif ordinaire lit un autre fichier (~/.bashrc pour Bash) ; un shell non interactif n’en lit en principe aucun. Les détails varient selon le shell et la distribution. Résultat : PATH et umask diffèrent entre une session interactive, une commande distante et une tâche planifiée. Un contrôle posé dans un fichier de profil ne s’applique qu’à ceux qui ont la politesse de passer par là.
Pourquoi le shell n’est pas une frontière de sécurité
Section intitulée « Pourquoi le shell n’est pas une frontière de sécurité »Un shell restreint, un menu forcé ou /usr/sbin/nologin limitent ce qu’un humain tape, pas ce que son UID autorise. Tout programme autorisé qui sait lancer une commande (éditeur, afficheur page par page, interpréteur) rend la restriction décorative. nologin empêche d’obtenir une invite, pas d’ouvrir un transfert de port SSH (Secure Shell) : cela se règle côté serveur, voir Protocole SSH, clés d’hôte, authentification et durcissement. L’historique du shell, lui, appartient à l’utilisateur, qui peut le vider : ce n’est pas un journal d’audit.
Identités et permissions : UID, GID, bits rwx, umask et ACL POSIX
Section intitulée « Identités et permissions : UID, GID, bits rwx, umask et ACL POSIX »UID réel, effectif et sauvegardé
Section intitulée « UID réel, effectif et sauvegardé »Chaque processus porte trois UID (et trois GID, plus des groupes supplémentaires). Le réel dit qui a lancé le processus. L’effectif sert aux décisions de privilège ; pour les fichiers, Linux utilise un quatrième identifiant, l’UID de système de fichiers, qui suit l’effectif sauf manipulation explicite. Le sauvegardé garde en réserve une identité vers laquelle revenir.
Ce troisième UID est le piège. Un programme lancé par root qui ne change que son UID effectif garde root en réserve : du code injecté le reprend en un appel système. Un abandon définitif change les trois identifiants, dans l’ordre groupes supplémentaires, GID, puis UID (l’inverse échoue : un processus qui n’est plus root ne peut plus changer de groupe), puis vérifie que le retour en arrière est refusé. La ligne Uid: de /proc/<pid>/status affiche les quatre valeurs.
Bits rwx sur fichier et sur répertoire
Section intitulée « Bits rwx sur fichier et sur répertoire »Le noyau choisit une seule classe et s’y tient : si l’UID du processus est celui du propriétaire, seuls les bits du propriétaire comptent ; sinon, si l’un de ses groupes est celui du fichier, seuls les bits du groupe ; sinon ceux des autres. Pas de repêchage : un fichier en mode 0077 est illisible pour son propriétaire (qui garde le droit d’en changer le mode) et ouvert à tous les autres.
Sur un répertoire, les lettres changent de sens. r autorise à lister les noms, x à traverser, w associé à x à créer, renommer et supprimer des entrées. La suppression d’un fichier dépend donc du répertoire, pas du fichier : un fichier en lecture seule dans un répertoire inscriptible se remplace. La résolution d’un chemin exige x sur chaque répertoire traversé, ce qui fait d’un parent fermé une protection plus fiable que les modes de cent fichiers en dessous.
umask, setuid, setgid et sticky
Section intitulée « umask, setuid, setgid et sticky »L’umask est un attribut du processus, hérité comme le reste : il retire des bits au mode demandé à la création. Avec 022, un fichier demandé en 666 naît en 644 ; 027 ferme tout aux autres. Sa valeur par défaut dépend de la distribution et du chemin d’entrée (session, tâche planifiée, service), et il est ignoré quand le répertoire parent porte une ACL par défaut.
Trois bits spéciaux complètent le mode (sortie de ls -l abrégée et annotée) :
-rwsr-xr-x root root /usr/bin/passwd # setuid : s à la place du x propriétairedrwxrwsr-x root projet /srv/projet # setgid sur répertoiredrwxrwxrwt root root /tmp # sticky : t finalLe setuid sur un exécutable donne au processus l’UID effectif du propriétaire du fichier lors de execve. Linux l’ignore sur les scripts, sur un montage nosuid et pour un processus qui a positionné no_new_privs. Le setgid sur un répertoire fait hériter du groupe aux fichiers créés dedans : c’est le mécanisme correct pour un répertoire partagé. Le sticky réserve suppression et renommage au propriétaire de l’entrée, à celui du répertoire et à root. Il ne règle pas les courses sur les liens symboliques dans /tmp : les réglages fs.protected_symlinks et fs.protected_hardlinks, activés ou non selon la distribution, en ferment une partie, le reste est dans la page sur les conditions de course TOCTOU (Time Of Check To Time Of Use).
ACL POSIX
Section intitulée « ACL POSIX »Les ACL (Access Control List) POSIX (Portable Operating System Interface) ajoutent des entrées nommées aux trois classes d’origine. getfacl les affiche, setfacl les pose, un + en fin de mode dans ls -l les signale. Deux pièges. Le masque plafonne les entrées nommées et le groupe ; ls -l l’affiche à la place des bits du groupe, et chmod g-w modifie le masque. Ensuite, les ACL vivent dans des attributs étendus que beaucoup d’outils de copie abandonnent sans prévenir. Jugement : une ACL pour un besoin précis (un second groupe en lecture sur une arborescence) ; au-delà de quelques entrées, plus personne ne sait dire qui lit quoi, et un groupe dédié fait mieux.
Ce que le contrôle discrétionnaire ne couvre pas
Section intitulée « Ce que le contrôle discrétionnaire ne couvre pas »Tout ce qui précède forme le contrôle discrétionnaire, ou DAC (Discretionary Access Control) : le propriétaire décide. Il ne contraint ni le propriétaire, ni root, ni un processus compromis à l’intérieur de sa propre identité. Ce complément vient du contrôle obligatoire, ou MAC (Mandatory Access Control) : SELinux (Security-Enhanced Linux) ou AppArmor appliquent une politique que root ne modifie pas en passant. Les deux se cumulent : un accès passe si chacun l’autorise. La mise en œuvre relève de la minimisation de la surface du système.
Capabilities, sudo, setuid ou compte de service : quel mécanisme de privilège
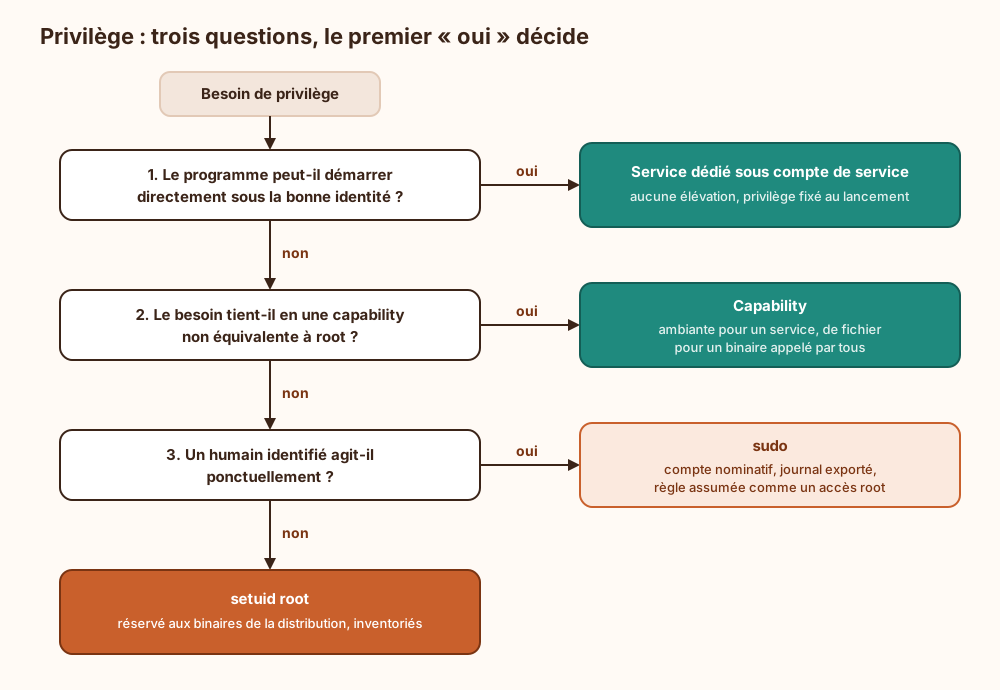
Section intitulée « Capabilities, sudo, setuid ou compte de service : quel mécanisme de privilège »Le noyau découpe le pouvoir de root en une quarantaine de capabilities, attachées à chaque processus dans plusieurs ensembles (permises, effectives, héritables, ambiantes, plus un ensemble limite). Un exécutable peut en recevoir par attribut étendu (setcap, getcap). CAP_NET_BIND_SERVICE autorise l’écoute sous le port 1024 et rien d’autre : voilà le découpage qui tient ses promesses. D’autres sont root sous un autre nom : CAP_SYS_ADMIN, CAP_SYS_MODULE, CAP_SYS_PTRACE, CAP_SETUID, CAP_DAC_OVERRIDE. Poser cap_setuid sur un interpréteur revient à distribuer root avec un ruban autour.
sudo est un binaire setuid root qui applique une politique : authentification, journal, règle par commande, environnement nettoyé (env_reset, secure_path). Sa valeur est la traçabilité nominative, pas le confinement. Toute commande autorisée capable de lancer un shell ou d’écrire un fichier arbitraire équivaut à root ; dans les arguments d’une règle, un joker correspond aussi aux espaces et aux barres obliques, d’où arguments ajoutés et traversée de chemin. Le journal enregistre la commande lancée, pas ce qu’elle fait ensuite.
Le setuid root reste nécessaire aux rares outils dont le métier est de changer d’identité (su, sudo, passwd). Chaque binaire setuid est du code privilégié nourri d’arguments, d’un environnement et de descripteurs choisis par un appelant hostile, voir l’élévation de privilège par SUID. Sur un binaire maison, la réponse est non.
Le compte de service ne demande aucune élévation : le premier processus du système, PID 1 (PID pour Process IDentifier), lance le programme directement sous la bonne identité, avec les seules capabilities nécessaires. Les directives sont décrites dans la page systemd.
L’arbre se lit de haut en bas, et la première réponse positive arrête la descente.
Processus : fork, exec, signaux, états et /proc
Section intitulée « Processus : fork, exec, signaux, états et /proc »fork puis exec, arbre et PID 1
Section intitulée « fork puis exec, arbre et PID 1 »fork duplique l’appelant : mêmes identités, même environnement, même répertoire courant, même umask, mêmes descripteurs, mêmes limites. execve remplace ensuite le programme sans changer le processus. Entre les deux, l’enfant peut réduire ce qu’il transmettra : c’est la fenêtre où un lanceur sérieux ferme les descripteurs, change d’identité et pose ses limites.
Tous les processus descendent de PID 1. Quand un parent meurt, ses enfants orphelins sont adoptés par PID 1 (ou par un ancêtre déclaré « subreaper »), qui doit lire leur code de retour. Le noyau ne délivre à PID 1 que les signaux pour lesquels il a installé un gestionnaire : une application ordinaire lancée comme PID 1 d’un conteneur ignore donc SIGTERM et n’enterre pas les zombies, d’où le petit init placé devant. Le contexte est dans la page sur les namespaces et cgroups.
Signaux, zombie et orphelin
Section intitulée « Signaux, zombie et orphelin »SIGTERM demande l’arrêt et peut être intercepté ; SIGKILL et SIGSTOP ne peuvent être ni interceptés ni ignorés. Pour envoyer un signal, l’UID réel ou effectif de l’émetteur doit correspondre à l’UID réel ou sauvegardé de la cible, sauf CAP_KILL. Après execve, les signaux ignorés le restent et les gestionnaires reviennent au comportement par défaut.
Le schéma donne le cycle de vie : regarder qui doit agir à chaque état.
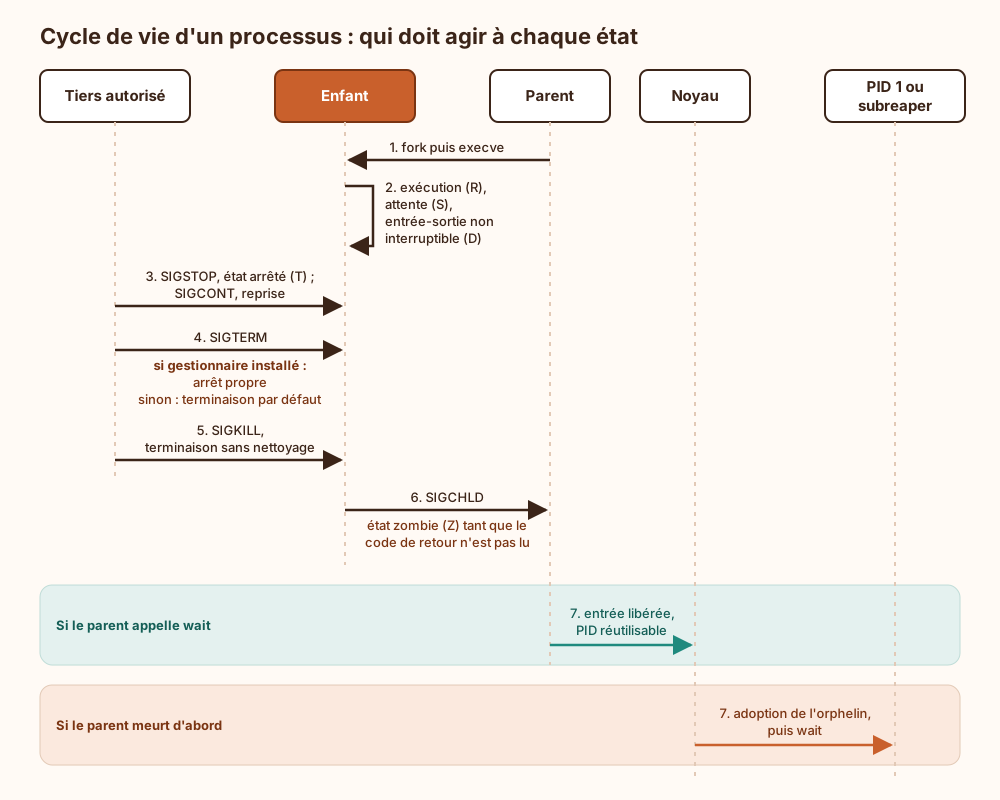
Un zombie n’occupe plus ni mémoire ni processeur, seulement une entrée dans la table des processus. Lui envoyer SIGKILL ne sert à rien, il est déjà mort : c’est le parent qu’il faut corriger. Une accumulation épuise les PID, et plus rien ne démarre. Côté exploitation : SIGTERM, un délai, puis SIGKILL, jamais l’inverse (verrous orphelins, fichiers à moitié écrits). Et un PID est un nombre recyclé : entre la lecture d’un fichier de PID et l’envoi du signal, la cible peut avoir changé ; le suivi par le gestionnaire de services ferme cette course.
/proc, sessions, groupes de processus et limites
Section intitulée « /proc, sessions, groupes de processus et limites »/proc/<pid>/ expose chaque processus : status, cmdline, environ, fd/, exe. cmdline est lisible par tous par défaut : un secret passé en argument s’affiche dans le ps de n’importe quel compte local. L’option de montage hidepid masque les processus des autres utilisateurs ; son activation dépend de la distribution et peut gêner la supervision. environ et les descripteurs restent lisibles par les processus de même UID ; la mémoire aussi, par ptrace ou /proc/<pid>/mem, dans les limites de kernel.yama.ptrace_scope (valeur variable selon la distribution). Seul un processus marqué non « dumpable », ce que le noyau fait après une exécution qui change les privilèges, échappe à ces lectures. Deux services sous le même compte ne sont séparés par rien : un compte par service, sans exception pour « les petits ».
Une session regroupe les processus d’une connexion autour d’un terminal ; elle contient des groupes de processus, unité du contrôle des tâches. Un processus qui appelle setsid quitte la session et survit à la déconnexion : « tuer la session » d’un compte révoqué ne garantit rien, seul un suivi par cgroups (control groups) retrouve tous les descendants.
Les limites de ressources (ulimit, prlimit) sont par processus et héritées. RLIMIT_NOFILE borne les descripteurs, RLIMIT_NPROC les processus de l’UID réel, RLIMIT_CORE les vidages mémoire, qui contiennent les clés présentes en mémoire. Piège classique : /etc/security/limits.conf est appliqué par PAM (Pluggable Authentication Modules) à l’ouverture d’une session et ne concerne pas les services lancés par PID 1, qui prennent leurs limites dans leur unité.
Exemple : décision d’accès du noyau sur un fichier de configuration
Section intitulée « Exemple : décision d’accès du noyau sur un fichier de configuration »Un service tourne sous le compte svc-web. Sa configuration semble protégée en écriture :
drwxrwx--- root svc-web /srv/app/conf-rw-r----- root svc-web /srv/app/conf/app.confLe schéma déroule deux demandes du même processus : l’écriture directe, puis le contournement par le répertoire.
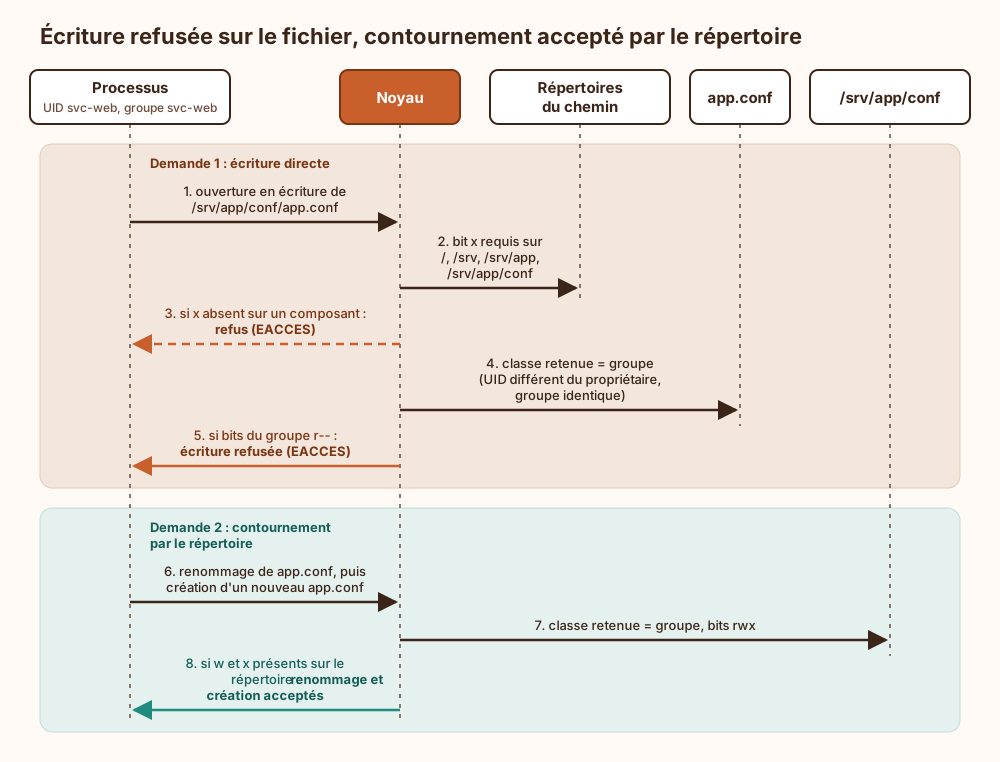
Le fichier est protégé, pas son répertoire. Un processus compromis remplace sa configuration, et le prochain redémarrage charge celle de l’attaquant. Correction : chmod 750 /srv/app/conf, et des répertoires distincts pour ce que le service doit écrire (état, cache). Règle générale : code et configuration appartiennent à root et ne sont inscriptibles par aucun compte de service. namei -l /srv/app/conf/app.conf affiche les permissions de chaque composant du chemin, ce qui évite de raisonner sur le seul dernier maillon.
Surface d’attaque, supervision et exploitation du modèle de permissions
Section intitulée « Surface d’attaque, supervision et exploitation du modèle de permissions »Prérequis : un système de fichiers qui gère ACL et attributs étendus (ext4, XFS et Btrfs le font ; à vérifier sur les montages réseau), les outils getcap et setcap, un module de contrôle obligatoire actif, et les options nosuid, nodev, noexec sur /tmp, /dev/shm et les répertoires personnels. noexec freine sans bloquer : sh script exécute l’interpréteur et se contente de lire le script.
| Vecteur | Ce qui est abusé | Contre-mesure |
|---|---|---|
PATH et environnement hérités | recherche de commande, variables du chargeur | chemins absolus, environnement reconstruit au lancement |
| Binaire setuid ou capabilities de fichier | code privilégié nourri par l’appelant | inventaire, nosuid, no_new_privs |
| Répertoire inscriptible sur un chemin de confiance | remplacement de fichier, liens symboliques | propriétaire root, fs.protected_* |
| Descripteur hérité | accès conservé après abandon de privilèges | close-on-exec |
| UID partagé entre services | mémoire, environnement, signaux | un compte par service |
Supervision : inventaire périodique des fichiers setuid et setgid (find / -xdev -perm /6000) et des capabilities de fichier (getcap -r /), comparé à une référence ; tout écart est un événement. Journalisation des execve et des changements d’identité par le sous-système d’audit ou des sondes eBPF (extended Berkeley Packet Filter). Journal sudo exporté hors de la machine, puisque root local peut le réécrire.
Secrets et rotation : compte de service sans mot de passe, sans shell de connexion, sans clé partagée ; secrets lisibles par ce seul compte, jamais en argument. Retirer un utilisateur d’un groupe n’affecte pas ses processus déjà lancés, qui gardent leur liste de groupes jusqu’à leur fin : une révocation se termine par l’arrêt des processus.
Sauvegarde et reprise : le noyau ne stocke que des numéros. Une restauration sur une machine où UID et GID diffèrent attribue les fichiers à d’autres comptes. Sauvegarder avec identifiants numériques, ACL et attributs étendus (sans quoi capabilities de fichier et étiquettes SELinux disparaissent), et aligner les numéros des comptes de service entre machines. La procédure pas à pas est dans le guide de durcissement d’un serveur Linux de production.
🐝 Ce qui arrive si on s’en passe
Section intitulée « 🐝 Ce qui arrive si on s’en passe »Sans ce modèle en tête, la pente naturelle est connue : tout tourne sous root ou sous un compte commun, parce que « ça marche ». Le journal attribue alors chaque action à la même identité, et l’enquête après incident ne distingue plus le service compromis de l’administrateur légitime. Révoquer un accès oblige à changer un secret partagé par tous, donc personne ne le fait. Une erreur de chemin dans une tâche de maintenance efface en dehors de son périmètre, puisque rien ne l’arrête. La détection perd son signal : quand root fait tout, root qui fait quelque chose d’anormal ressemble à un mardi.
🦫 Explication de la marmotte 🍫
Section intitulée « 🦫 Explication de la marmotte 🍫 »Sur un système Linux, chaque programme en cours d’exécution porte des numéros qui disent pour le compte de qui il agit et à quels groupes il appartient. Chaque fichier porte aussi le numéro d’un propriétaire, celui d’un groupe, et trois séries de droits : lire, écrire, exécuter. Quand un programme demande un fichier, le noyau (la partie centrale du système) compare les numéros, choisit une seule série de droits et répond oui ou non. Pour un dossier, écrire veut dire ajouter ou retirer des fichiers : un fichier protégé dans un dossier ouvert peut donc être remplacé.
L’interpréteur de commandes transforme d’abord la ligne tapée, puis crée un nouveau programme en se copiant lui-même. La copie reçoit les mêmes numéros, les mêmes réglages et les mêmes fichiers ouverts, puis charge le programme demandé. Tout descend ainsi d’un premier programme lancé au démarrage, qui recueille aussi ceux dont le parent a disparu.
Certaines tâches exigent plus de droits. Quatre moyens existent : démarrer directement le programme sous un compte réservé, lui accorder un seul pouvoir précis, laisser une personne identifiée lancer une commande en gardant une trace, ou marquer un programme pour qu’il prenne les droits de son propriétaire. Le premier est le plus sûr, le dernier le plus risqué.
Quand ces règles sont mal posées, un programme piraté hérite de tout ce que son lanceur pouvait faire, et le système obéit sans broncher.
À lire aussi
- Écrire des scripts Bash système fiables et sûrs en productionBash et scripting système, ou comment écrire des scripts d'administration qui tiennent en production sans devenir une faille (mode strict, guillemets, injection, secrets, verrous, environnement d'exécution).
- Détournement de bibliothèque partagée Linux et ld.soOrdre de recherche du chargeur dynamique Linux, LD_PRELOAD, RPATH et RUNPATH, mode secure-execution et contre-mesures contre le détournement de bibliothèque partagée.
- Registre Windows, GPO et services, fonctionnement et attaquesComment le registre Windows, les GPO et les services s'articulent, où se logent la persistance et l'élévation de privilèges, et ce qu'il faut verrouiller en premier.
- EBPF pour observabilité et enforcement LinuxeBPF permet d’observer et de contrôler réseau, processus et charge applicative depuis le noyau Linux, sous contrôle du vérificateur.
Pages voisines
La citent
Linux shell, permissions et processus, le modèle de contrôle d'accès
Elle cite
- Lien dans les deux sens :Durcissement Linux et Windows par minimisation de surface
- Lien dans les deux sens :Linux : définition, origine et rôle du noyau
- Lien dans les deux sens :DAC, MAC, RBAC, ABAC ou ReBAC : quel modèle choisir
- Lien dans les deux sens :Élévation de privilège via un binaire SUID root mal configuré
- EBPF pour observer et bloquer dans le noyau Linux
- Systemd : gérer services, unités et journal sous Linux
- Isolation des conteneurs Docker : namespaces, cgroups et évasions
- Protocole SSH, clés d'hôte, authentification et durcissement
- Sécurité par capacités contre ACL
- Comment corriger une attaque path traversal
- Durcir un serveur Linux avant la mise en production, checklist
: les deux pages se citent l’une l’autre.