
Routage interne, redistribution et stabilité
Routage interne, redistribution et stabilité
Section intitulée « Routage interne, redistribution et stabilité »Dans un réseau de quelques sous-réseaux, les routes s’écrivent à la main. Au-delà, il faut que les routeurs se les communiquent eux-mêmes : c’est le rôle d’un IGP (Interior Gateway Protocol, protocole de routage interne), qui calcule les chemins à l’intérieur d’un même domaine administratif. Cette fiche explique comment fonctionnent les deux IGP dominants, OSPF (Open Shortest Path First) et IS-IS (Intermediate System to Intermediate System), ce que signifient voisinage, coût, aire et convergence, et pourquoi la redistribution et les interfaces mal choisies font partie des causes les plus efficaces de panne et d’injection de routes.
→ Lire l’explication complète de la marmotte
Pourquoi automatiser le routage interne
Section intitulée « Pourquoi automatiser le routage interne »Routes statiques et topologie dynamique
Section intitulée « Routes statiques et topologie dynamique »Une route statique dit « pour 10.20.0.0/16, passer par 10.0.12.2 ». Elle est simple, prévisible, et ne réagit à rien : si le lien vers 10.0.12.2 tombe, la route reste en place, et le trafic part vers un voisin injoignable, sauf si l’interface elle-même passe hors service. Avec trois sites et deux liens de secours, le nombre de routes à maintenir et de cas de panne à prévoir dépasse vite ce qu’une équipe peut tenir à jour sans erreur.
Un IGP maintient une topologie dynamique : chaque routeur découvre ses voisins, échange des informations sur les liens, et recalcule les meilleurs chemins quand quelque chose change. Les routes statiques gardent leur place pour les cas simples et stables : route par défaut vers un fournisseur, petit site en étoile, réseau d’administration isolé.
Deux familles : vecteur de distance et état de lien
Section intitulée « Deux familles : vecteur de distance et état de lien »Les protocoles à vecteur de distance (distance-vector), comme RIP (Routing Information Protocol, RIPv2 dans la RFC 2453), échangent avec leurs voisins des listes « destination, distance ». Chaque routeur ne connaît que ce que ses voisins lui disent, sans vue d’ensemble, ce qui le rend sensible aux boucles transitoires et à la lenteur de convergence. RIP limite la distance à 15 sauts, 16 signifiant « injoignable ». EIGRP (Enhanced Interior Gateway Routing Protocol), d’origine Cisco et décrit dans la RFC informative 7868, améliore fortement le principe.
Les protocoles à état de lien (link-state), OSPF et IS-IS, procèdent autrement. Chaque routeur décrit ses propres liens et leur coût, diffuse cette description à tout le domaine, et stocke celles des autres dans une base, la LSDB (Link-State Database). Tous les routeurs d’une même zone ont la même LSDB, donc la même carte, et chacun calcule seul l’arbre des plus courts chemins avec l’algorithme de Dijkstra, appelé SPF (Shortest Path First).
Convergence et stabilité
Section intitulée « Convergence et stabilité »La convergence est le temps nécessaire pour que tous les routeurs aient de nouveau une vue cohérente après un changement. Elle additionne la détection de la panne, la diffusion de l’information, le calcul SPF et l’installation des routes dans le plan de transfert. Avec les temporisations OSPF par défaut sur Ethernet (Hello toutes les 10 secondes, voisin déclaré mort après 40 secondes sans Hello), la détection seule peut prendre 40 secondes. BFD (Bidirectional Forwarding Detection, RFC 5880) détecte une panne de lien en quelques centaines de millisecondes ou moins et prévient le protocole de routage.
Converger vite n’est pas la même chose qu’être stable. Une interface qui tombe et revient toutes les dix secondes, ce qu’on appelle le flapping, provoque à chaque fois une diffusion et un recalcul dans tout le domaine. Plus la convergence est agressive, plus l’oscillation est fidèlement propagée. Les implémentations temporisent donc les calculs SPF et la génération des annonces (throttling) : réaction immédiate au premier événement, puis attente croissante si les événements se répètent. Un lien instable doit être retiré de l’IGP et réparé, pas laissé à la patience des routeurs.
OSPF et IS-IS
Section intitulée « OSPF et IS-IS »Voisinage et adjacence
Section intitulée « Voisinage et adjacence »OSPF (version 2 pour IPv4, RFC 2328 ; version 3 pour IPv6, RFC 5340) fonctionne directement sur IP, protocole numéro 89. Les routeurs envoient des paquets Hello en multicast vers 224.0.0.5. Deux routeurs deviennent voisins quand ils se voient mutuellement et s’accordent sur plusieurs paramètres : même sous-réseau, même aire, mêmes temporisations Hello et Dead, même authentification, même MTU (Maximum Transmission Unit) pour la suite de l’échange. Une MTU différente bloque l’adjacence dans l’état ExStart ou Exchange, ce qui fait partie des grands classiques du dépannage.
Les états successifs sont Down, Init, 2-Way, ExStart, Exchange, Loading, puis Full. Seul Full signifie une adjacence complète, avec bases synchronisées. Sur un segment Ethernet partagé, OSPF élit un DR (Designated Router) et un BDR (Backup Designated Router) : les autres routeurs ne forment d’adjacence complète qu’avec eux, et restent en 2-Way entre eux, ce qui est normal et non une panne.
Coût et calcul de chemin
Section intitulée « Coût et calcul de chemin »Le coût OSPF d’une interface est, par défaut, la bande passante de référence divisée par la bande passante de l’interface. Sur de nombreux équipements, la référence vaut 100 Mbit/s : un lien à 100 Mbit/s coûte 1, un lien à 10 Mbit/s coûte 10, et un lien à 1 Gbit/s ou à 10 Gbit/s coûte… 1 également, le coût ne pouvant descendre sous 1. Un réseau moderne doit donc relever la bande passante de référence, de façon identique sur tous les routeurs, ou fixer les coûts explicitement. Le chemin retenu est celui dont la somme des coûts est la plus faible.
Exemple commenté : trois routeurs
Section intitulée « Exemple commenté : trois routeurs »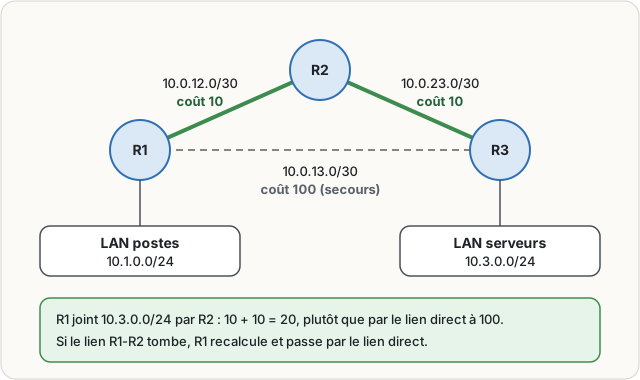
R1 joint 10.3.0.0/24 par R2 (coût 10 + 10 = 20, plus le coût de l’interface du LAN de R3) plutôt que par le lien direct à 100. Si le lien R1-R2 tombe, R1 recalcule et passe par le lien direct. Configuration de R1 en syntaxe de type Cisco IOS :
router ospf 1 router-id 1.1.1.1 auto-cost reference-bandwidth 100000 passive-interface default no passive-interface GigabitEthernet0/0 no passive-interface GigabitEthernet0/1 network 10.0.12.0 0.0.0.3 area 0 network 10.0.13.0 0.0.0.3 area 0 network 10.1.0.0 0.0.0.255 area 0passive-interface default rend toutes les interfaces passives, puis on réactive seulement les liens vers R2 et R3. Le LAN des postes 10.1.0.0/24 est bien annoncé dans OSPF, mais aucun Hello n’y est émis ni accepté : un poste ne peut pas y devenir voisin. C’est la réponse à l’atelier « identifier une interface qui ne devrait pas participer » : toute interface tournée vers des utilisateurs, des serveurs ou un réseau tiers doit être passive.
Aires et résumé de routes
Section intitulée « Aires et résumé de routes »Une LSDB unique devient lourde dans un grand réseau, et chaque changement y déclenche un recalcul partout. OSPF découpe donc le domaine en aires. L’aire 0 (Area 0), ou épine dorsale, relie toutes les autres ; les routeurs à la frontière, les ABR (Area Border Router), ne transmettent aux autres aires qu’un résumé des routes. Un routeur qui importe des routes externes dans OSPF est un ASBR (Autonomous System Boundary Router).
Le résumé (summarization) consiste à annoncer 10.20.0.0/16 au lieu de 256 réseaux en /24. Les tables rétrécissent, et l’instabilité d’un /24 ne sort plus de son aire puisque le résumé, lui, ne change pas. Cela suppose un plan d’adressage pensé par blocs contigus, comme décrit dans IPv4, CIDR et plans d’adressage.
IS-IS dans les grands réseaux
Section intitulée « IS-IS dans les grands réseaux »IS-IS, normalisé par l’ISO (ISO/IEC 10589) puis adapté à IP par la RFC 1195, repose sur les mêmes principes d’état de lien. Il présente deux particularités qui expliquent son succès chez les opérateurs et dans les très grands réseaux. Il fonctionne directement au-dessus de la couche liaison, et non sur IP, ce qui le rend moins exposé aux paquets forgés venus de loin. Ses informations sont transportées dans des structures TLV (Type, Length, Value) extensibles : ajouter IPv6 ou l’ingénierie de trafic n’a pas exigé de nouvelle version du protocole. Sa hiérarchie est à deux niveaux, L1 à l’intérieur d’une zone et L2 entre zones, avec des frontières placées sur les liens plutôt qu’à l’intérieur des routeurs. En entreprise, OSPF reste plus courant, surtout par habitude et par familiarité des équipes.
Redistribution et sécurité
Section intitulée « Redistribution et sécurité »Comment une redistribution casse un réseau
Section intitulée « Comment une redistribution casse un réseau »La redistribution injecte dans un protocole des routes venant d’ailleurs : routes statiques, routes connectées, autre IGP, BGP (Border Gateway Protocol). Chaque source a une distance administrative qui départage les routes vers un même préfixe venues de protocoles différents ; chez Cisco par exemple : connectée 0, statique 1, eBGP 20, OSPF 110, IS-IS 115, RIP 120, iBGP 200.
Scénario classique de catastrophe : deux routeurs, R5 et R6, redistribuent mutuellement entre OSPF et un ancien domaine RIP. R5 injecte dans OSPF une route apprise par RIP. R6 reçoit ce même préfixe à la fois par RIP (distance 120) et par OSPF comme route externe (distance 110) : il préfère la version OSPF, qui le renvoie vers R5, puis la redistribue à son tour dans RIP avec la métrique de départ choisie par l’administrateur. Le domaine RIP reçoit alors une annonce de son propre réseau venant de R6, parfois plus flatteuse que l’originale. Selon les métriques, une partie du trafic tourne entre R5, R6 et les routeurs RIP : c’est une boucle de routage, que la convergence rapide installe avec zèle dans tout le domaine.
Autre scénario, plus bref : un administrateur redistribue « toutes les statiques » dans OSPF sur un routeur où traîne une route par défaut de test vers un équipement de laboratoire. En quelques secondes, l’ensemble du réseau envoie vers le laboratoire tout le trafic sans route plus précise, c’est-à-dire internet.
Les garde-fous :
- ne redistribuer que des préfixes explicitement listés (prefix-list ou route-map), jamais une source entière ;
- étiqueter (tag) les routes redistribuées à l’entrée et refuser de les réinjecter dans leur protocole d’origine ;
- limiter le nombre de routes acceptées depuis une source externe ;
- ne jamais laisser passer une route par défaut sans l’avoir décidé ;
- redistribuer en un seul point quand c’est possible, et documenter pourquoi s’il en faut deux.
L’interaction avec BGP et le routage externe est développée dans BGP, internet et anycast, et la logique de choix de route dans décision de chemin et tables de routage.
Authentifier les voisins et limiter les participants
Section intitulée « Authentifier les voisins et limiter les participants »Un routeur OSPF accepte comme voisin tout équipement qui parle OSPF correctement sur une interface active. Un poste muni d’un démon de routage libre peut donc annoncer une route plus spécifique vers un serveur et attirer son trafic : c’est l’injection de route, une attaque qui ne franchit aucune règle de pare-feu puisqu’elle modifie la carte au lieu de forcer le passage.
Deux mesures se complètent. Les interfaces passives retirent l’IGP des segments où il n’a rien à faire. L’authentification des voisins rejette les paquets de routage non signés : OSPFv2 supporte historiquement MD5 et, depuis la RFC 5709, HMAC-SHA (Hash-based Message Authentication Code avec SHA, Secure Hash Algorithm) ; OSPFv3 utilise IPsec ou une remorque d’authentification (RFC 7166) ; IS-IS dispose de HMAC-MD5 (RFC 5304) et de HMAC-SHA (RFC 5310). MD5 étant cryptographiquement dépassé, les variantes SHA sont à préférer quand le matériel les accepte. L’authentification protège contre un participant illégitime, pas contre un routeur légitime compromis ni contre une erreur de configuration.
Une aire OSPF n’est d’ailleurs pas une zone de sécurité : elle découpe le calcul de routes, pas les droits d’accès. Deux sous-réseaux dans des aires différentes se joignent parfaitement si rien ne les filtre. Le cloisonnement relève de filtrage, segmentation et NAC.
Superviser et prévoir le retour arrière
Section intitulée « Superviser et prévoir le retour arrière »Les événements à surveiller sont connus : changement d’état de voisinage (passage de Full à Down), apparition d’un nouveau voisin, variation brusque du nombre de routes ou de LSA (Link-State Advertisement), fréquence des calculs SPF. Les équipements les émettent en journal système ou en trap SNMP (Simple Network Management Protocol) ; il reste à les collecter et à alerter. Un nouveau voisin sur un segment où l’on n’en attend aucun est une alerte de sécurité, pas une curiosité.
Toute modification de routage, surtout une redistribution, s’accompagne d’une procédure de retour arrière écrite à l’avance : configuration précédente sauvegardée, commande d’annulation prête, et sur les équipements qui le permettent, validation différée qui restaure automatiquement l’état antérieur si l’opérateur ne confirme pas dans un délai donné. Il est également utile de capturer la table de routage et la LSDB avant le changement : pendant l’incident, plus personne ne se souvient de l’état initial. Voir gestion de réseau et supervision.
À ne pas confondre
Section intitulée « À ne pas confondre »IGP et BGP : l’IGP calcule les chemins à l’intérieur d’un domaine en cherchant le plus court ; BGP échange des routes entre domaines selon des politiques. Faire porter à OSPF les routes d’internet est aussi raisonnable que de confier le cadastre national au syndic de copropriété.
Convergence rapide et stabilité : la première réagit vite, la seconde évite de réagir pour rien. Les deux se règlent ensemble.
Aire OSPF et zone de sécurité : l’une organise le routage, l’autre le contrôle d’accès.
🐝 Ce qui arrive si on s’en passe
Section intitulée « 🐝 Ce qui arrive si on s’en passe »Sans authentification des voisins ni interfaces passives, le routage interne accepte les annonces de toute machine branchée sur un segment où il écoute : une seule route injectée depuis un poste utilisateur suffit à faire passer le trafic d’un serveur par ce poste, ou à le faire disparaître, sans qu’aucune règle de filtrage ne soit franchie. Une redistribution non filtrée propage l’erreur à tout le domaine en quelques secondes, puisque la convergence rapide diffuse le faux aussi bien que le vrai. Sans supervision des changements de voisinage ni procédure de retour arrière, la cause se cherche pendant que le réseau oscille, et l’état des routes au moment de l’incident n’est plus disponible pour personne.
🦫 Explication de la marmotte 🍫
Section intitulée « 🦫 Explication de la marmotte 🍫 »Dans un réseau d’entreprise, les routeurs sont les appareils qui transmettent les données d’un sous-réseau à un autre, et chacun doit savoir par où envoyer chaque paquet. On peut écrire ces chemins à la main, mais dès que le réseau grandit ou qu’un lien tombe, il vaut mieux que les routeurs les calculent eux-mêmes grâce à un protocole de routage interne. Avec les protocoles dits à état de lien, les plus répandus en entreprise, chaque routeur découvre d’abord ses voisins directs et établit avec eux une relation. Il décrit ensuite ses propres liens et leur coût, puis diffuse cette description à tous les autres. Chaque routeur obtient ainsi la carte complète du réseau et calcule seul le chemin le moins coûteux vers chaque destination. Quand un lien change, la nouvelle circule et tous recalculent : c’est la convergence. Pour limiter ce travail, on découpe le grand réseau en aires reliées à une aire centrale, et on résume les routes. Les dangers sont précis. Un lien qui tombe et revient sans cesse oblige tout le monde à recalculer en boucle. Une interface ouverte vers les postes des utilisateurs permet à une machine quelconque de se déclarer voisine et d’annoncer de fausses routes, sauf si les voisins doivent s’authentifier. La redistribution, qui copie les routes d’une autre source dans le protocole, peut injecter en masse des chemins erronés si elle n’est pas filtrée.
À lire aussi
- GRE, IPsec ou GRE dans IPsec pour un tunnel site à siteChoisir entre GRE, IPsec et GRE dans IPsec pour relier deux sites, selon le chiffrement, le routage dynamique, le multicast et le coût en MTU.
- MPLS, GMPLS, SD-WAN et overlays opérateursExpliquer les architectures WAN et opérateurs au-delà d’IP routé : labels, circuits virtuels, transport optique, overlays, SD-WAN et technologies héritées.
- Couches, normes et vocabulaire de paquetsConstruire le vocabulaire nécessaire pour lire une communication réseau : couche, protocole, encapsulation, trame, paquet, segment, datagramme, message et plans réseau.
- Géographie d'internet, câbles sous-marins et points d'atterrissementAnatomie des câbles sous-marins, routes et points de concentration, pannes, menaces, latence, et ce que cette géographie physique impose à une architecture.
Pages voisines
La citent
Routage interne, redistribution et stabilité
Elle cite
- Lien dans les deux sens :BGP, Internet, anycast et sécurité des annonces
- Lien dans les deux sens :IPv4, CIDR et plans d’adressage
- Décision de chemin, routes statiques et routage système
- Filtrage, segmentation, NAC et Zero Trust
- Gestion réseau, supervision et référentiels d’exploitation
- Prouver qu’un message vient du bon secret
: les deux pages se citent l’une l’autre.