
Séparer plan de contrôle et plan de données
Séparer plan de contrôle et plan de données
Section intitulée « Séparer plan de contrôle et plan de données »Le plan de contrôle décide, configure et autorise. Le plan de données exécute et transporte les traitements réels. Leur donner les mêmes réseaux, identités ou droits transforme une compromission locale en prise de contrôle générale, avec la régularité désagréable d’un incident dont la cause était pourtant écrite sur le schéma.
→ Lire l’explication complète de la marmotte
Plans de contrôle et de données : une frontière d’autorité
Section intitulée « Plans de contrôle et de données : une frontière d’autorité »Le plan de contrôle regroupe les interfaces qui modifient l’état de l’infrastructure : consoles cloud, interfaces de programmation applicative (API, Application Programming Interface) d’administration, orchestrateurs, gestionnaires d’identités, dépôts de configuration et services de secrets. Dans Kubernetes, l’API server, le contrôleur, le planificateur et la base etcd appartiennent à ce plan. Une requête autorisée peut créer un pod, modifier une règle réseau, lire un Secret ou déléguer un droit.
Le plan de données contient les ressources qui exécutent ou portent les flux : charges applicatives, nœuds de calcul, proxys de trafic, bases de données, files de messages et réseaux de production. Un conteneur compromis est d’abord un incident du plan de données. Il ne doit pas devenir une identité capable d’appeler l’API Kubernetes avec des privilèges d’administration.
Dans un cloud public, la console, les API de gestion et les services d’identité relèvent du contrôle. Les machines virtuelles, conteneurs, stockages applicatifs et équilibreurs qui servent les utilisateurs relèvent des données. La distinction n’est pas cosmétique : un rôle permettant de redémarrer une machine n’autorise pas la création d’un nouvel administrateur, l’attachement d’un disque contenant des secrets ou la modification d’une politique d’organisation.
Le compromis central est net. Séparer les plans augmente le nombre de réseaux, comptes, identités, journaux et procédures de reprise à exploiter. En échange, une compromission d’un workload ne donne pas mécaniquement la faculté de reprogrammer l’infrastructure entière. Cette page recommande cette séparation dès qu’un environnement héberge des données sensibles, un service exposé ou plusieurs équipes. L’exception raisonnable reste le laboratoire isolé et jetable, pas la production déguisée en prototype éternel.
Les principes d’identité et d’autorisation s’appliquent donc deux fois : une politique pour administrer, une autre pour exécuter. Réutiliser le même groupe d’annuaire pour les deux plans est une dette de sécurité, pas une simplification.
Cloisonnement réseau : empêcher le pivot vers l’administration
Section intitulée « Cloisonnement réseau : empêcher le pivot vers l’administration »L’erreur fréquente consiste à rendre l’API d’administration accessible depuis les sous-réseaux des workloads « pour faciliter l’automatisation ». Cette facilité donne à tout processus compromis une route vers l’interface qui gouverne sa propre plateforme. L’attaquant n’a plus qu’à chercher un jeton de service, une configuration de client ou un proxy mal filtré. Les slides appellent cela une surface unifiée. Les rapports d’incident appellent cela une autoroute.
Le plan de contrôle doit disposer d’un réseau d’administration distinct, avec des règles de filtrage explicites. L’accès à l’API Kubernetes doit provenir de bastions administratifs, de réseaux de livraison continue ou de points d’accès privés identifiés. Un pod applicatif ne devrait pas atteindre l’adresse de l’API, sauf besoin documenté et limité à une identité de service dédiée.
Dans le cloud, séparer au minimum :
- les comptes ou abonnements d’administration, de journalisation et de sécurité ;
- les réseaux de gestion et les réseaux hébergeant les données de production ;
- les points d’entrée d’administration et les équilibreurs publics ;
- les résolveurs, routes et règles pare-feu associés à chaque plan.
Une Virtual Private Cloud (VPC) ou un réseau virtuel unique peut contenir plusieurs sous-réseaux, mais ne constitue pas à lui seul une séparation suffisante. Si une identité de workload peut modifier les tables de routage, les groupes de sécurité ou les attachements réseau, la barrière réseau devient décorative. Elle a alors la valeur défensive d’un panneau « merci de ne pas pirater ».
Le cloisonnement doit être vérifié dans les deux sens. Bloquer les flux du plan de données vers l’administration est nécessaire ; empêcher une session d’administration compromise de se propager librement dans les workloads l’est aussi. Les postes et bastions d’administration accèdent aux API de contrôle, pas aux bases applicatives par défaut. L’accès aux données doit être accordé séparément, journalisé et temporaire.
Les principes de segmentation décrits dans les fondations réseau restent applicables : zones distinctes, routage explicite, filtrage par défaut et flux documentés. Un préfixe d’adresses différent aide au diagnostic ; il ne remplace ni une route absente ni une règle de refus.
Identités distinctes et moindre privilège par plan
Section intitulée « Identités distinctes et moindre privilège par plan »La séparation réseau échoue dès qu’une identité du plan de données détient des capacités de contrôle. Le jeton monté automatiquement dans un pod Kubernetes est l’exemple classique. S’il peut lire tous les Secrets, créer des pods ou attribuer des rôles, compromettre l’application revient à obtenir un levier de gestion du cluster.
Chaque charge de travail doit recevoir une identité propre, avec une durée de vie courte et des droits limités au service consommé. Les permissions doivent être définies par action, ressource et périmètre. Lire un objet métier dans un espace de noms ne justifie pas de lister les nœuds, d’exécuter dans d’autres espaces ou de modifier des rôles. Le contrôle d’accès fondé sur les rôles (RBAC, Role-Based Access Control) doit distinguer explicitement les opérations de lecture applicative, de déploiement et d’administration de plateforme.
Les administrateurs humains utilisent également des identités séparées. Une identité de consultation des journaux, une identité d’exploitation de workload et une identité de gestion de l’organisation cloud ne doivent pas être interchangeables. La fédération d’identité, par exemple OpenID Connect (OIDC), peut centraliser l’authentification sans fusionner les autorisations. Centraliser l’annuaire n’impose pas de centraliser le pouvoir. Cette confusion a produit assez de rôles AdministratorAccess pour alimenter un musée du regret.
Les comptes de service doivent respecter quatre règles :
- ne pas monter de jeton par défaut quand aucun appel d’API n’est requis ;
- préférer des jetons liés à une audience et à une durée limitée ;
- interdire l’escalade de privilèges, la création de rôles et l’accès aux secrets hors besoin démontré ;
- séparer les identités de déploiement, d’exécution et de supervision.
Le mécanisme ne garantit PAS qu’une application autorisée à lire une base ne puisse exfiltrer ses données. Il ne garantit pas non plus qu’un administrateur compromis ne puisse agir dans le périmètre exact de ses privilèges. La protection complémentaire vient du chiffrement, de la segmentation des données, de la détection comportementale, des validations de changement et de la revue des droits. Le contrôle des protocoles d’identité rappelle d’ailleurs une règle voisine : une authentification faible ruine toutes les frontières supposées exister après elle.
Exemple Kubernetes : bloquer un workload hors du plan de contrôle
Section intitulée « Exemple Kubernetes : bloquer un workload hors du plan de contrôle »Une politique réseau Kubernetes peut isoler un espace de noms applicatif : elle interdit tout trafic sortant par défaut, puis n’autorise que le service métier nécessaire. Elle suppose un greffon réseau appliquant réellement les NetworkPolicy, condition souvent oubliée jusqu’au jour où la politique ne fait rien, ce qui est une fonctionnalité étonnamment calme.
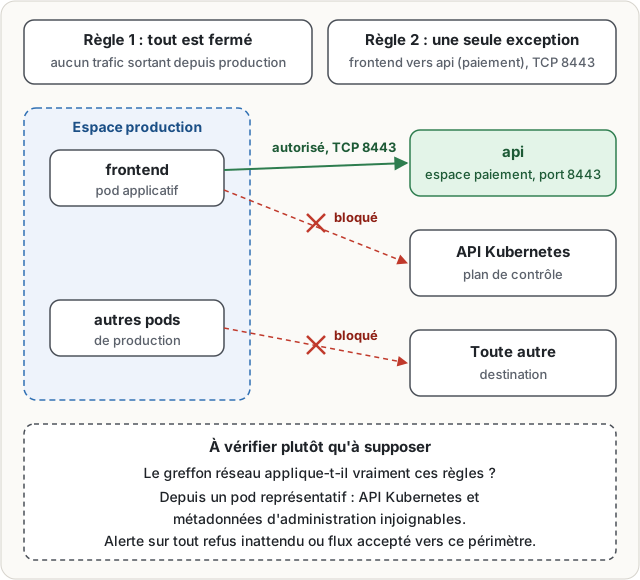
Cette politique ne suffit pas à elle seule. Le serveur d’API peut rester accessible par une adresse externe, un nœud peut fournir une route non couverte, ou une politique de réseau peut ne pas être appliquée par le greffon. Il faut tester depuis un pod représentatif que l’adresse de l’API et les métadonnées d’administration sont injoignables, puis alerter sur tout refus inattendu ou tout flux accepté vers ce périmètre.
Exploitation : secrets, supervision et reprise séparés
Section intitulée « Exploitation : secrets, supervision et reprise séparés »Les secrets du plan de contrôle exigent un traitement différent de ceux du plan de données. Une clé de déploiement capable de modifier une infrastructure n’a pas sa place dans une image de conteneur, dans une variable d’environnement durable ou dans le même coffre qu’un mot de passe applicatif. Les clés d’administration doivent être stockées dans un gestionnaire de secrets, protégées par authentification forte, auditées et soumises à rotation.
La rotation doit être conçue avant l’incident. Révoquer un certificat ou un jeton n’interrompt pas nécessairement les sessions déjà établies ; la durée de session, les caches de jetons et les connexions persistantes définissent le délai réel de retrait. Pour les identités de workload, privilégier des justificatifs de courte durée et renouvelables automatiquement. Pour les administrateurs, imposer une expiration, une validation d’accès et une traçabilité indépendante du système administré.
Les journaux du plan de contrôle doivent être exportés vers un compte ou un projet de sécurité séparé. Sinon, un administrateur compromis peut effacer les traces avec les ressources qu’il vient de modifier. Conserver au minimum les appels d’API, changements de politique, créations d’identité, élévations de privilèges, modifications réseau et accès aux secrets. Une alerte sur la création d’un rôle très privilégié par une identité de workload mérite une priorité élevée, pas une place dans le cimetière des alertes à lire vendredi.
La sauvegarde du plan de contrôle est distincte de la sauvegarde des données. Sauvegarder etcd, les manifestes, les politiques d’accès, les configurations réseau et les journaux d’audit. Tester la restauration dans un environnement isolé : restaurer les données sans les politiques recrée un système qui fonctionne, puis un système qui expose tout. Les architectures cloud doivent aussi sauvegarder les configurations d’organisation, les politiques de contrôle de service et les définitions d’identité, pas seulement les volumes.
🐝 Ce qui arrive si on s’en passe
Section intitulée « 🐝 Ce qui arrive si on s’en passe »Sans cette séparation, l’analyse post-incident perd sa valeur : lorsqu’une même identité déploie, exécute et administre, les journaux ne permettent plus de distinguer une action légitime de pipeline d’une action d’attaquant, et l’attribution devient une hypothèse. Le confinement se dégrade aussi : isoler un workload compromis oblige à couper des chemins qui servent simultanément à l’administration, ce qui interdit d’intervenir sans interrompre la reprise. La rotation d’un justificatif partagé entraîne l’arrêt simultané des déploiements, des sondes et des applications, donc son report indéfini. Enfin, le périmètre de reconstruction s’étend : faute de frontière démontrable, il faut considérer l’ensemble des espaces de noms, des rôles et des secrets comme suspects, au lieu du seul composant touché.
🦫 Explication de la marmotte 🍫
Section intitulée « 🦫 Explication de la marmotte 🍫 »Une infrastructure contient deux catégories d’actions. La première fait fonctionner les applications : recevoir des demandes, enregistrer des données, envoyer des messages et calculer des résultats. La seconde décide de ce que l’infrastructure a le droit de faire : créer une machine, donner un droit, changer une règle réseau ou lire un secret.
Le problème apparaît quand une application compromise peut atteindre les outils qui prennent ces décisions. Un attaquant commence alors par contrôler un programme de production. Il cherche ensuite un mot de passe, un jeton d’accès ou une route réseau permettant de modifier les règles générales. S’il y arrive, il peut créer de nouveaux accès, copier des secrets ou changer les protections. L’incident ne reste plus limité au programme initial.
La séparation impose donc des réseaux différents, des comptes différents et des autorisations différentes. Les programmes de production ne peuvent joindre que les services nécessaires à leur travail. Les personnes qui administrent l’infrastructure passent par des accès réservés et enregistrés. Les programmes reçoivent des droits limités et temporaires.
Cette organisation ne protège pas les données qu’une application est déjà autorisée à lire. Elle ne bloque pas non plus un administrateur ayant encore tous ses droits. Elle réduit surtout la possibilité de transformer une intrusion locale en contrôle total. Les accès, journaux, sauvegardes et procédures de récupération doivent aussi rester séparés, sinon la frontière disparaît au premier incident.
À lire aussi
- Sécuriser l’auto-scaling des instances éphémèresArchitecture cloud-native d’auto-scaling et sécurité des instances qui apparaissent et disparaissent dynamiquement.
- Auditer et durcir un cluster Kubernetes avec kube-benchGuide pratique pour auditer un cluster Kubernetes existant avec kube-bench, prioriser les écarts CIS et conduire la remédiation sans casser l'exploitation.
- PAM, JIT et comptes break-glass sécurisésConcevoir une gestion des privilèges moderne avec coffre-fort de secrets, accès juste-à-temps, sessions enregistrées, comptes de secours et séparation des plans de contrôle.
- Pourquoi le moindre privilège échoue en productionDossier d'enquête sur l'écart entre le principe du moindre privilège enseigné et l’octroi réel de droits excessifs pour accélérer l’exploitation.
Pages voisines
La citent
- PAM, JIT et comptes break-glass sécurisés
- Auditer l'héritage des permissions et le droit effectif
- DAC, MAC, RBAC, ABAC ou ReBAC : quel modèle choisir
- Kerberos et KDC dans Active Directory, attaques et durcissement
- Comment exploiter le Global Risks Report du Forum économique mondial
- Comment limiter le mouvement latéral après compromission
- Concevoir une défense en profondeur par couches
- Couches, normes et vocabulaire de paquets
- Déployer FIDO2 pour comptes à privilèges
Séparer plan de contrôle et plan de données
Elle cite