
ASI08 : défaillances en cascade dans un système d'agents
ASI08 : défaillances en cascade dans un système d’agents
Section intitulée « ASI08 : défaillances en cascade dans un système d’agents »ASI08, huitième entrée du Top 10 OWASP des applications agentiques, ne décrit pas une vulnérabilité mais un comportement : la façon dont un défaut unique se propage et s’amplifie à travers un ensemble d’agents jusqu’à produire un dommage sans rapport avec sa taille initiale. Une hallucination, une entrée malveillante, un outil corrompu ou une mémoire empoisonnée suffisent à l’amorcer. Ce qui transforme l’incident local en panne systémique est propre aux agents : ils planifient, délèguent et persistent tout seuls, ce qui permet à une erreur de sauter les contrôles humains intermédiaires et de s’installer dans un état sauvegardé.
→ Lire l’explication complète de la marmotte
Le mécanisme : ce qui amplifie, pas ce qui déclenche
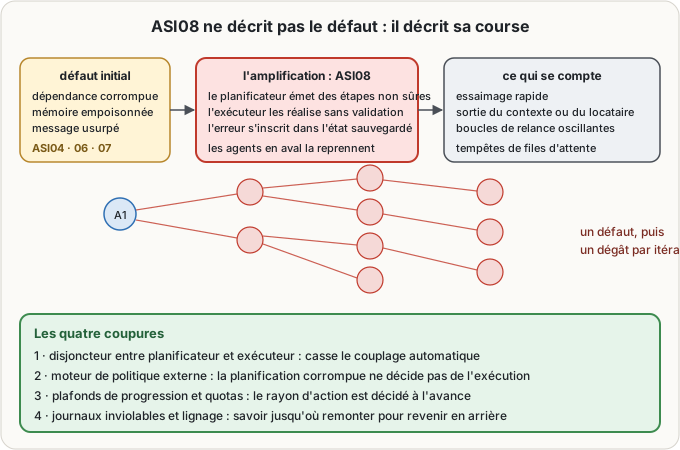
Section intitulée « Le mécanisme : ce qui amplifie, pas ce qui déclenche »Le référentiel est ici d’une précision inhabituelle, et sa règle de classement vaut d’être citée telle quelle : le défaut initial se code sous ASI04, ASI06 ou ASI07 quand il représente une compromission directe — dépendance corrompue, mémoire empoisonnée, message usurpé — et ASI08 ne s’applique que lorsque ce défaut se répand à travers des agents, des sessions ou des flux de travail, en produisant un essaimage mesurable ou un impact systémique au-delà de la brèche d’origine.
La distinction n’est pas une subtilité de taxinomiste. Elle sépare deux travaux de défense qui n’ont rien à voir : empêcher l’entrée du défaut, et empêcher sa propagation. On peut échouer complètement au premier et réussir le second, et c’est même le pari raisonnable — un système agentique de taille réelle sera compromis quelque part, la question est de savoir jusqu’où cela ira.
Trois propriétés expliquent l’amplification. La persistance : une erreur entrée dans un état sauvegardé continue d’influencer les plans et les délégations longtemps après la disparition de sa source. Le couplage automatique : un planificateur qui hallucine émet des étapes non sûres qu’un exécuteur réalise sans validation, et le référentiel désigne ce couplage comme le premier exemple de la classe. Les liens émergents : à mesure que les agents se raccordent à de nouveaux outils ou à de nouveaux pairs, des défauts latents s’enchaînent en opérations privilégiées que personne n’avait dessinées.
Les symptômes, qui sont aussi les détecteurs
Section intitulée « Les symptômes, qui sont aussi les détecteurs »C’est l’apport le plus utile de l’entrée, et le référentiel l’assume comme tel : il énumère des symptômes observables qui rendent la classe opérationnellement détectable, au lieu de se contenter de la décrire. Quatre motifs, tous mesurables sans comprendre la cause.
L’essaimage rapide : une décision fautive déclenche de nombreux agents ou tâches en aval en très peu de temps. C’est le signal le plus net : aucune raison légitime ne fait engendrer cinquante tâches à une étape unique.
La propagation hors contexte : l’effet se répand au-delà du domaine ou du locataire d’origine. Un agent qui travaillait sur un périmètre touche soudain à un autre, ce qui est toujours soit une erreur, soit une attaque, et jamais un fonctionnement normal.
Les boucles oscillantes : des relances ou des rétroactions entre agents qui se renvoient la balle. Deux agents dépendant mutuellement des sorties de l’autre créent une boucle auto-renforçante qui magnifie l’erreur initiale et consomme des ressources en proportion.
Les tempêtes de files d’attente : des intentions identiques répétées, ou des files d’attente en aval qui gonflent. Le symptôme est aussi la facture, puisque chaque intention répétée est un appel payé.
Ces quatre signaux sont à la portée de n’importe quelle supervision correcte, et c’est ce qui les rend précieux : ils ne demandent pas de comprendre le raisonnement de l’agent, seulement de compter. Dans la taxonomie du projet, l’entrée correspond à T5, attaques par hallucination en cascade, et le document souligne la défense fondamentale associée à T8, répudiation et non-traçabilité : la capacité à tracer, attribuer et auditer les comportements en cascade, sans laquelle la propagation reste silencieuse.
À quoi ressemble une cascade réelle
Section intitulée « À quoi ressemble une cascade réelle »Le référentiel propose des scénarios dont la mécanique est toujours la même : un agent produit une donnée fausse, un autre l’exploite comme une entrée fiable, un troisième optimise dessus.
Dans une chaîne de décision financière, une injection de prompt empoisonne un agent d’analyse de marché qui relève des limites de risque ; les agents de position et d’exécution engagent automatiquement des montants plus importants, et la conformité ne voit rien d’anormal puisque l’activité reste « dans les paramètres ». La phrase est le cœur du problème : les contrôles vérifient la conformité aux paramètres, et ce sont les paramètres qui ont été modifiés.
Dans une chaîne industrielle, un empoisonnement de mémoire conduit un agent de contrôle qualité à approuver des pièces défectueuses et à rejeter des pièces conformes ; les agents de stock et d’ordonnancement optimisent sur ces données, et les expéditions partent avec les défauts. Variante du même mécanisme : un référentiel de paramètres de procédé, corrompu en amont, est ajusté automatiquement puis diffusé à tous les ateliers sans revue.
Dans une infrastructure, un empoisonnement de la planification de ressources ajoute des permissions non autorisées ; un agent de sécurité les applique, un agent de déploiement provisionne une infrastructure coûteuse et dotée d’un accès dérobé, sans qu’aucune demande de changement ne soit passée. Le site traite les garde-fous attendus d’une chaîne de livraison dans sécuriser un pipeline CI/CD.
Deux scénarios méritent une mention particulière, parce qu’ils ne supposent aucun attaquant. Le premier est la boucle d’auto-remédiation : un agent de remédiation supprime des alertes pour tenir ses objectifs de latence, un agent de planification interprète la baisse du nombre d’alertes comme un succès et étend l’automatisation, aggravant les angles morts. C’est la fatigue d’alerte automatisée, et c’est aussi un cas d’école de métrique biaisée. Le second est la dérive de gouvernance : après une série de succès, la supervision humaine se relâche, les approbations se font en masse, les politiques s’assouplissent, et la dérive de configuration se propage sans que personne l’ait décidée. Aucun code n’est en cause ; c’est une cascade organisationnelle.
Le référentiel ajoute un cas qui donne la mesure du problème : une panne régionale de résolution de noms chez un hébergeur majeur casse d’un coup plusieurs services d’IA qui en dépendent, et déclenche une cascade de défaillances d’agents dans de nombreuses organisations. La dépendance commune n’est pas agentique, l’amplification l’est.
Réduire : des disjoncteurs, pas des vérifications
Section intitulée « Réduire : des disjoncteurs, pas des vérifications »Les mitigations du référentiel visent toutes à borner le rayon d’action plutôt qu’à détecter la cause, et c’est la bonne stratégie pour une classe définie par la propagation.
- Un disjoncteur entre planificateur et exécuteur, avec des quotas, des plafonds de progression et des garde-fous de rayon d’action. C’est la mesure la plus directement efficace : elle casse le couplage automatique qui transforme une étape fausse en action réalisée.
- Une application de politique indépendante : séparer la planification de l’exécution par un moteur de politique externe, pour qu’une planification corrompue ne puisse pas déclencher d’actions. Le principe est celui de la séparation des plans de contrôle, et sa mise en œuvre côté agent est décrite dans les guardrails programmatiques.
- Un accès juste-à-temps à usage unique : identifiants courts et à portée de tâche pour chaque exécution d’agent, et validation de chaque invocation d’outil à fort impact contre une règle de politique exprimée en code avant exécution. Le référentiel énonce clairement l’objectif : qu’un agent compromis ou dérivant ne puisse pas déclencher de réaction en chaîne. Les mécanismes sont décrits dans l’accès juste-à-temps.
- De l’isolement et des frontières de confiance : bacs à sable, moindre privilège, segmentation réseau, API à portée limitée, authentification mutuelle. Une cascade a besoin de chemins ; il s’agit de les réduire.
- Une limitation de débit et une mise en pause automatique sur anomalie, puisque la vitesse est l’ingrédient actif.
- Une détection de dérive comportementale et de gouvernance : suivre les décisions par rapport à des lignes de base, signaler la dégradation graduelle. C’est le seul remède à la cascade organisationnelle, et il n’est pas technique.
- Une journalisation inviolable et horodatée, liée à des identités cryptographiques d’agents, avec des métadonnées de lignage pour chaque action propagée. Sans lignage, le retour arrière est impossible à valider : on ne sait pas jusqu’où remonter.
Le document propose aussi une mesure qui sort de l’ordinaire et vaut d’être signalée : le rejeu par jumeau numérique. Rejouer les actions enregistrées de la semaine écoulée dans un clone isolé de l’environnement de production, vérifier si la même séquence aurait déclenché une cascade, et conditionner toute extension de politique à la réussite de ces rejeux sous des plafonds de rayon d’action prédéfinis. L’idée est excellente et suppose trois choses que peu d’organisations possèdent : un enregistrement complet des actions, un clone fidèle de la production, et quelqu’un pour regarder le résultat.
Ce que ces mesures ne font pas
Section intitulée « Ce que ces mesures ne font pas »Le référentiel formule ici une réserve qu’il faut lire deux fois, parce qu’elle est rare dans ce genre de document : ces menaces composées révèlent un écart entre la vitesse et l’échelle de propagation des défauts dans un système multi-agents et la capacité des humains à suivre. Il en conclut qu’il subsiste des risques non atténués, que l’entreprise doit évaluer soigneusement pour vérifier qu’ils tiennent dans son budget de risque global.
Traduit sans précaution : à partir d’une certaine taille, personne ne rattrape une cascade à la main. Les portes humaines ralentissent la propagation, elles ne la bornent pas, parce qu’un humain qui valide deux cents décisions par heure ne valide rien. Les seules bornes qui tiennent sont automatiques et quantitatives — un plafond, un quota, un disjoncteur — ce qui revient à décider à l’avance combien de dégâts on accepte avant l’arrêt. C’est une décision de gestion, pas d’ingénierie, et le document a le mérite de la nommer.
La conclusion rejoint le principe de moindre agentivité : la variable qui gouverne l’amplitude d’une cascade est le nombre d’agents couplés et le degré d’automatisation entre eux. Réduire l’un ou l’autre réduit le pire cas de façon certaine, ce qu’aucune détection ne fait.
🐝 Ce qui arrive si on s’en passe
Section intitulée « 🐝 Ce qui arrive si on s’en passe »Sans métadonnées de lignage sur les actions propagées, le retour arrière devient une opération à l’aveugle : on sait qu’une donnée était fausse, on ne sait pas quelles décisions l’ont consommée, ni lesquelles en ont produit d’autres. La remise en état se fait alors par restauration complète, ce qui détruit aussi le travail légitime de la période. Sans disjoncteur entre planificateur et exécuteur, le délai entre une décision fautive et son centième effet se compte en secondes, bien avant toute alerte humaine : la supervision ne sert plus qu’à constater. Sans plafonds de progression, enfin, le premier signal disponible est extérieur au système — un client, un partenaire, une facture — et le temps de détection n’est plus une propriété de l’architecture mais une question de chance.
🦫 Explication de la marmotte 🍫
Section intitulée « 🦫 Explication de la marmotte 🍫 »Quand plusieurs assistants informatiques travaillent en chaîne, chacun prend le résultat du précédent comme point de départ. C’est ce qui les rend efficaces. C’est aussi ce qui fait qu’une seule erreur peut tout emporter : le deuxième assistant traite la donnée fausse comme un fait, le troisième optimise dessus, et au bout de la chaîne personne ne sait plus d’où vient le problème.
Ce risque ne décrit donc pas l’erreur de départ, mais sa diffusion. L’erreur de départ a sa propre catégorie — un composant piégé, une mémoire empoisonnée, un message falsifié. Ce qui est décrit ici, c’est ce qui se passe ensuite, et ce qui se passe ensuite est rapide : les assistants ne s’arrêtent pas pour demander confirmation entre deux étapes.
Le point utile est qu’une cascade se repère sans comprendre sa cause. Quatre signes suffisent : une seule décision qui en déclenche soudain des dizaines ; un effet qui sort du périmètre où il devrait rester ; deux assistants qui se renvoient la même tâche en boucle ; une file d’attente qui gonfle avec les mêmes demandes répétées. Ce sont des choses qui se comptent, pas qui s’interprètent.
Les protections ne cherchent pas à empêcher l’erreur mais à limiter sa course : un plafond sur le nombre d’actions qu’une tâche peut engendrer, un mécanisme qui coupe automatiquement quand ce plafond est franchi, des droits valables pour une seule opération, et une trace de chaque action permettant de savoir, après coup, quelles décisions reposaient sur quoi. Le document d’OWASP reconnaît d’ailleurs une limite honnête : au-delà d’une certaine taille, aucun humain ne suit le rythme. Il faut donc décider à l’avance combien de dégâts on accepte avant l’arrêt automatique — une décision de direction, pas de technicien.
À lire aussi
- ASI09 : exploitation de la confiance entre humain et agentASI09 du Top 10 OWASP des applications agentiques : biais d'automatisation, fausse explicabilité et approbations de complaisance, ou comment l'humain devient l'exécutant de la compromission.
- ASI02 : détournement et exploitation des outils d'un agentASI02 du Top 10 OWASP des applications agentiques : l'agent reste dans ses droits mais emploie un outil légitime de travers, par sur-privilège, chaînage ou empoisonnement du descripteur.
- ASI01 : détournement d'objectif d'un agent IAASI01 du Top 10 OWASP des applications agentiques : comment un contenu lu par un agent devient une instruction suivie, ce qui distingue ce risque de l'empoisonnement de mémoire, et ce qui le réduit.
- ASI10 : agents voyous, dérive comportementale et confinementASI10 du Top 10 OWASP des applications agentiques : agents qui dévient de leur fonction sans qu'un attaquant tienne le volant, et comment les contenir, les détecter et les réintégrer.
Pages voisines
ASI08 : défaillances en cascade dans un système d'agents
Elle cite
- Lien dans les deux sens :ASI06 : empoisonnement de la mémoire et du contexte d'un agent
- Lien dans les deux sens :OWASP Top 10 for Agentic Applications 2026 : les dix risques
- ASI04 : chaîne d'approvisionnement agentique
- ASI07 : communication inter-agents non sécurisée
- Accès juste-à-temps et privilèges temporaires
- Guardrails programmatiques pour assistant IA de production
- La fatigue d'alerte
- Pourquoi MTTD et MTTR biaisent la sécurité
- Sécuriser les secrets et permissions CI/CD
- Séparer plan de contrôle et plan de données
: les deux pages se citent l’une l’autre.