
ITIL : incidents, changements et problèmes vus de la sécurité
ITIL : incidents, changements et problèmes vus de la sécurité
Section intitulée « ITIL : incidents, changements et problèmes vus de la sécurité »ITIL (Information Technology Infrastructure Library) est le cadre de bonnes pratiques le plus répandu pour organiser la gestion des services informatiques : qui rétablit un service tombé, qui autorise une modification, qui cherche pourquoi la même panne revient. Ce n’est pas une démarche de sécurité, et il ne garantit ni la sécurité ni la conformité. Pourtant trois de ses pratiques (changements, incidents, configuration) conditionnent directement ce qu’une équipe sécurité peut contrôler, tracer et reconstruire.
→ Lire l’explication complète de la marmotte
ITIL (Version 5) et ITIL 4 : version courante et base installée
Section intitulée « ITIL (Version 5) et ITIL 4 : version courante et base installée »ITIL appartient à PeopleCert, qui a racheté en 2021 AXELOS, la coentreprise créée en 2013 par le Cabinet Office britannique et Capita pour détenir le référentiel. C’est PeopleCert qui publie le cadre et délivre les certifications.
La version courante s’appelle ITIL (Version 5), parenthèses comprises : le nom de marque est exact, et les fiches de poste qui écrivent « ITIL 5 » trahissent surtout qu’elles ont été rédigées avant de lire. Publiée par PeopleCert début 2026, elle se déploie par étapes, avec des modules et certifications échelonnés sur l’année. Elle remplace le Système de valeur des services d’ITIL 4 par un modèle de cycle de vie des produits et services (Product and Service Lifecycle Model). Elle élargit le propos de l’exploitation informatique vers la gestion des produits et services numériques à l’échelle de l’entreprise, et intègre l’IA (intelligence artificielle) et le cloud dans toute la trame. Cinq modules de certification l’accompagnent : ITIL Product, ITIL Service, ITIL Experience, ITIL Strategy et ITIL Transformation.
ITIL 4, paru en 2019, reste la base installée. C’est lui qui structure la plupart des outils ITSM (IT Service Management) en production, des processus documentés et des contrats d’infogérance. Il a introduit le Système de valeur des services (SVS, Service Value System), les quatre dimensions de la gestion des services, la chaîne de valeur des services, les principes directeurs et 34 pratiques, parmi lesquelles la gestion des incidents, la gestion des changements, la gestion des problèmes, le centre de services et la gestion des actifs et des configurations.
Il ne faut ni jeter ITIL 4, ni le présenter comme la version du jour. Le changement de modèle conceptuel touche le pilotage et la formation ; il ne rend pas obsolète un processus de changement qui fonctionne. Le cœur du sujet traité ici (cycle de vie d’un service, incidents, changements, problèmes) traverse les versions. Une organisation outillée en ITIL 4 n’a aucune raison sécurité de migrer en urgence ; elle a d’excellentes raisons de vérifier que ses processus existants servent vraiment de point de contrôle.
Cycle de vie d’un service et prérequis de mise en œuvre
Section intitulée « Cycle de vie d’un service et prérequis de mise en œuvre »Le cycle de vie d’un service va de sa conception à son retrait, en passant par la mise en service, l’exploitation et les évolutions. Vu de la sécurité, chaque transition est un moment où un contrôle peut s’appliquer ou être oublié.
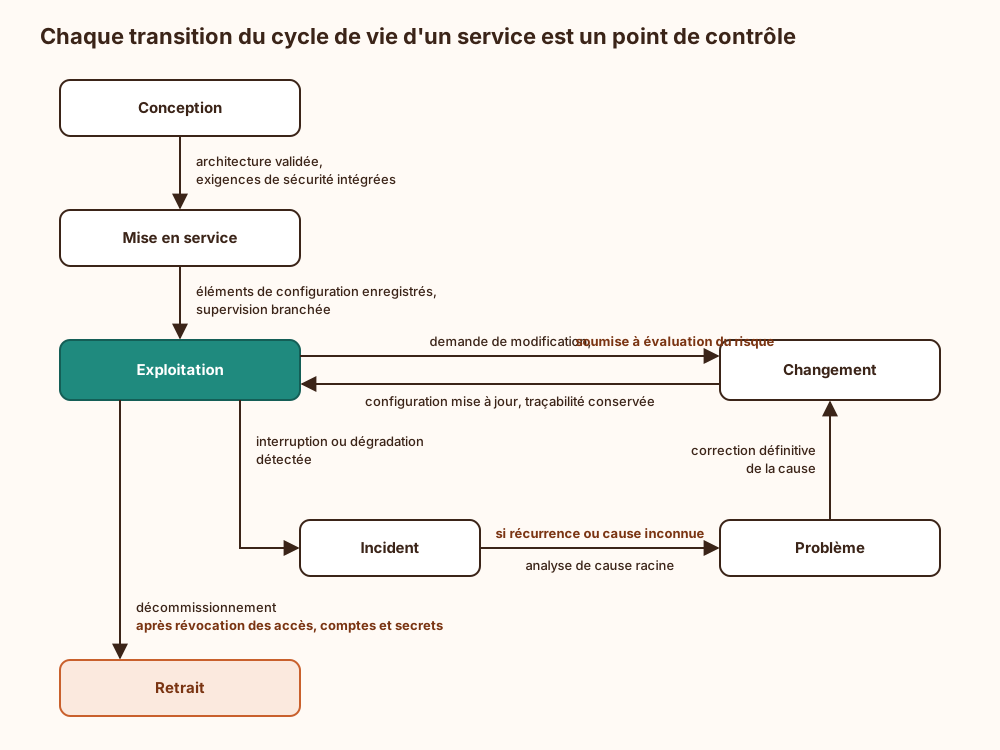
À lire : la boucle incident, problème, changement est le moteur du cadre, et le retrait est l’étape la plus souvent bâclée. Un service retiré dont les comptes de service, les certificats et les règles de pare-feu survivent devient une surface d’attaque orpheline, sans propriétaire pour la surveiller.
Avant de déployer ces pratiques, plusieurs éléments doivent exister :
- Un catalogue de services avec un propriétaire nommé par service. Sans propriétaire, personne ne peut accepter un risque de changement ni prioriser un incident.
- Une notion de criticité partagée avec l’analyse de risque. La priorité d’un incident (impact × urgence) doit reprendre les valeurs métier identifiées par l’analyse de risque, sinon le centre de services et l’équipe sécurité classent les mêmes actifs sur deux échelles qui ne se parlent pas. La page sur EBIOS RM et ses limites détaille d’où viennent ces valeurs.
- Un outil ITSM et un référentiel d’identités fédéré. L’outil doit authentifier ses utilisateurs via l’annuaire central avec MFA (Multi-Factor Authentication) ; un outil de tickets à comptes locaux finit toujours avec des comptes de prestataires partis depuis longtemps.
- Des sources de découverte automatique (inventaire réseau, API (Application Programming Interface) des fournisseurs cloud, agents de poste) pour alimenter la base de configuration, faute de quoi elle sera saisie à la main, donc fausse.
Le compromis central se pose ici. ITIL achète de la traçabilité et du contrôle ; il les paie en délai et en charge administrative. La position défendue sur cette page : adopter sérieusement quatre pratiques (changements, incidents, problèmes, configuration), automatiser leur alimentation, et refuser l’implémentation exhaustive des 34 pratiques tant que ces quatre-là ne tiennent pas. Un référentiel déployé en entier et rempli à moitié produit surtout des tableaux de bord.
Gestion des changements : le point de contrôle sécurité d’ITIL
Section intitulée « Gestion des changements : le point de contrôle sécurité d’ITIL »La gestion des changements (renommée « habilitation des changements » dans ITIL 4) est la seule pratique ITIL qui empêche quelque chose d’arriver. Les autres constatent, rétablissent ou expliquent ; celle-ci autorise ou refuse. C’est donc là qu’une exigence de sécurité peut devenir bloquante.
ITIL distingue trois types de changements :
- Standard : à faible risque, préapprouvé, répétable (ajout d’un utilisateur à un groupe, déploiement par un pipeline validé).
- Normal : évalué au cas par cas, éventuellement par un CAB (Change Advisory Board), comité qui examine les demandes à risque.
- D’urgence : à appliquer sans délai pour rétablir un service ou corriger une vulnérabilité exploitée, avec une autorité d’approbation réduite (souvent un ECAB, Emergency CAB, de deux ou trois personnes).
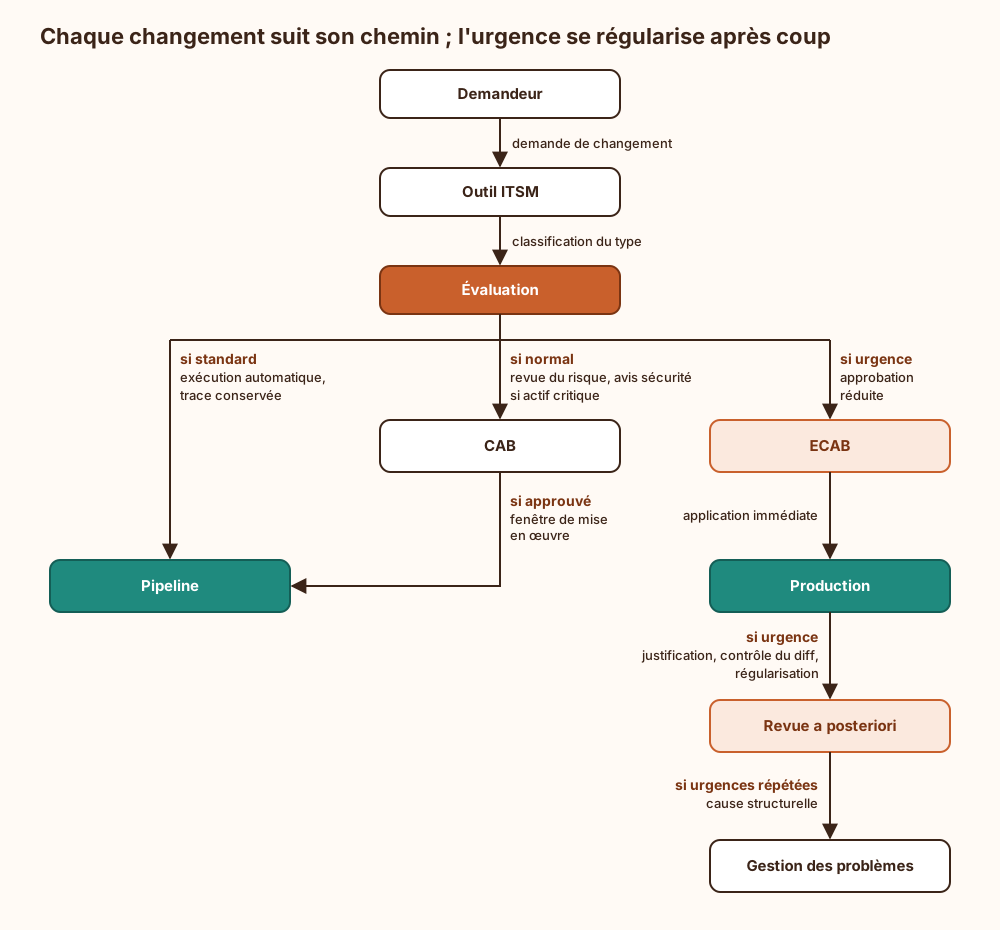
À lire : la branche urgence contourne la revue, et la seule chose qui la rattrape est la revue a posteriori. Sans elle, le circuit d’urgence devient la voie normale de tout ce qui est pressé.
C’est la dérive classique, et elle obéit à une règle vérifiable : quand le délai d’un changement normal dépasse la patience des équipes, la proportion de changements d’urgence augmente, et avec elle la part de modifications de production jamais revues. Le CAB hebdomadaire qui examine quatre-vingts tickets en une heure ne contrôle rien ; il certifie que quelqu’un était présent dans la salle. Vingt ans de métier apprennent que le changement le plus dangereux de la semaine est rarement celui qui passe en CAB : c’est celui qui n’avait pas besoin d’y passer, selon son auteur.
Ce qu’il faut faire, concrètement :
- Classer en standard tout ce qui passe par un pipeline d’infrastructure as code revu par un pair. La revue de code devient l’approbation ; le ticket est créé automatiquement par le pipeline, avec le lien vers le commit. Le CAB se concentre sur ce qui ne passe pas par un pipeline.
- Exiger un avis sécurité nominatif pour tout changement normal touchant les flux réseau d’une zone exposée, les droits privilégiés, la gestion de clés ou l’authentification.
- Imposer une revue a posteriori de chaque changement d’urgence dans un délai fixé, avec comparaison entre ce qui a été déclaré et ce qui a été réellement modifié.
- Mesurer la proportion de changements d’urgence et la traiter comme un indicateur de dysfonctionnement, pas comme un indicateur de réactivité. La page sur les indicateurs de sécurité utiles ou de façade développe ce piège.
- Rapprocher les changements déclarés des changements observés. Une modification de règle de pare-feu ou de stratégie de groupe sans ticket correspondant est soit une erreur de processus, soit une compromission. Les deux méritent une alerte.
Ce rapprochement est ce qui donne de la valeur sécurité au processus : un registre des changements autorisés transforme toute modification hors registre en signal de détection. Le règlement (UE) 2022/2554 (DORA) exige d’ailleurs des entités financières une gestion des changements TIC (technologies de l’information et de la communication) documentée et contrôlée, détaillée à l’article 38 de son règlement délégué (UE) 2024/1774 ; voir la page DORA et la résilience opérationnelle numérique.
Gestion des incidents ITIL et réponse à incident de sécurité
Section intitulée « Gestion des incidents ITIL et réponse à incident de sécurité »La gestion des incidents ITIL a un objectif unique : rétablir le service le plus vite possible, dans le respect des SLA (Service Level Agreement, engagements de niveau de service). La réponse à incident de sécurité a un objectif différent : comprendre ce qui s’est passé, contenir l’attaquant, préserver les preuves, puis remédier. Ce ne sont pas les mêmes métiers, et leurs réflexes s’opposent.
Le réflexe ITIL face à un serveur instable est de le redémarrer, de le restaurer depuis une sauvegarde ou de le reconstruire depuis une image. Chacune de ces actions détruit la mémoire vive, écrase les journaux locaux et efface les traces de persistance que l’équipe d’investigation aurait analysées. Le technicien qui rétablit le service en dix minutes a parfaitement appliqué sa procédure ; il a aussi fait disparaître la seule copie de l’outil de l’attaquant. Personne n’a commis de faute, et c’est précisément le problème.
Les règles qui en découlent :
- Le centre de services doit disposer de critères de requalification : un incident de disponibilité devient un incident de sécurité potentiel dès qu’apparaissent certains signaux (alerte EDR (Endpoint Detection and Response) sur l’hôte, compte de service utilisé hors de son périmètre, chiffrement massif de fichiers, modification non tracée en gestion des changements).
- La requalification suspend les actions destructrices sur les actifs concernés jusqu’à l’accord du CSIRT (Computer Security Incident Response Team) ou de l’équipe d’investigation, sauf danger immédiat pour le métier, décidé et tracé.
- Les deux circuits partagent le même ticket ou des tickets liés, pour que la chronologie soit reconstructible.
- Les incidents de sécurité sensibles ne se documentent pas dans un ticket visible de tout le centre de services. Un outil ITSM où des centaines de techniciens et de prestataires lisent tous les tickets est un excellent moyen de prévenir l’attaquant qu’il a été repéré, s’il a compromis un de ces comptes.
Les délais de notification réglementaires (directive (UE) 2022/2555, dite NIS 2, article 23 ; DORA pour le secteur financier) courent à partir de la prise de connaissance d’un incident significatif. Un incident resté classé en « panne » dans l’outil ITSM retarde cette prise de connaissance sans la suspendre juridiquement. La page notification d’incident, délais et obligations détaille ces échéances ; elle cite les textes sans trancher de cas particulier.
Gestion des problèmes et analyse de cause racine
Section intitulée « Gestion des problèmes et analyse de cause racine »Un problème, au sens ITIL, est la cause sous-jacente d’un ou plusieurs incidents. La gestion des problèmes mène l’analyse de cause racine (RCA, Root Cause Analysis), enregistre les « erreurs connues » et leurs contournements dans une base dédiée (KEDB, Known Error Database), puis déclenche un changement pour corriger la cause.
Pour la sécurité, cette pratique est sous-exploitée. Une vulnérabilité exploitée deux fois de la même manière n’est pas deux incidents, c’est un problème ouvert. La mauvaise configuration qui réapparaît après chaque redéploiement relève de la gestion des problèmes, pas d’un ticket refermé à chaque passage. Les incidents de sécurité clos sans analyse de cause racine alimentent directement la dette de sécurité.
Deux mises en garde. D’abord, une analyse de cause racine qui conclut à « l’erreur humaine » est une analyse arrêtée trop tôt : la question suivante est toujours « pourquoi le système a-t-il laissé passer cette erreur ? ». Ensuite, la KEDB documente souvent des contournements de sécurité (« désactiver la vérification du certificat pour rétablir la connexion ») ; elle doit donc être relue par l’équipe sécurité, faute de quoi elle devient un manuel officiel de contournement, validé par le processus et consulté avec gratitude par chaque nouvel arrivant.
CMDB : l’inventaire d’actifs qu’on croit avoir
Section intitulée « CMDB : l’inventaire d’actifs qu’on croit avoir »La CMDB (Configuration Management Database) recense les éléments de configuration (CI, Configuration Items : serveurs, applications, bases, certificats, contrats) et leurs dépendances. En théorie, c’est l’inventaire d’actifs dont toute démarche de sécurité a besoin : on ne protège pas ce qu’on ne connaît pas, et l’article 21 de NIS 2 suppose une maîtrise des actifs que seul un inventaire tenu rend possible. ITIL dit qu’il faut la tenir, sans fixer ce qu’elle relie ; IT4IT prescrit ces objets de données et leurs liens, de l’incident à l’instance déployée.
En pratique, une CMDB alimentée à la main est fausse dès sa mise en service et diverge ensuite de façon monotone. Elle sous-représente systématiquement ce qui échappe aux processus : ressources cloud créées hors pipeline, informatique fantôme, comptes de service, dépendances SaaS. Elle donne l’impression d’un inventaire complet, ce qui est pire que l’absence d’inventaire, car personne ne cherche ce qui manque.
Les règles d’exploitation :
- Alimenter par découverte automatique, et réserver la saisie manuelle aux attributs non découvrables (propriétaire, criticité métier).
- Rapprocher plusieurs sources (CMDB, console EDR, inventaire cloud, annuaire, scanner de vulnérabilités) et traiter chaque écart comme un actif non géré jusqu’à preuve du contraire.
- Conserver l’historique des CI : en investigation, la question n’est pas « quelle est la configuration ? » mais « quelle était-elle à telle heure ? ».
- Ne pas exiger de la CMDB une exhaustivité qu’elle n’atteindra pas. Mieux vaut une CMDB fiable sur les actifs critiques qu’une CMDB complète en apparence sur tout.
Surface d’attaque de l’outillage ITSM
Section intitulée « Surface d’attaque de l’outillage ITSM »L’outil ITSM concentre la cartographie du système d’information, les relations entre actifs, les procédures d’intervention et souvent des intégrations privilégiées. Pour un attaquant, c’est un plan détaillé du bâtiment, livré avec la liste des clés.
| Attaque connue | Mécanisme | Contre-mesure |
|---|---|---|
| Ingénierie sociale du centre de services | Un appel au support obtient la réinitialisation d’un mot de passe ou d’un facteur MFA pour un compte ciblé | Vérification d’identité forte avant toute réinitialisation, rappel sur un canal enregistré, procédure renforcée pour les comptes privilégiés |
| Secrets dans les tickets | Mots de passe, clés d’API ou fichiers de configuration collés en clair dans un ticket ou une pièce jointe | Détection automatique de secrets dans les tickets, purge, rotation systématique du secret exposé |
| Comptes d’intégration surprivilégiés | Les connecteurs de découverte et d’orchestration détiennent des droits d’administration sur l’infrastructure | Droits minimaux par connecteur, secrets stockés dans un coffre, rotation planifiée, journalisation des appels |
| Reconnaissance via la CMDB | Un compte utilisateur compromis lit la topologie, les versions et les dépendances | Contrôle d’accès par rôle sur les CI, restriction des attributs sensibles |
| Falsification du registre des changements | Un attaquant crée ou approuve un ticket pour légitimer une modification | Séparation demandeur et approbateur, approbation imposant une authentification renforcée, journaux d’audit exportés hors de l’outil |
| Automatisation abusée | Un flux d’auto-remédiation exécute des actions privilégiées déclenchées par un champ de ticket | Validation des entrées, liste fermée d’actions, revue des flux comme du code |
La première ligne mérite qu’on s’y arrête : la réinitialisation d’identifiants par le support est un vecteur d’intrusion documenté et récurrent, parce que la procédure est conçue pour rendre service vite à quelqu’un qui dit être bloqué. La pratique ITIL du centre de services optimise la satisfaction de l’appelant ; elle doit être bridée explicitement sur ce point.
Ce qu’ITIL ne garantit pas
Section intitulée « Ce qu’ITIL ne garantit pas »ITIL ne garantit ni la sécurité ni la conformité. Il garantit au mieux que les actions sont tracées et passent par un circuit défini, à condition que ce circuit soit respecté.
- Pas de sécurité intrinsèque. Un changement dangereux, correctement approuvé, reste dangereux. ITIL vérifie que la décision a été prise, pas qu’elle était bonne. Qui décide, et au nom de quels objectifs, se règle un étage plus haut, dans la gouvernance que structure COBIT 2019.
- Pas de détection. La gestion des incidents traite ce qui est signalé ; la détection vient d’un SIEM (Security Information and Event Management), d’un EDR et d’une équipe qui les exploite.
- Pas d’investigation. ITIL ne décrit ni la préservation des preuves, ni l’analyse forensique, ni la coordination avec les autorités.
- Pas de conformité réglementaire. Un processus ITIL peut servir de preuve qu’un contrôle existe ; il ne démontre pas que le contrôle couvre l’exigence. La norme certifiable du domaine est l’ISO/IEC 20000-1, pas ITIL, qui certifie des personnes et non des organisations. Pour la sécurité, voir ce que garantit une certification ISO 27001 et ce qu’un auditeur vérifie réellement.
- Pas de couverture des tiers. Un prestataire d’infogérance « conforme ITIL » peut appliquer ses propres processus sans lien avec ceux du client ; l’alignement se négocie dans le contrat (voir la gestion des risques tiers).
Conditions d’exploitation de l’outillage et des processus
Section intitulée « Conditions d’exploitation de l’outillage et des processus »L’outil ITSM est un actif critique, et il faut l’exploiter comme tel.
- Secrets et clés. Les identifiants des connecteurs (découverte, orchestration, notification) se stockent dans un coffre de secrets, jamais dans la configuration de l’outil. Leur rotation suit le calendrier des comptes de service, et toute exposition dans un ticket déclenche une rotation immédiate.
- Identités. Authentification fédérée avec MFA, revue périodique des comptes, en particulier des comptes de prestataires et des rôles d’approbateur.
- Supervision. Les journaux d’audit de l’outil (connexions, approbations, modifications de flux, exports massifs) partent vers le SIEM. Un export complet de la CMDB par un compte de technicien n’est pas une opération ordinaire.
- Sauvegarde et reprise. L’outil ITSM doit être restaurable indépendamment du système d’information qu’il décrit. S’il est hébergé sur l’infrastructure attaquée, il tombe avec elle au moment précis où il devient indispensable : un mode dégradé (procédures imprimées ou export hors ligne des CI critiques, contacts d’astreinte, plan de reprise) doit exister et être testé. Le PRA (plan de reprise d’activité) qui vit uniquement dans l’outil de tickets chiffré par le rançongiciel a le mérite d’être très bien protégé.
- Revue des processus. Proportion de changements d’urgence, taux de changements en échec, incidents requalifiés en sécurité, écarts entre CMDB et découverte : ces quatre mesures disent si le cadre fonctionne mieux qu’une enquête de satisfaction.
Exemple : un incident de disponibilité requalifié en incident de sécurité
Section intitulée « Exemple : un incident de disponibilité requalifié en incident de sécurité »L’exemple montre la logique de requalification entre le circuit ITIL et le circuit de réponse à incident, sur un cas typique : une application métier devient lente, puis des fichiers deviennent illisibles sur un partage.
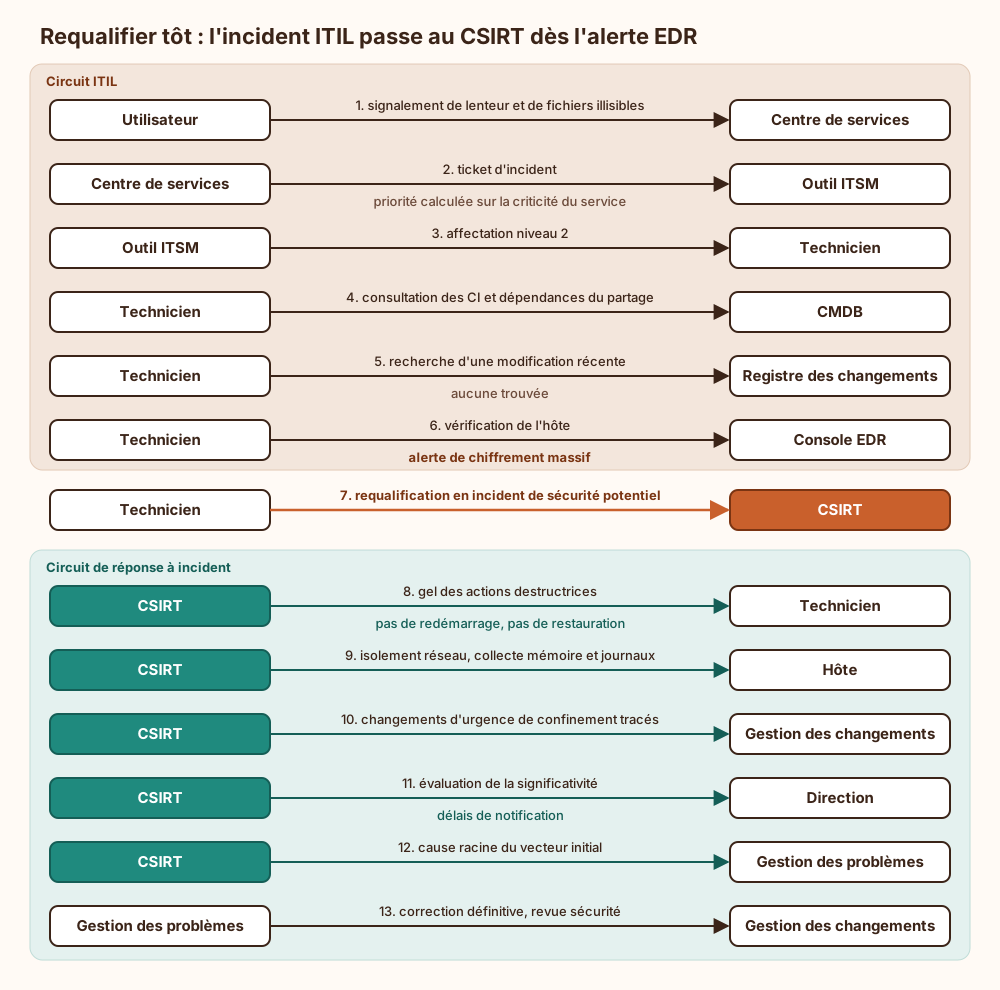
Le point de bascule se situe à deux endroits. D’abord le registre des changements : l’absence de modification déclarée sur un actif qui change de comportement est un signal à part entière, et il n’existe que si la gestion des changements est tenue. Ensuite la requalification : sans critère écrit, le technicien aurait restauré le partage depuis la sauvegarde, rétabli le service conformément à sa procédure, et effacé les traces du vecteur initial, qui serait resté ouvert.
Après requalification, ITIL ne disparaît pas : les actions de confinement passent en changements d’urgence tracés, la reprise du service se coordonne avec le CSIRT, et la gestion des problèmes reprend la main pour la cause racine. Les deux circuits coexistent, avec une règle de priorité explicite : l’investigation décide du moment où le rétablissement peut détruire des éléments.
🐝 Ce qui arrive si on s’en passe
Section intitulée « 🐝 Ce qui arrive si on s’en passe »Sans registre des changements, une modification malveillante de règle de pare-feu ou de stratégie d’annuaire ne se distingue plus d’une intervention d’exploitation : elle n’a rien à contredire. Sans critère de requalification, le centre de services restaure ou reconstruit les machines compromises au nom de la disponibilité, et la chronologie de l’intrusion disparaît avec elles, ce qui empêche de fermer le vecteur d’entrée. Sans gestion des problèmes, la même faiblesse produit des incidents en série, chacun refermé isolément. Sans inventaire de configuration fiable, la question « qu’est-ce qui dépend de cet actif compromis ? » reste sans réponse au moment de confiner, et les délais de notification courent pendant qu’on cherche.
- ITIL (Version 5) Explained, PeopleCert, 2026
- ITIL (Version 5): Built for the AI and Cloud Era, PeopleCert, 2026
- ITIL, PeopleCert.
- ITIL 4, PeopleCert.
- ISO/IEC 20000-1, ISO.
- Règlement (UE) 2022/2554 (DORA), Union européenne.
- Règlement délégué (UE) 2024/1774, Commission européenne.
- Directive (UE) 2022/2555 (NIS 2), Union européenne.
🦫 Explication de la marmotte 🍫
Section intitulée « 🦫 Explication de la marmotte 🍫 »ITIL est un ensemble de règles écrites qui organise le travail des équipes informatiques. Sa dernière version date de 2026, mais beaucoup d’entreprises utilisent encore celle de 2019. Tout repose sur une boucle. Quand un service tombe en panne, on ouvre un « incident » : le but est de le remettre en marche le plus vite possible. Si la même panne revient, on ouvre un « problème » : on cherche la vraie cause au lieu de réparer encore. Pour corriger cette cause, on fait un « changement » : une modification qu’une personne autorisée doit valider avant qu’elle soit appliquée. Chaque machine et chaque logiciel est noté dans une grande base, avec ce qui dépend de quoi. Pour la sécurité, ce registre des changements est précieux : si une machine est modifiée sans demande enregistrée, c’est peut-être un pirate. Mais attention, ITIL veut remettre le service en route, alors que l’équipe de sécurité veut d’abord comprendre l’attaque. Si un technicien redémarre une machine piratée, il efface les traces. Il faut donc des règles qui disent quand arrêter de réparer et appeler les spécialistes. Ça casse souvent à trois endroits : les modifications « urgentes » qui sautent la vérification, la base des machines que personne ne tient à jour, et l’outil de tickets lui-même, qui contient tellement d’informations qu’un attaquant a tout intérêt à le pirater.
À lire aussi
- TOGAF et méthode ADM : architecture d'entreprise en pratiqueTOGAF appliqué à l'architecture d'entreprise, avec la méthode ADM, les vues métier, données, applications et technologie, les feuilles de route de transition et la gouvernance d'architecture.
- AWS Well-Architected Framework : piliers, revue et limitesCe que l'AWS Well-Architected Framework exige vraiment, ses six piliers, la revue outillée, ses angles morts sécurité et ce qui se transpose hors AWS.
- FinOps Framework : responsabilité partagée des dépenses cloud et IACe que le FinOps Framework de la FinOps Foundation demande vraiment pour répartir la responsabilité des dépenses cloud, SaaS et IA entre métier, finance et ingénierie, ce qu'il coûte à tenir et ce qu'il change pour la sécurité et l'architecture.
- Microsoft Cloud Adoption Framework : phases, landing zones, limitesCe que demande chaque méthodologie du Microsoft Cloud Adoption Framework, ce que changent les zones d'atterrissage Azure pour la sécurité et l'architecture, et ce que le cadre ne garantit pas.
Pages voisines
La citent
- AWS Well-Architected Framework : piliers, revue et limites
- TOGAF et méthode ADM : architecture d'entreprise en pratique
ITIL : incidents, changements et problèmes vus de la sécurité
Elle cite
- Lien dans les deux sens :COBIT 2019 gouvernance informatique : objectifs et capacité
- Lien dans les deux sens :ISO/IEC 20000-1 : exigences et portée réelle de la certification
- Lien dans les deux sens :IT4IT 3.0 : flux de valeur et modèle de données de la DSI
- Ce qu’un auditeur vérifie dans les preuves de conformité
- Comment capitaliser et payer la dette de sécurité
- Gérer les risques tiers et la chaîne logicielle
- Quels indicateurs mesurer pour la sécurité
- Délais de notification d’incident NIS2 RGPD DORA
- DORA et résilience opérationnelle numérique financière
- EBIOS RM : analyse de risque et limites pratiques
: les deux pages se citent l’une l’autre.