
ALIGNEMENT : Alignement des modèles d'IA
IA
Ensemble des techniques qui orientent le comportement d'un modèle d'IA (grand modèle de langage, modèle d'IA à usage général) vers les intentions et les valeurs humaines visées, typiquement par affinage supervisé puis apprentissage par renforcement sur retour humain (RLHF, Reinforcement Learning from Human Feedback). C'est une couche de comportement apprise par-dessus les capacités du modèle : elle se contourne, et ne constitue pas une garantie de sécurité.
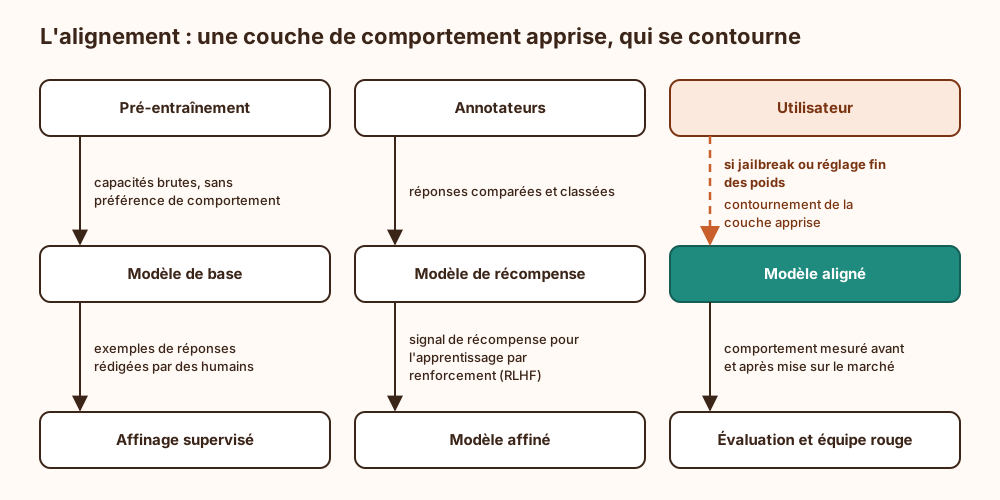
Techniques courantes : L'affinage supervisé montre au modèle des exemples de réponses attendues. Le RLHF entraîne ensuite un modèle de récompense sur des réponses classées par des annotateurs, puis optimise le modèle pour maximiser ce score ; des variantes comme DPO (Direct Preference Optimization) ou l'apprentissage sur une liste de principes écrits poursuivent le même but.
Une couche apprise, pas un verrou : Le pré-entraînement installe les capacités ; l'alignement ne les retire pas, il apprend au modèle à les mobiliser ou à les refuser selon le contexte. Un jailbreak, une injection de prompt ou quelques centaines d'exemples d'affinage sur des poids ouverts suffisent souvent à défaire ce comportement : présenter l'alignement comme un dispositif de sécurité, c'est confondre la politesse d'un portier avec la serrure de la porte.
Mesurer plutôt que déclarer : Un modèle « aligné » se juge sur des évaluations et des essais contradictoires documentés (équipe rouge), répétés après chaque mise à jour, pas sur la description de la méthode d'entraînement. Les garde-fous complémentaires (filtrage côté service, protection des poids, supervision des usages) restent nécessaires.
Place dans l'AI Act : Pour les modèles d'IA à usage général à risque systémique, l'annexe XI section 2 demande de documenter les adaptations du modèle, alignement et réglage fin compris. Ces phases s'ajoutent aussi au calcul cumulé d'entraînement comparé au seuil de 10²⁵ FLOP.
Ce qui arrive si on s'en passe
Sans alignement, le modèle met ses capacités à disposition sans orientation comportementale : il complète une demande nuisible aussi volontiers qu'une demande légitime, puisque rien ne lui a appris à refuser. Obtenir un contenu dangereux (instructions d'attaque, code malveillant, désinformation) ne demande alors aucun contournement : une simple requête suffit. Rien ne lui apprend non plus à faire passer les consignes de l'opérateur avant celles glissées dans les contenus qu'il traite. Ses sorties deviennent moins prévisibles (ton, format, respect des consignes). La détection des dérives s'en trouve compliquée, faute d'un comportement de référence à partir duquel mesurer un écart. À l'inverse, l'activer ne dispense d'aucun contrôle externe (filtrage, journalisation, limitation des droits) : l'alignement se contourne, et seule leur combinaison constitue une défense.
Explication de la marmotte
Un programme qui écrit des textes apprend d'abord en lisant une quantité énorme de pages : il sait alors tout faire, le meilleur comme le pire. Ensuite, on l'éduque. Des personnes lisent ses réponses, disent lesquelles sont bonnes, et il apprend à préférer les réponses honnêtes et à refuser les demandes dangereuses. C'est comme apprendre les bonnes manières à un chien très doué : la plupart du temps il obéit, mais il n'a pas oublié comment mordre. Avec une ruse bien trouvée, quelqu'un peut lui faire oublier ses bonnes manières. Ces bonnes manières ne suffisent donc pas, à elles seules, à rendre le programme sûr.