
IT4IT 3.0 : flux de valeur et modèle de données de la DSI
IT4IT 3.0 : flux de valeur et modèle de données de la DSI
Section intitulée « IT4IT 3.0 : flux de valeur et modèle de données de la DSI »IT4IT (IT for IT, l’informatique qui outille l’informatique) est le standard de The Open Group qui décrit comment une DSI (direction des systèmes d’information) devrait organiser et relier son propre outillage. Il est moins connu que TOGAF, mais il s’attaque à un problème plus prosaïque : le système d’information qui gère le système d’information, celui où chaque outil possède sa propre vérité. Sa version 3.0 change d’objet central : elle ne pilote plus des services, elle pilote des produits numériques.
→ Lire l’explication complète de la marmotte
Le problème qu’IT4IT résout : une DSI outillée en silos
Section intitulée « Le problème qu’IT4IT résout : une DSI outillée en silos »Une DSI moyenne exploite une dizaine d’outils pour se gérer elle-même : un outil de portefeuille de projets, un gestionnaire de backlog, une forge logicielle, une chaîne CI/CD (Continuous Integration / Continuous Delivery, intégration et livraison continues), un outil de déploiement, une CMDB (Configuration Management Database, base de données de configuration), un outil de ticketing, une supervision. Chacun a été choisi par une équipe différente, à une époque différente, pour un besoin différent. Chacun a son identifiant pour désigner « l’application X ». Aucun ne partage le même.
La conséquence se lit en une question qu’aucun de ces outils ne sait résoudre seul : « quelle version de quel produit tourne sur cette machine, qui l’a demandée, quelle exigence elle couvre, et combien d’incidents elle a produits depuis sa mise en service ? » La réponse existe, éparpillée en quatre morceaux, réconciliés à la main dans un tableur la veille d’un audit. Vingt ans de métier apprennent que ce tableur devient, par la force des choses, le référentiel officiel de la DSI, et qu’il n’a jamais de propriétaire.
IT4IT ne propose pas un outil de plus. Il propose une description de référence de ce que la fonction IT doit faire (les flux de valeur), des capacités qui le font (les composants fonctionnels) et surtout des données qui doivent circuler entre elles (le modèle de données). C’est ce troisième volet qui fait sa singularité.
IT4IT face à TOGAF, ITIL, COBIT et ISO/IEC 20000-1
Section intitulée « IT4IT face à TOGAF, ITIL, COBIT et ISO/IEC 20000-1 »Le même éditeur publie TOGAF (The Open Group Architecture Framework), ce qui entretient une confusion fréquente. Le partage est net : TOGAF décrit comment construire l’architecture d’une entreprise quelconque ; IT4IT décrit l’architecture d’une entreprise particulière, la fonction IT elle-même, vue comme une activité qui produit des produits numériques. On peut d’ailleurs appliquer la méthode de TOGAF pour concevoir l’outillage décrit par IT4IT : l’un est la méthode, l’autre est un modèle de référence prêt à l’emploi pour un domaine précis.
Face à ITIL (Information Technology Infrastructure Library), la différence tient en une phrase : ITIL décrit des pratiques de gestion de services, IT4IT prescrit les objets de données qui relient ces pratiques. ITIL dit qu’il faut gérer les changements et les incidents ; IT4IT dit qu’un incident doit pointer vers l’instance déployée concernée, qui pointe vers la version, qui pointe vers le produit. Les deux se combinent sans conflit, à condition de ne pas attendre d’ITIL qu’il fixe le modèle de données, ce qu’il ne fait pas.
COBIT 2019 (Control Objectives for Information and Related Technologies) se place au niveau de la gouvernance : objectifs, responsabilités, contrôles. ISO/IEC 20000-1 fixe les exigences d’un système de management des services, certifiable. IT4IT n’est ni l’un ni l’autre : il ne dit pas qui décide ni ce qu’un auditeur vérifie, il dit comment l’outillage doit être découpé et relié pour que les décisions et les audits disposent de données cohérentes.
Le positionnement à retenir :
| Cadre | Objet principal | Prescrit un modèle de données ? |
|---|---|---|
| TOGAF | Méthode d’architecture d’entreprise | Non, un métamodèle générique |
| COBIT 2019 | Gouvernance et objectifs de contrôle | Non |
| ITIL | Pratiques de gestion de services | Non |
| ISO/IEC 20000-1 | Exigences certifiables de management des services | Non |
| IT4IT 3.0 | Modèle opérationnel de la fonction IT | Oui, c’est son cœur |
De la gestion de services au produit numérique : la bascule de la version 3.0
Section intitulée « De la gestion de services au produit numérique : la bascule de la version 3.0 »La version 2.1 s’organisait autour de quatre flux de valeur orientés service : Strategy to Portfolio, Requirement to Deploy, Request to Fulfill, Detect to Correct. Le découpage collait à une DSI qui livre des services à des métiers clients, avec un catalogue et des tickets.
L’IT4IT Standard, Version 3.0, publié par The Open Group en décembre 2022, change d’objet central : le produit numérique (« digital product »). L’IT n’y est plus un service support qui répond à des demandes, mais un ensemble de produits avec un cycle de vie, des versions, des consommateurs et un portefeuille à arbitrer. La version courante est la 3.0.1, correctif de maintenance qui intègre le Technical Corrigendum 1 de la 3.0 ; elle ne change pas la structure.
La bascule n’est pas cosmétique. Un service se gère en continu et se mesure en disponibilité ; un produit se gère par versions et se mesure en valeur livrée. Le modèle de données suit : l’unité de traçabilité devient la version d’un produit, de sa conception à son exploitation. Les organisations qui ont déjà adopté une organisation par produits (équipes stables, backlog par produit) y retrouvent leur fonctionnement ; celles qui raisonnent encore en projets à durée limitée y trouvent un modèle qui ne correspond pas à leur réalité, et qu’il faudra plier.
Les sept flux de valeur d’IT4IT 3.0 autour du produit numérique
Section intitulée « Les sept flux de valeur d’IT4IT 3.0 autour du produit numérique »Un flux de valeur (value stream) est une suite d’activités qui produit un résultat identifiable pour quelqu’un. IT4IT 3.0 en définit sept :
- Evaluate : évaluation continue du portefeuille de produits numériques ;
- Explore : exploration des nouvelles fonctionnalités et des directions d’un produit au regard des besoins métier ;
- Integrate : conception et construction d’une nouvelle version (release) du produit ;
- Deploy : instanciation d’une version dans les environnements d’exploitation ;
- Release : publication aux consommateurs des offres de service nouvelles ou modifiées ;
- Consume : livraison au consommateur de l’instance de produit commandée, conforme à l’offre et aux conditions convenues ;
- Operate : fonctionnement continu d’un produit déployé.
Le schéma suivant montre l’enchaînement de ces flux autour d’un produit ; la dernière ligne (le retour de l’exploitation vers l’évaluation) traduit le caractère continu de l’évaluation du portefeuille, c’est une lecture du modèle et non une flèche normative du standard.
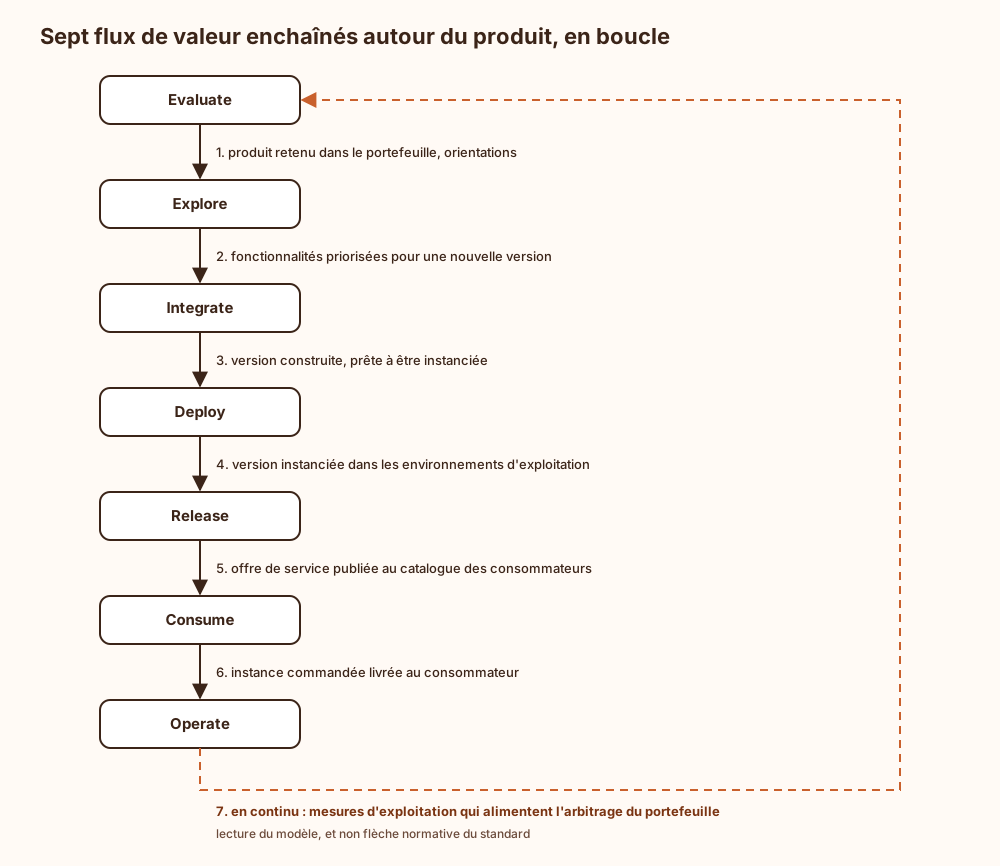
Deux distinctions méritent l’attention, parce qu’elles sont celles que les organisations écrasent en premier. Deploy et Release sont séparés : mettre une version en production n’est pas la rendre disponible aux consommateurs. Cette séparation correspond exactement à ce que font les déploiements progressifs et les bascules de fonctionnalités ; un modèle qui les confond ne sait pas dire si une faille présente dans le code déployé est exposée ou non. Release et Consume sont séparés aussi : publier une offre au catalogue n’est pas la commander et la livrer à un consommateur précis. La sécurité vit dans cet interstice, puisque c’est au moment du Consume qu’une instance est attribuée et que des droits sont accordés à quelqu’un.
Modèle de référence fonctionnel et modèle de données : le fil qui relie les flux
Section intitulée « Modèle de référence fonctionnel et modèle de données : le fil qui relie les flux »Le modèle de référence fonctionnel découpe l’outillage de la DSI en composants fonctionnels : des capacités logiques, indépendantes de tout éditeur, qui portent chacune une responsabilité et manipulent certaines données. Un composant fonctionnel n’est pas un produit du marché ; un même outil en couvre souvent plusieurs, et un composant peut être réparti sur plusieurs outils. L’intérêt est de pouvoir cartographier l’existant sans débat de marque : on projette chaque outil sur les composants qu’il couvre, et les trous comme les doublons apparaissent.
Le modèle de données est le véritable apport. Il définit les objets de données clés et leurs relations, de sorte qu’un objet créé dans un flux soit référencé, et non recopié, dans le suivant. C’est ce chaînage qui permet de remonter d’un incident à l’exigence qui a motivé le code fautif. Les noms exacts des objets figurent dans le standard ; le schéma ci-dessous en donne une forme générique, pour montrer le principe du fil plutôt que la nomenclature.
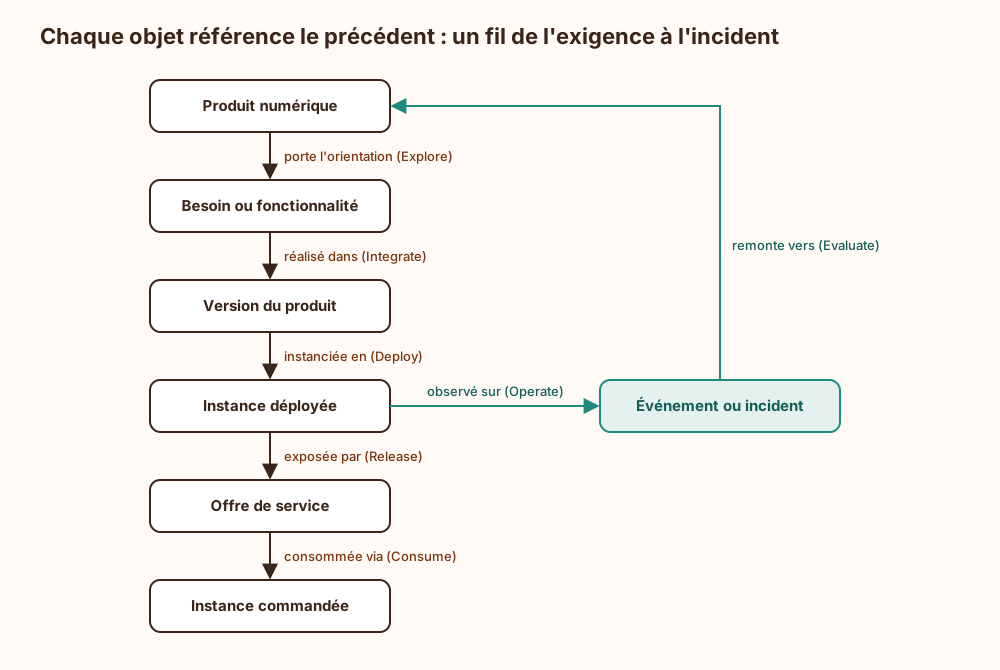
À lire dans ce schéma : chaque flèche est une référence entre deux objets, pas un transfert de copie. Si un outil recopie la version au lieu de la référencer, le fil est rompu dès la première correction manuelle, et deux vérités recommencent à coexister.
La règle qui en découle est tranchée : chaque objet de données a un seul système d’enregistrement (le système qui fait foi), et tous les autres le référencent par un identifiant stable. Un objet qui fait foi dans deux outils n’a pas de source de vérité ; il a deux sources de désaccord.
Ce qu’IT4IT change pour la sécurité et l’architecture
Section intitulée « Ce qu’IT4IT change pour la sécurité et l’architecture »Le gain le plus concret pour un architecte sécurité est l’inventaire. Un inventaire d’actifs construit à la main est faux le jour de sa livraison ; un inventaire dérivé du chaînage version vers instance déployée est à jour par construction, puisqu’il est un effet de bord du déploiement. La question « où tourne la bibliothèque vulnérable ? » devient une requête au lieu d’une campagne de courriels.
Le chaînage version vers composants est précisément ce qu’exige une nomenclature logicielle exploitable. Une SBOM (Software Bill of Materials, nomenclature des composants d’un logiciel) attachée à une version, elle-même reliée à ses instances déployées et à ses offres publiées, permet de répondre en une passe à trois questions distinctes : quels produits embarquent le composant, où ils tournent, et si la fonctionnalité concernée est réellement exposée aux consommateurs (la séparation Deploy et Release prend ici tout son sens). Pour un éditeur concerné par le Cyber Resilience Act, ce fil est l’ossature de la gestion des vulnérabilités sur la durée de support.
Le troisième gain est la preuve. Un auditeur ne se contente pas d’une procédure de gestion des changements ; il tire un changement au hasard et demande l’exigence, la revue, le déploiement et le résultat. Avec un modèle de données chaîné, cette preuve est une extraction ; sans lui, c’est une reconstitution, et une reconstitution se défend mal (voir ce qu’un auditeur vérifie réellement).
Enfin, le flux Consume est l’endroit où l’IAM (Identity and Access Management, gestion des identités et des accès) rejoint le modèle opérationnel : une commande honorée qui accorde un droit doit pointer vers l’offre et l’instance concernées, sans quoi la revue des habilitations ne sait pas à quoi correspond un droit orphelin.
Prérequis de mise en œuvre et coût réel du modèle
Section intitulée « Prérequis de mise en œuvre et coût réel du modèle »Le standard ne s’installe pas. Avant d’en tirer quoi que ce soit, il faut :
- une définition opérationnelle du produit numérique partagée par les équipes : sans elle, le premier objet du modèle n’a pas d’identité stable et tout le reste dérive ;
- un référentiel d’identifiants pour les produits et les versions, émis par un seul système, consommé par tous les autres ;
- des outils exposant une API (Application Programming Interface, interface de programmation) en lecture et en écriture, avec des identifiants externes stockables : un outil qui ne sait pas mémoriser l’identifiant d’un objet tiers ne peut pas participer au fil ;
- un propriétaire désigné pour chaque objet de données, responsable de sa qualité et de son cycle de vie.
Le compromis central se formule sans détour : IT4IT fait gagner une traçabilité de bout en bout, et le prix est que chaque outil renonce à être sa propre vérité. Ce renoncement coûte des intégrations à maintenir (chaque remplacement d’outil impose de reprendre ses connecteurs et ses correspondances d’identifiants), une gouvernance de la donnée qui dure (réconciliation, purge des objets orphelins, contrôle des doublons) et une discipline d’équipe : une correction faite directement en production sans passer par le flux Deploy crée une instance qui n’existe dans aucune version.
La recommandation est donc la suivante : adopter le modèle de données d’abord, sur un fil réduit (produit, version, instance déployée, incident), et laisser le modèle fonctionnel servir de grille de cartographie plutôt que de plan de transformation. Une transformation lancée par le découpage fonctionnel exhaustif produit des diagrammes ; une transformation lancée par quatre objets correctement chaînés produit des réponses. Cette recommandation vaut tant que l’organisation fonctionne déjà, au moins partiellement, par produits ; dans une DSI purement organisée en projets, le préalable est organisationnel, et aucun modèle de données ne le contournera.
Les éditeurs d’outillage ont évidemment découvert IT4IT avant les DSI : une plateforme « alignée IT4IT » couvre en général plusieurs composants fonctionnels, ce qui est commode, et en devient le système d’enregistrement universel, ce qui l’est nettement moins le jour où on veut en changer.
Surface d’attaque d’un outillage IT4IT intégré
Section intitulée « Surface d’attaque d’un outillage IT4IT intégré »Relier tous les outils de la DSI crée par définition l’endroit le plus intéressant du système d’information pour un attaquant. Les attaques connues sur cette architecture ne sont pas propres à IT4IT, mais le modèle les concentre.
Les comptes d’intégration. Chaque connecteur entre deux outils utilise un compte technique, souvent doté de droits en écriture larges « pour que la synchronisation marche ». Un jeton d’intégration volé entre la forge et l’outil de déploiement permet de déclencher un déploiement légitime en apparence. Contre-mesures : un compte par connecteur et par sens, droits limités aux objets et aux opérations nécessaires, jetons à durée de vie courte émis par un gestionnaire de secrets, et interdiction des jetons personnels dans les intégrations.
La cartographie comme cible. Le référentiel chaîné contient la liste exacte des produits, de leurs versions, de leurs instances et de leurs composants vulnérables. C’est une reconnaissance livrée clés en main. Il relève donc de la même classification que les données de sécurité : accès en lecture restreint, journalisation des requêtes massives, détection des extractions inhabituelles.
L’empoisonnement des données. Un attaquant qui peut modifier une relation (rattacher une instance compromise à une version saine, ou détacher un composant vulnérable de la nomenclature) falsifie la traçabilité sans toucher à la production. Contre-mesures : écriture d’une relation réservée au système d’enregistrement de l’objet source, historisation immuable des modifications, et réconciliation périodique avec l’état réellement observé (ce qui tourne effectivement, comparé à ce que le modèle déclare).
La chaîne de déploiement. Le flux Deploy est celui qui écrit en production. Signature des artefacts au flux Integrate, vérification de la signature au flux Deploy, et refus de toute instance dont la version n’existe pas dans le référentiel : le modèle de données devient alors un contrôle, et non plus seulement une documentation.
Ce qu’IT4IT ne garantit pas
Section intitulée « Ce qu’IT4IT ne garantit pas »IT4IT ne garantit pas la sécurité de quoi que ce soit. Il ne définit aucune mesure de sécurité, aucun niveau de protection, aucun contrôle d’accès ; ces exigences viennent d’un référentiel de sécurité (une norme de management de la sécurité, une analyse de risque) et se branchent sur les flux qu’IT4IT décrit.
Il ne garantit pas non plus la qualité des données qu’il prescrit. Un modèle de données parfaitement conforme au standard, alimenté par des saisies manuelles approximatives, produit une traçabilité parfaitement fausse, avec l’aplomb d’un rapport généré automatiquement.
Il n’est pas un cadre de conformité réglementaire : aucune obligation légale ne renvoie à IT4IT, et l’alignement sur le standard ne vaut preuve de rien devant une autorité. Il facilite la production des preuves ; il ne les remplace pas. Il ne dit pas non plus comment mesurer la valeur d’un produit : les indicateurs d’Evaluate restent à concevoir, avec les pièges habituels des indicateurs qui font façade.
Conditions d’exploitation du référentiel chaîné
Section intitulée « Conditions d’exploitation du référentiel chaîné »Une fois le fil en place, il faut le tenir.
- Secrets d’intégration : stockés dans un gestionnaire de secrets, jamais dans la configuration des connecteurs ; rotation automatisée, et révocation immédiate au départ d’un outil ou d’un prestataire d’intégration.
- Supervision des connecteurs : un connecteur en panne ne produit aucune erreur visible pour les utilisateurs ; il produit un fil qui s’arrête. Il faut superviser le dernier objet synchronisé par connecteur, et alerter sur un retard, pas seulement sur une erreur.
- Réconciliation : comparer régulièrement les instances déclarées dans le modèle et les instances observées par la supervision ou la découverte réseau. L’écart est la mesure la plus honnête de la santé du modèle.
- Sauvegarde et reprise : le référentiel des identifiants est le point unique dont dépend tout le reste. Sa perte ne casse pas la production, elle casse la capacité à comprendre la production. Il se sauvegarde avec l’historique des relations, et sa restauration se teste, y compris la ré-association des identifiants externes stockés dans les autres outils.
Exemple : remonter une vulnérabilité le long du fil de données
Section intitulée « Exemple : remonter une vulnérabilité le long du fil de données »Un avis de sécurité annonce une vulnérabilité dans une bibliothèque. Le schéma suivant montre comment un outillage chaîné selon IT4IT transforme l’alerte en décision, flux par flux.
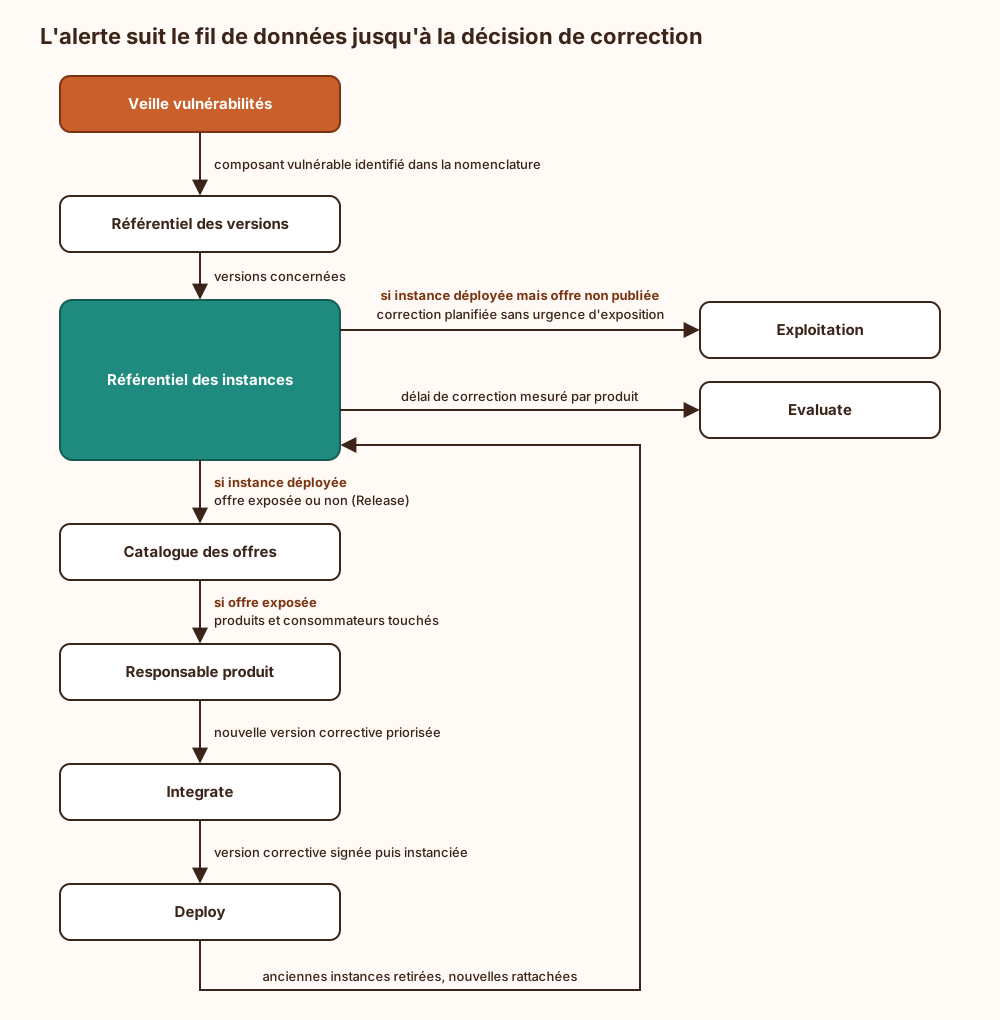
Le chemin se lit de haut en bas. La nomenclature attachée à chaque version désigne les versions touchées ; le lien vers les instances dit où elles tournent ; le lien vers les offres publiées dit si la fonctionnalité est réellement exposée, ce qui sépare l’urgence de la simple planification. La correction repasse par Integrate puis Deploy, et la mise à jour du référentiel des instances clôt la boucle : le délai de correction devient une donnée du portefeuille, disponible pour l’arbitrage d’Evaluate. Sans le chaînage, chaque flèche de ce schéma est une réunion.
- IT4IT Standard, Version 3.0, The Open Group.
🐝 Ce qui arrive si on s’en passe
Section intitulée « 🐝 Ce qui arrive si on s’en passe »Sans fil de données entre les outils de la DSI, chaque outil reste le témoin isolé d’une étape. Une instance installée hors du flux de déploiement n’apparaît dans aucun inventaire et reste invisible aux campagnes de correction. Un jeton d’intégration abusé laisse des modifications que rien ne permet de rattacher à une version ou à une demande, ce qui ruine l’enquête après coup. La présence d’un composant vulnérable se constate, mais son exposition réelle aux consommateurs reste inconnue, si bien que l’urgence se décide à l’aveugle. Un droit accordé lors d’une demande ne se relie à aucune offre, et la revue des habilitations hérite de comptes que personne ne sait justifier. Enfin, le portefeuille s’arbitre sans données d’exploitation, sur des impressions.
🦫 Explication de la marmotte 🍫
Section intitulée « 🦫 Explication de la marmotte 🍫 »Le service informatique d’une entreprise fabrique des logiciels et les fait fonctionner. Pour ça, il utilise plein d’outils : un pour choisir quoi construire, un pour écrire le code, un pour l’installer sur les serveurs, un pour noter les pannes. Le problème, c’est que ces outils ne se parlent pas : chacun donne un nom différent au même logiciel.
IT4IT est un document publié par un organisme appelé The Open Group. Il découpe la vie d’un logiciel en sept étapes dans l’ordre : décider quels logiciels garder, explorer les nouvelles idées, construire une nouvelle version, l’installer sur les serveurs, l’ouvrir aux utilisateurs, leur livrer ce qu’ils ont commandé, puis le faire tourner tous les jours. Ce qu’on observe pendant le fonctionnement sert ensuite à redécider quels logiciels garder.
Surtout, il dit quelles informations doivent passer d’une étape à l’autre : une panne doit pointer vers l’installation concernée, qui pointe vers la version, qui pointe vers le logiciel. Chaque information n’est écrite qu’à un seul endroit, les autres outils y renvoient.
Grâce à ce fil, quand une faille est découverte dans un morceau de code, on retrouve tout de suite quelles versions le contiennent, où elles sont installées et si les utilisateurs y ont accès. Quand le fil casse, par exemple si quelqu’un modifie un serveur à la main, l’information devient fausse sans prévenir. Et comme ce fil relie tout, il faut bien protéger les comptes qui le font fonctionner.
À lire aussi
- AWS Well-Architected Framework : piliers, revue et limitesCe que l'AWS Well-Architected Framework exige vraiment, ses six piliers, la revue outillée, ses angles morts sécurité et ce qui se transpose hors AWS.
- FinOps Framework : responsabilité partagée des dépenses cloud et IACe que le FinOps Framework de la FinOps Foundation demande vraiment pour répartir la responsabilité des dépenses cloud, SaaS et IA entre métier, finance et ingénierie, ce qu'il coûte à tenir et ce qu'il change pour la sécurité et l'architecture.
- Microsoft Cloud Adoption Framework : phases, landing zones, limitesCe que demande chaque méthodologie du Microsoft Cloud Adoption Framework, ce que changent les zones d'atterrissage Azure pour la sécurité et l'architecture, et ce que le cadre ne garantit pas.
- ISORéférence normative internationale pour les systèmes de management, les contrôles et la gestion des risques.
Pages voisines
IT4IT 3.0 : flux de valeur et modèle de données de la DSI
Elle cite
- Lien dans les deux sens :ISO/IEC 20000-1 : exigences et portée réelle de la certification
- Lien dans les deux sens :ITIL : incidents, changements et problèmes vus de la sécurité
- Lien dans les deux sens :TOGAF et méthode ADM : architecture d'entreprise en pratique
- COBIT 2019 gouvernance informatique : objectifs et capacité
- Ce qu’un auditeur vérifie dans les preuves de conformité
- Quels indicateurs mesurer pour la sécurité
- Exigences CRA pour produits connectés sécurisés
: les deux pages se citent l’une l’autre.