
Cloud IaaS, PaaS, SaaS et modèles de déploiement, qui sécurise quoi
Cloud IaaS, PaaS, SaaS et modèles de déploiement, qui sécurise quoi
Section intitulée « Cloud IaaS, PaaS, SaaS et modèles de déploiement, qui sécurise quoi »Le cloud computing se définit par cinq propriétés techniques, trois modèles de service et quatre modèles de déploiement, et chacun de ces termes déplace une part précise du travail de sécurité. Passer d’un modèle à l’autre revient à céder des couches d’exploitation au fournisseur, jamais la responsabilité des données, des identités ni de la configuration. Cette page pose la grille de lecture, couche par couche, et dit quel modèle retenir.
→ Lire l’explication complète de la marmotte
Définition NIST du cloud computing : cinq caractéristiques et leurs conséquences en sécurité
Section intitulée « Définition NIST du cloud computing : cinq caractéristiques et leurs conséquences en sécurité »La définition de référence est celle du NIST (National Institute of Standards and Technology), publiée dans la SP (Special Publication) 800-145 en septembre 2011 : sept pages, ce qui en fait probablement le texte le plus court et le plus cité du secteur. Les normes ISO/IEC (International Organization for Standardization, International Electrotechnical Commission) reprennent la même ossature : la 22123, qui a remplacé la 17788, pour le vocabulaire, et la 27017 pour les mesures de sécurité. Un service qui ne présente pas les cinq caractéristiques ci-dessous relève de l’hébergement ou de l’infogérance, quel que soit le mot imprimé sur la plaquette.
Libre-service à la demande. Le client provisionne seul, sans intervention humaine du fournisseur. En pratique, tout se crée par une API (Application Programming Interface), donc par une identité qui en a le droit. Conséquence : le périmètre de sécurité n’est plus le réseau, c’est le jeu de droits attaché aux identités. Une clé d’accès dotée de droits d’administration équivaut à un badge ouvrant toutes les salles du centre de données, sauf qu’elle se copie dans un dépôt de code en une seconde.
Accès réseau étendu. Le service est joignable par des mécanismes standards depuis n’importe quel terminal. L’interface de gestion est donc exposée sur Internet par construction : aucun pare-feu du client ne protège la console du fournisseur. La force de l’authentification et les conditions d’accès (origine, appareil, second facteur) constituent la seule barrière.
Mutualisation des ressources. Les mêmes machines servent plusieurs clients, appelés locataires. L’isolation entre locataires est entièrement déléguée au fournisseur et le client ne peut pas l’inspecter : il s’appuie sur des rapports d’audit tiers, pas sur ses propres tests. La définition précise aussi que le client ignore l’emplacement exact des ressources mais peut le fixer à un niveau plus large (pays, région, centre de données) : le choix de région est un paramètre client, pas une garantie par défaut (ce qu’il vaut juridiquement est traité dans la page Résidence des données et souveraineté cloud). Le cloisonnement que le client construit lui-même au-dessus est traité dans la page sur l’isolation réseau multi-tenant.
Élasticité rapide. Les ressources apparaissent et disparaissent selon la charge. L’inventaire devient mouvant : une machine peut naître, traiter des données et mourir entre deux passages d’un scanner hebdomadaire. Un inventaire tenu dans un tableur est faux avant d’être enregistré ; il doit être reconstruit depuis les API du fournisseur, comme détaillé dans la page sur la dérive de configuration et l’inventaire réel.
Service mesuré. Chaque consommation est comptée et facturée. La facture devient une surface d’attaque (une identité volée peut lancer du calcul aux frais du titulaire, un trafic hostile peut gonfler la note) et, plus rarement exploité, un capteur : une anomalie de coût est souvent le premier signal d’une compromission. Les garde-fous sont décrits dans la page sur les quotas et la limitation des ressources.
Le schéma suivant montre le chemin que suit toute action dans un cloud. À lire en priorité : rien n’atteint une ressource sans passer par une identité et par l’API de gestion, et le journal n’arrive chez le client que si celui-ci le demande.
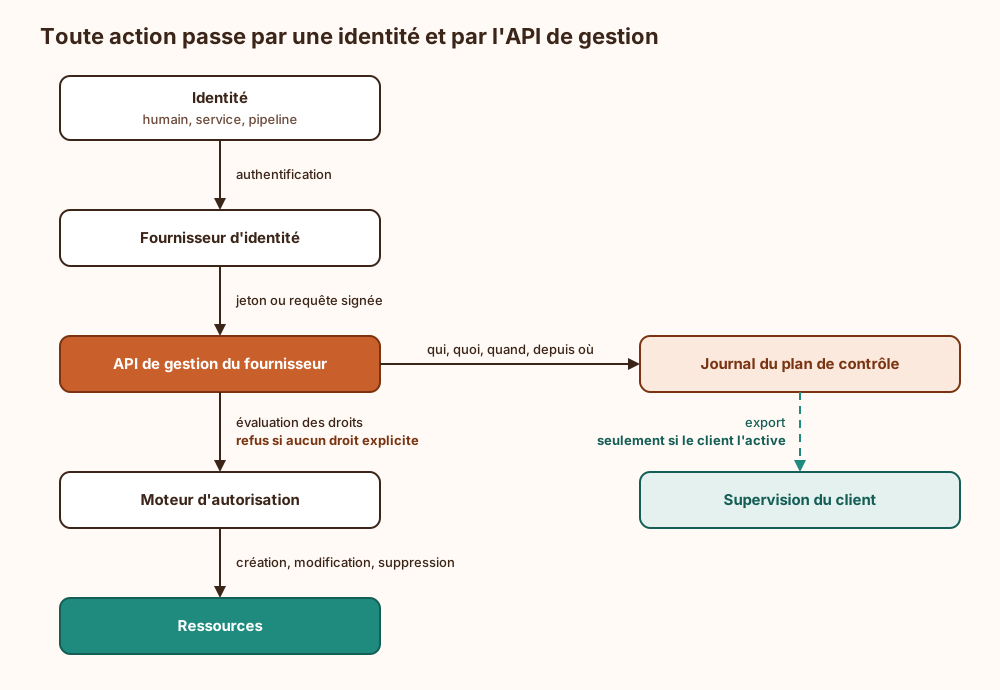
Cet ensemble (API de gestion, autorisation, journal) s’appelle le plan de contrôle. Sa maîtrise passe par l’IAM (Identity and Access Management) ; la page Détecter la persistance IAM dans AWS montre ce qu’un attaquant en fait une fois entré.
IaaS, PaaS, SaaS : ce que chaque modèle de service délègue couche par couche
Section intitulée « IaaS, PaaS, SaaS : ce que chaque modèle de service délègue couche par couche »Les trois modèles du NIST se lisent comme une pile de neuf couches dont la frontière d’exploitation monte d’un cran à chaque modèle. IaaS (Infrastructure as a Service) : le fournisseur livre calcul, stockage et réseau virtualisés. PaaS (Platform as a Service) : il livre en plus le système et le moteur d’exécution, le client dépose son code. SaaS (Software as a Service) : il livre l’application terminée.
| Couche | Sur site | IaaS | PaaS | SaaS |
|---|---|---|---|---|
| Locaux, énergie, accès physique | Client | Fournisseur | Fournisseur | Fournisseur |
| Matériel et réseau physique | Client | Fournisseur | Fournisseur | Fournisseur |
| Virtualisation | Client | Fournisseur | Fournisseur | Fournisseur |
| Système d’exploitation | Client | Client | Fournisseur | Fournisseur |
| Moteur d’exécution, intergiciels | Client | Client | Fournisseur (version choisie par le client) | Fournisseur |
| Application | Client | Client | Client | Fournisseur |
| Données | Client | Client | Client | Client |
| Identités et droits | Client | Client | Client | Client |
| Configuration du service | Client | Client | Client | Client |
Le schéma ci-dessous résume le tableau : chaque flèche indique les couches qui changent de main, et la dernière ligne celles qui ne bougent jamais.
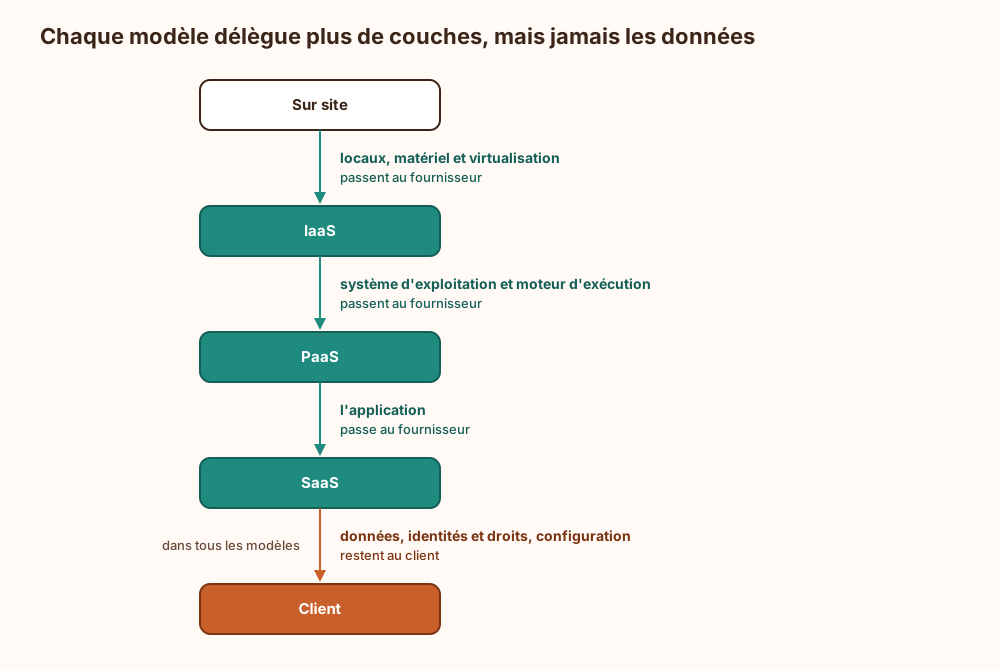
En IaaS, le gain réel est physique : plus de salle, plus de matériel à remplacer, plus d’hyperviseur à corriger. Tout le reste demeure : correctifs du système invité, durcissement, pare-feu virtuels, chiffrement des volumes, sauvegardes, supervision. Une machine virtuelle abandonnée dans un cloud vieillit exactement comme un serveur oublié dans une baie, avec en prime une adresse publique si personne n’a regardé la case cochée par défaut.
En PaaS, le fournisseur corrige le système et le moteur d’exécution, mais dans les limites fixées par le client : la version du moteur est un choix client, et une version en fin de support reste en service tant que personne ne la migre. Restent aussi les dépendances embarquées dans le code, l’exposition réseau du service, les comptes applicatifs et la rétention des sauvegardes. Le cas le plus courant, la base de données, est détaillé dans la page sur la sécurité des bases de données managées.
En SaaS, le client n’exploite plus rien de technique et perd presque toute visibilité : pas d’accès au système, pas de capture réseau, des journaux limités à ce que l’éditeur veut bien exposer (et parfois réservés à l’offre tarifaire supérieure, détail qui se découvre rarement avant l’incident). Ce qui reste est de la configuration pure : qui se connecte, avec quel second facteur, quels partages externes sont permis, quelles applications tierces reçoivent un accès délégué aux données.
La méthode pour vérifier ces frontières chez un fournisseur donné, et lire sa matrice de responsabilité sans y projeter ses espoirs, fait l’objet de la page Comment auditer la responsabilité partagée cloud.
Ce qui ne se délègue dans aucun modèle de service
Section intitulée « Ce qui ne se délègue dans aucun modèle de service »Cinq choses restent chez le client, du serveur sous le bureau jusqu’au SaaS le plus intégré.
- Les données. Leur classification, leur licéité, leur durée de conservation et la liste de ceux qui y accèdent. Le fournisseur stocke ce qu’on lui confie et le rend à qui présente les bons droits.
- Les identités et les droits. Création, revue, retrait des comptes, MFA (Multi-Factor Authentication), comptes de service et leurs secrets. Le fournisseur fournit le moteur d’autorisation ; il n’a aucun avis sur le fait qu’un stagiaire soit administrateur global.
- La configuration. Un service est livré avec des options, et une option mal réglée est appliquée avec la même fiabilité qu’une bonne. Un espace de stockage rendu public par son propriétaire n’est pas une faille du fournisseur : c’est le service qui fonctionne.
- Les obligations légales. Le RGPD (Règlement général sur la protection des données) encadre la relation avec le sous-traitant dans son article 28 sans transférer à ce dernier le rôle de responsable de traitement. Les textes sectoriels comme NIS 2 (directive (UE) 2022/2555) ou DORA (Digital Operational Resilience Act, règlement (UE) 2022/2554) visent l’entité régulée, y compris pour ses prestataires.
- La responsabilité devant le régulateur et les personnes concernées. Un contrat répartit des tâches et des pénalités entre deux sociétés ; il ne change pas le nom inscrit sur la notification d’incident.
Deux angles morts s’y ajoutent. La disponibilité garantie par le fournisseur n’est pas une sauvegarde : une suppression faite par un compte légitime est répliquée partout, fidèlement. Et la réversibilité (récupérer ses données dans un format réutilisable) n’existe que si elle a été testée.
Conteneurs managés et fonctions à la demande : les modèles que la grille IaaS, PaaS, SaaS range mal
Section intitulée « Conteneurs managés et fonctions à la demande : les modèles que la grille IaaS, PaaS, SaaS range mal »La grille à trois cases date de 2011. Les services apparus depuis coupent certaines couches en deux, et c’est dans la découpe que les correctifs se perdent.
Conteneurs managés. Dans un service Kubernetes managé, le fournisseur exploite le plan de contrôle de l’orchestrateur. Les nœuds qui exécutent les conteneurs relèvent du client ou du fournisseur selon l’option retenue, et même quand le fournisseur publie les images de nœuds, c’est souvent le client qui déclenche la montée de version. La couche système se scinde : le noyau appartient au nœud, mais les bibliothèques système vivent dans l’image du conteneur, construite par le client. Une image jamais reconstruite conserve ses vulnérabilités quel que soit le zèle du fournisseur. Les droits internes à l’orchestrateur forment en outre un second plan de contrôle, traité dans la page RBAC Kubernetes et admission control.
Fonctions à la demande, ou FaaS (Function as a Service). Le fournisseur gère tout jusqu’au moteur d’exécution ; le client livre quelques dizaines de lignes de code. Restent chez lui les dépendances empaquetées avec la fonction, l’identité attribuée à chaque fonction (souvent trop généreuse, parce que c’était plus rapide le jour de la démonstration), les déclencheurs qui l’exposent et les secrets qu’elle lit. L’absence de serveur visible n’enlève aucune de ces lignes : voir la page sur la sécurité serverless et FaaS.
La règle qui remplace la grille : pour chaque service, reprendre les neuf couches une par une et écrire un nom en face. Une couche sans nom est une couche que personne ne corrige.
Modèles de déploiement : public, privé, communautaire, hybride
Section intitulée « Modèles de déploiement : public, privé, communautaire, hybride »Le modèle de déploiement dit qui partage l’infrastructure, pas qui l’exploite ni où elle se trouve.
Cloud public. Infrastructure ouverte à tout client. C’est le modèle où la mutualisation est maximale et où la confiance dans l’isolation du fournisseur pèse le plus lourd.
Cloud privé. Infrastructure réservée à une seule organisation. Le NIST précise qu’elle peut être détenue et exploitée par l’organisation, par un tiers, ou les deux, sur site ou non. Exploité en interne, un cloud privé ne délègue rien de plus qu’un centre de données classique et garde toute l’exploitation : l’organisation est à la fois le fournisseur et le client, donc elle hérite aussi de la sécurité du plan de contrôle, cible de choix puisqu’il commande tout. Le mot « privé » décrit l’exclusivité d’usage ; il ne dit rien du niveau de sécurité. Et sans libre-service ni élasticité, il s’agit d’une ferme de virtualisation dotée d’un formulaire de demande, ce qui est honorable mais porte un autre nom.
Cloud communautaire. Infrastructure partagée par des organisations ayant des exigences communes (mission, sécurité, conformité). Rare en pratique. Sa question décisive est de gouvernance : qui opère, qui audite, qui répond en cas d’incident touchant plusieurs membres.
Cloud hybride. Composition d’au moins deux infrastructures cloud distinctes (privée, communautaire ou publique) reliées pour permettre la portabilité des données et des applications. L’usage courant étend le mot au couple formé par un centre de données classique et un cloud public, et c’est ce cas qui domine sur le terrain. L’hybride ne retire aucune responsabilité et en ajoute deux. D’abord les interconnexions : un lien dédié est privé, pas chiffré, et un routage à plat entre les deux mondes offre le mouvement latéral dans les deux sens. Ensuite la fédération d’identités : l’annuaire interne devient la racine de confiance du cloud, donc sa compromission vaut compromission du cloud. Le multi-cloud, absent de la définition du NIST, multiplie ces coûts par le nombre de fournisseurs ; voir la page sur la complexité de la sécurité multi-cloud.
Surface d’attaque du plan de contrôle cloud et conditions d’exploitation
Section intitulée « Surface d’attaque du plan de contrôle cloud et conditions d’exploitation »Les attaques propres au cloud visent ce que le client garde, rarement ce que le fournisseur exploite.
- Vol d’identifiants du plan de contrôle : clés d’accès à longue durée de vie publiées dans du code, sessions d’administration hameçonnées. Contre-mesures : MFA résistant à l’hameçonnage pour les humains, identifiants courts et renouvelés automatiquement pour les machines, aucun compte racine en usage courant.
- Vol d’identifiants depuis une charge de travail : une application vulnérable à une SSRF (Server-Side Request Forgery, requête forgée côté serveur) peut interroger le service de métadonnées de sa machine et obtenir les droits de celle-ci. Contre-mesures : version durcie du service de métadonnées, droits minimaux par charge.
- Exposition par configuration : stockage public, port d’administration ouvert, base joignable d’Internet. Contre-mesures : politiques d’organisation qui interdisent ces réglages en amont plutôt que de les détecter après.
- Abus de fédération : prise de contrôle de l’annuaire source ou d’une application tierce à qui un accès délégué a été consenti. Contre-mesures : comptes d’administration cloud non synchronisés depuis l’annuaire interne, revue des consentements.
- Abus de facturation : traité par quotas, budgets et alertes.
Prérequis avant la première charge de travail : une structure de comptes ou d’abonnements séparant production et le reste, une source d’identité unique, l’export des journaux du plan de contrôle vers un espace que les administrateurs courants ne peuvent pas effacer, un inventaire automatisé. En exploitation : rotation des secrets des comptes de service, revue périodique des droits, sauvegardes placées hors de portée des identités de production, restauration testée, et un compte de secours hors fédération, scellé et surveillé, pour le jour où le fournisseur d’identité tombe.
Ce que le modèle ne garantit pas : aucun ne chiffre les données contre le fournisseur lui-même par défaut, aucun n’empêche une action destructrice faite avec des droits valides, aucun ne fournit la détection. Le reste vient de la gestion des clés, de la séparation des droits et d’une supervision opérée par le client.
Exemple de décision : choisir un modèle de service pour une charge de travail
Section intitulée « Exemple de décision : choisir un modèle de service pour une charge de travail »Le compromis central tient en une phrase : chaque cran monté dans la pile retire du travail d’exploitation et retire, dans la même proportion, de la visibilité et de la liberté de sortie. La recommandation : prendre le modèle le plus haut qui satisfait les contraintes, et ne descendre que sur une exigence nommée. Chaque couche reprise est une couche à corriger, superviser et tenir en compétence jour et nuit, et la plupart des organisations surestiment leur capacité à le faire mieux qu’un fournisseur dont c’est le métier. Conditions de validité : la maîtrise des identités et de la configuration existe déjà, les journaux sont exportables, la sortie a été essayée, et les exigences de localisation sont satisfaites par l’offre (voir la page sur la souveraineté des données et les flux inter-cloud).
Le schéma déroule cette règle pour une charge de travail quelconque. À lire de haut en bas : trois questions, quatre issues, et un socle commun auquel toutes les branches aboutissent.
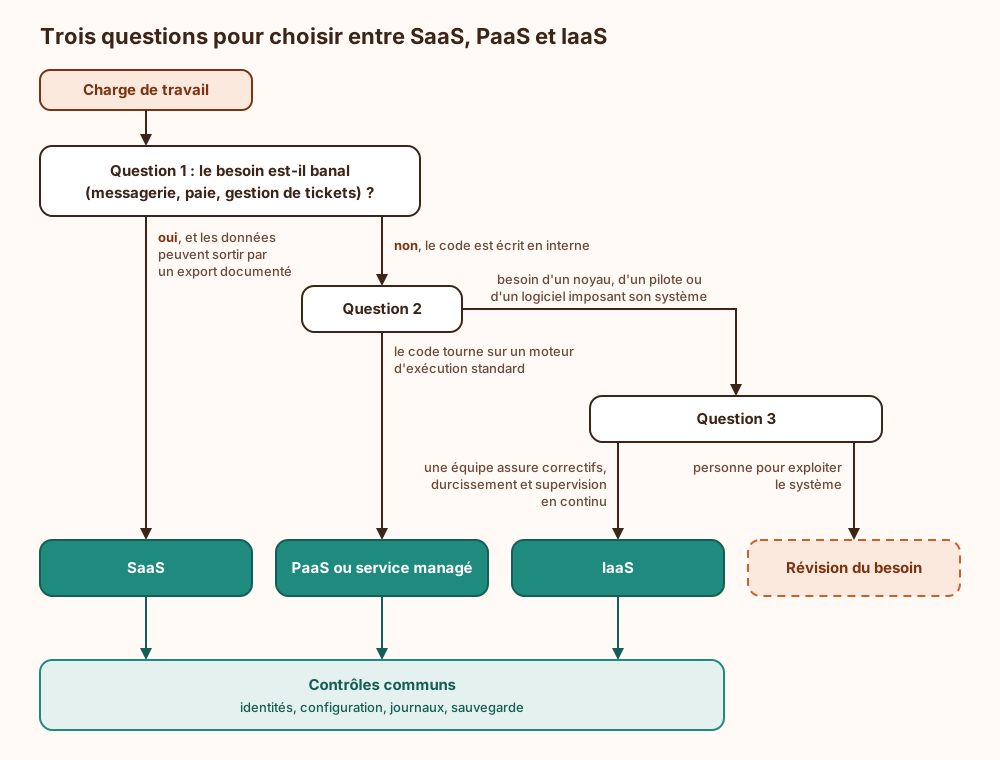
La branche « Révision du besoin » est la plus souvent ignorée : choisir l’IaaS « pour garder la main » sans personne pour tenir cette main produit des machines non corrigées avec une facture en plus. La dernière série de flèches rappelle que le choix du modèle ne change jamais le socle : il change seulement la quantité de travail empilée dessus. Quand deux modèles conviennent, la question qui départage est celle de la preuve : lequel permet de démontrer à un auditeur, journaux à l’appui, qui a accédé à quoi.
Un cloud privé est-il plus sûr qu’un cloud public ?
Section intitulée « Un cloud privé est-il plus sûr qu’un cloud public ? »Pas par nature. Il supprime le voisinage avec d’autres locataires et rend à l’organisation toutes les couches que le public délègue, plan de contrôle compris. Le résultat dépend de la capacité à exploiter ces couches, pas de l’adjectif.
Le SaaS dispense-t-il de sauvegarder ?
Section intitulée « Le SaaS dispense-t-il de sauvegarder ? »Non. L’éditeur protège son service contre ses propres pannes. Une suppression ou un chiffrement malveillant effectué avec un compte valide du client est une opération légitime de son point de vue, conservée le temps d’une corbeille dont la durée est fixée dans les conditions du service.
Où ranger un service managé qui ne ressemble ni à du PaaS ni à de l’IaaS ?
Section intitulée « Où ranger un service managé qui ne ressemble ni à du PaaS ni à de l’IaaS ? »Nulle part, et c’est sans gravité. Les trois cases sont un vocabulaire, pas une preuve. La seule opération qui compte est de reprendre les neuf couches pour ce service précis et d’attribuer chacune.
🐝 Ce qui arrive si on s’en passe
Section intitulée « 🐝 Ce qui arrive si on s’en passe »Sans attribution couche par couche, chaque partie suppose que l’autre s’en charge. Le système invité d’une machine virtuelle n’est corrigé par personne, la version du moteur d’exécution reste figée parce qu’elle était « gérée », et l’image de conteneur conserve des bibliothèques périmées derrière un service réputé managé. Les journaux du plan de contrôle, jamais exportés, expirent avant qu’une question leur soit posée : après une intrusion, impossible de dire quelle identité a créé quoi. Les sauvegardes dépendent des mêmes droits que la production et disparaissent avec elle. Enfin, la répartition réelle des tâches se découvre dans le contrat, pendant l’incident, au moment précis où elle ne peut plus être corrigée.
🦫 Explication de la marmotte 🍫
Section intitulée « 🦫 Explication de la marmotte 🍫 »Le cloud computing consiste à utiliser, par Internet, des ordinateurs, du stockage et des logiciels qui appartiennent à une autre entreprise, appelée fournisseur. Tout se commande à distance : un compte autorisé envoie une demande, le fournisseur vérifie les droits de ce compte, puis crée, modifie ou supprime ce qui est demandé. Celui qui vole un compte puissant peut donc tout faire, sans jamais entrer dans un bâtiment. Il existe trois formules. Dans la première, le fournisseur prête des machines, et le client installe, met à jour et surveille tout ce qui tourne dessus. Dans la deuxième, le fournisseur tient aussi le système à jour, et le client apporte seulement son programme. Dans la troisième, le fournisseur livre un logiciel prêt à l’emploi. Plus la formule est complète, moins le client a de travail technique, mais moins il voit ce qui se passe. Trois choses restent toujours à sa charge : ses informations, la liste des personnes qui ont le droit d’y accéder, et les réglages du service. Si un réglage ouvre un document à tout Internet, le fournisseur obéit, car il ne peut pas deviner l’intention. Le client reste aussi responsable devant la loi. Enfin, ces services peuvent être partagés entre de nombreux clients, réservés à un seul, ou combinés avec des machines installées chez soi, ce qui ajoute des liaisons à protéger.
À lire aussi
- Edge, MEC, Fog, Cloud-RAN et infrastructures distribuéesPrésenter les architectures qui rapprochent calcul, réseau et stockage des utilisateurs ou objets : edge, MEC, Fog, cloud continuum, Cloud-RAN et datacenters embarqués.
- Comment gouverner les coûts cloud contre un compte compromisLa gouvernance des coûts cloud limite l'impact financier d'un compte compromis en complétant la détection, les identités et la réponse à incident.
- Comment utiliser CSA STAR et le questionnaire CAIQLa certification STAR et le questionnaire CAIQ de la Cloud Security Alliance servent à évaluer la posture de sécurité d’un fournisseur cloud avant contractualisation.
- Sécuriser l’auto-scaling des instances éphémèresArchitecture cloud-native d’auto-scaling et sécurité des instances qui apparaissent et disparaissent dynamiquement.
Pages voisines
Cloud IaaS, PaaS, SaaS et modèles de déploiement, qui sécurise quoi
Elle cite
- Lien dans les deux sens :Comment auditer la responsabilité partagée cloud
- Sécurité multi-cloud et hybrid cloud
- Détecter la persistance IAM dans AWS
- Flux inter-cloud et résidence réelle des données
- Gérer une crise cloud multi-tenant
- Isolation réseau multi-tenant avec VPC et NetworkPolicy
- Quotas cloud contre le déni de service par coût
- Réconcilier inventaire IaC et cloud réel
- Réduire RBAC Kubernetes et bloquer les pods dangereux
- Sécuriser les bases de données managées cloud
- Sécuriser les fonctions serverless FaaS
- Déployer FIDO2 pour comptes à privilèges
: les deux pages se citent l’une l’autre.