
Docker ou Podman en auto-hébergement : root, rootless, isolation
Docker ou Podman en auto-hébergement : root, rootless, isolation
Section intitulée « Docker ou Podman en auto-hébergement : root, rootless, isolation »Sur un serveur autohébergé (une machine, un administrateur, des services exposés), le choix du moteur de conteneurs décide de ce qu’un attaquant obtient après avoir compromis un service : un compte ordinaire ou la machine entière. Docker repose par défaut sur un démon root piloté par un socket ; Podman lance les conteneurs sans démon, sous l’identité de l’utilisateur qui les demande. La position défendue ici : Podman rootless avec Quadlet pour une installation neuve, Docker conservé seulement quand l’outillage l’impose, et alors durci en connaissance de cause.
→ Lire l’explication complète de la marmotte
Démon root de Docker : dockerd, socket et groupe docker
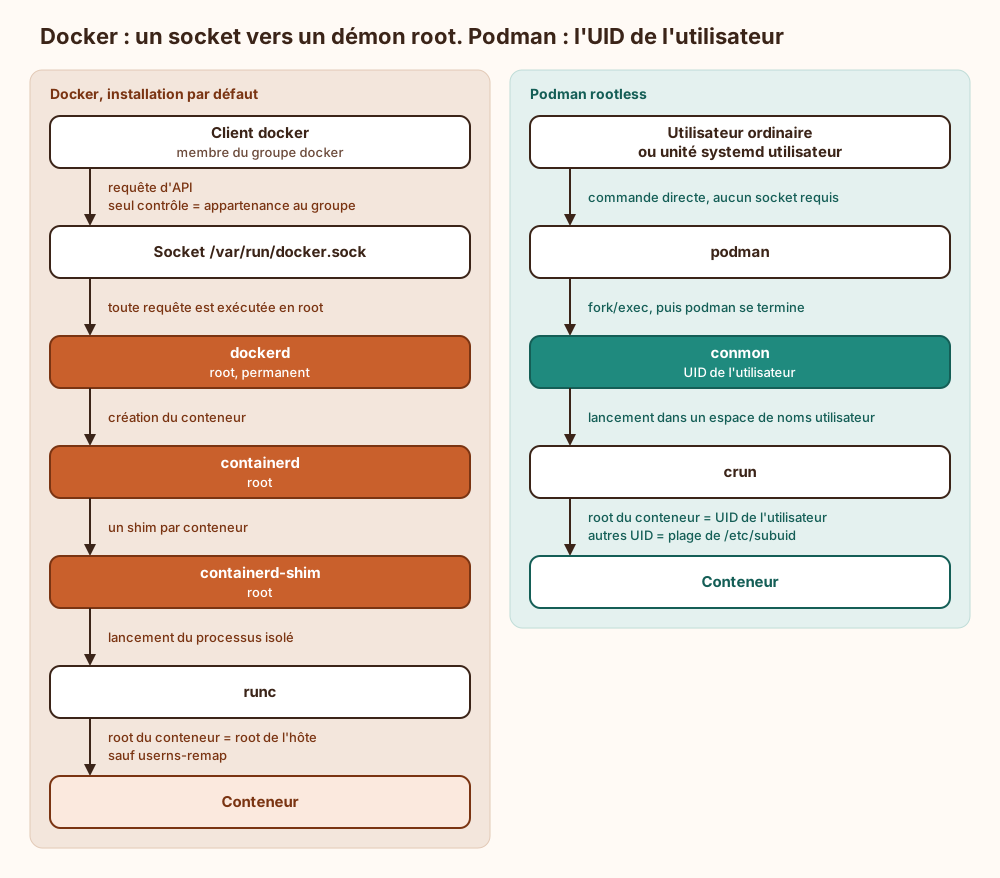
Section intitulée « Démon root de Docker : dockerd, socket et groupe docker »Docker, dans son installation par défaut, est une architecture client-serveur. Le client docker ne lance rien : il envoie une requête d’API (Application Programming Interface) au démon dockerd par le socket Unix /var/run/docker.sock. Le démon tourne en root, délègue à containerd, qui lance un containerd-shim par conteneur, lequel appelle runc, le runtime OCI (Open Container Initiative) qui crée effectivement le processus isolé.
Le socket appartient à root:docker. Le contrôle d’accès s’arrête là : quiconque peut écrire dans ce fichier peut demander au démon n’importe quoi, et le démon l’exécutera en root. docker run --rm -it -v /:/host debian chroot /host donne un shell root sur l’hôte en une ligne, sans faille, sans exploit, sans élévation de privilèges au sens habituel : c’est le fonctionnement nominal. L’appartenance au groupe docker équivaut donc à root, mot de passe sudo en moins et journalisation sudo en moins.
Trois conséquences d’architecture en découlent.
- Le compte de déploiement est root. Un compte ajouté au groupe
dockerpour « éviter de taper sudo » est un compte root dont la clé SSH (Secure Shell) traîne sur un poste de travail. - Les outils qui réclament le socket sont root. Proxy inverse à découverte automatique, tableau de bord d’administration, outil de mise à jour automatique des images : tous demandent
-v /var/run/docker.sock:/var/run/docker.sock. Le conteneur le plus exposé à Internet (le proxy inverse) se retrouve à un appel d’API de la machine entière. - Monter le socket en lecture seule ne protège rien. L’option
:roporte sur le fichier, pas sur les requêtes qui y transitent : créer un conteneur privilégié reste possible.
La contre-mesure qui tient consiste à ne jamais donner le socket brut : un proxy de socket filtrant (docker-socket-proxy est le plus répandu) n’expose que les routes d’API en lecture dont l’outil a besoin, sur un réseau interne dédié. La ligne docker.sock d’un fichier Compose est celle que personne ne relit, précisément parce que tous les tutoriels la contiennent.
Dernier détail d’exploitation : le démon est un point de défaillance commun. Sans l’option live-restore (désactivée par défaut), redémarrer dockerd arrête tous les conteneurs ; une mise à jour du paquet Docker devient une coupure de tous les services.
Podman sans démon : fork/exec, conmon et rootless par défaut
Section intitulée « Podman sans démon : fork/exec, conmon et rootless par défaut »Podman n’a pas de serveur. La commande podman run crée elle-même le conteneur par fork/exec : elle lance conmon (container monitor), un petit processus qui démarre le runtime OCI (crun ou runc), conserve les flux d’entrée-sortie et le code de retour, puis reste seul parent du conteneur une fois la commande terminée. Aucun processus permanent ne détient de privilèges en attendant des ordres.
Lancé par un utilisateur ordinaire, Podman est rootless sans configuration particulière : le conteneur vit dans un espace de noms utilisateur. Le root du conteneur, UID (User IDentifier) 0, correspond à l’UID de l’utilisateur sur l’hôte ; les autres identifiants sont tirés d’une plage subordonnée déclarée dans /etc/subuid et /etc/subgid (pour les GID, Group IDentifier), typiquement 65 536 identifiants par compte. Les binaires newuidmap et newgidmap appliquent cette correspondance. Les mécanismes noyau sous-jacents sont détaillés dans la page sur l’isolation des conteneurs par namespaces et cgroups ; ici, seule la conséquence compte : une évasion de conteneur donne un compte sans privilège, pas root.
Le schéma suivant compare les deux chaînes : regarder qui tourne en root, et où se trouve le point d’entrée unique.
Sans démon, personne ne redémarre les conteneurs au boot. Ce rôle revient à systemd, par Quadlet (intégré depuis Podman 4.4) : un fichier .container déposé dans ~/.config/containers/systemd/ est transformé en unité de service par un générateur systemd à chaque daemon-reload. Le conteneur devient un service comme un autre, avec dépendances, redémarrage et journal ; la page sur systemd couvre le reste. Piège numéro un du rootless : le gestionnaire systemd d’un utilisateur s’arrête à la fermeture de sa dernière session, et ses services avec lui. loginctl enable-linger <compte> le maintient actif et le démarre au boot. L’oubli se diagnostique toujours de la même façon : tout fonctionne jusqu’à la déconnexion SSH.
Podman sait aussi exposer un socket d’API compatible Docker (systemctl --user enable --now podman.socket, fichier dans $XDG_RUNTIME_DIR/podman/podman.sock). L’activer réintroduit le problème du socket à l’échelle de l’utilisateur : qui l’atteint contrôle tous les conteneurs, volumes et secrets de ce compte. Ce n’est plus root, mais c’est tout ce que le compte héberge. À n’activer que si un outil l’exige, et jamais dans un conteneur exposé.
Podman lancé avec sudo (mode rootful) reste possible. Il supprime le démon et le socket, pas le root dans le conteneur : il ne répond qu’à la moitié de la question.
Docker rootless et userns-remap : ce que cela change, ce que cela coûte
Section intitulée « Docker rootless et userns-remap : ce que cela change, ce que cela coûte »Docker propose deux réponses partielles, souvent confondues.
userns-remap (clé "userns-remap": "default" dans /etc/docker/daemon.json) laisse le démon en root mais place les conteneurs dans un espace de noms utilisateur, sur la plage subordonnée d’un compte dockremap. Une évasion de conteneur atterrit sur un UID sans privilège. Le socket, lui, reste équivalent root : le client peut passer --userns=host et annuler la protection. Le coût : images et volumes existants deviennent invisibles (le stockage bascule dans un sous-répertoire propre à la plage), --pid=host et --network=host sont incompatibles, et tous les conteneurs partagent la même plage, donc aucune séparation d’identité entre eux. Une protection contre l’évasion, aucune contre l’abus d’API : sur un serveur autohébergé, c’est la moins rentable des options.
Docker rootless (installé par dockerd-rootless-setuptool.sh install) fait tourner le démon lui-même dans un espace de noms utilisateur, sous un compte ordinaire, avec un socket dans $XDG_RUNTIME_DIR/docker.sock. Le modèle de menace rejoint celui de Podman rootless : le socket ne vaut plus que le compte. Le démon demeure (point de défaillance commun, service utilisateur à maintenir avec enable-linger), AppArmor et les réseaux overlay ne sont pas pris en charge, et tous les coûts du rootless décrits ci-dessous s’appliquent. Son intérêt : conserver Docker Compose tel quel.
Coûts réels du mode rootless : ports, réseau, volumes, cgroup v2 et SELinux
Section intitulée « Coûts réels du mode rootless : ports, réseau, volumes, cgroup v2 et SELinux »Le rootless n’est pas gratuit. Les présentations qui le montrent comme une case à cocher oublient cinq factures.
Ports inférieurs à 1024. Un processus sans privilège ne peut pas écouter en dessous du seuil fixé par le paramètre noyau net.ipv4.ip_unprivileged_port_start (1024 par défaut). Trois sorties : abaisser le seuil à 80 (tout compte local peut alors écouter sur 80 et 443, acceptable sur une machine à administrateur unique, discutable ailleurs) ; publier sur 8080 et 8443 puis rediriger par une règle nftables ; ou placer la terminaison en amont. La mécanique de redirection est décrite dans la page sur le NAT et la publication de services.
Réseau en espace utilisateur et adresse source. Sans root, pas d’interface virtuelle branchée sur un pont de l’hôte : le trafic passe par une pile réseau en espace utilisateur, slirp4netns historiquement, pasta par défaut depuis Podman 5.0. Deux effets. Le débit baisse, sans conséquence pour un service personnel, sensible pour du transfert de fichiers volumineux. Surtout, selon le mode, le conteneur ne voit plus l’adresse IP (Internet Protocol) du client mais une adresse interne : c’est le cas quand la publication passe par un relais en espace utilisateur (réseau bridge rootless de Podman, pilote de ports par défaut de Docker rootless). Un proxy inverse qui ne voit qu’une seule adresse source rend inopérants la limitation de débit par client, le bannissement automatique et l’exploitation des journaux d’accès. Le test tient en une requête depuis l’extérieur et une lecture du journal. Les remèdes : attacher le proxy inverse directement à pasta (qui conserve l’adresse source), utiliser l’activation par socket systemd, ou accepter le pilote de ports plus lent qui la préserve.
Volumes et décalage des UID. Un processus qui tourne en UID 1000 dans le conteneur écrit sur l’hôte avec le 1000e identifiant de la plage subordonnée (100999 si elle commence à 100000). Le répertoire monté, créé par l’utilisateur, lui est donc interdit en écriture : Permission denied au premier démarrage, classique indémodable. Les réponses : l’option de volume :U (changement de propriétaire récursif vers l’identité du conteneur), --userns=keep-id (l’UID de l’utilisateur est conservé dans le conteneur), ou podman unshare chown pour corriger depuis l’espace de noms. Corollaire pour la sauvegarde : les fichiers ainsi créés appartiennent à un identifiant subordonné, et le compte lui-même peut se les voir refuser hors de l’espace de noms.
Limites de ressources. Plafonner mémoire et processeur en rootless exige cgroup (control group) v2 en hiérarchie unifiée, et la délégation des contrôleurs au gestionnaire systemd de l’utilisateur. Selon la version de systemd, seuls memory et pids sont délégués d’office ; le contenu de /sys/fs/cgroup/user.slice/user-<uid>.slice/user@<uid>.service/cgroup.controllers indique ce qui l’est réellement, et une directive Delegate= sur [email protected] complète la liste. Une limite déclarée mais non déléguée échoue ou, pire, est ignorée avec un avertissement que personne ne lit.
Étiquettes SELinux (Security-Enhanced Linux). Sur un hôte où SELinux est actif (Fedora et dérivés), un volume monté sans étiquette est refusé au conteneur quels que soient les droits Unix. Le suffixe :Z pose une étiquette privée, :z une étiquette partagée entre conteneurs. À ne jamais appliquer à un répertoire personnel entier ni à /etc : le réétiquetage est récursif et casse les autres usages du répertoire.
Côté stockage, un noyau ancien impose le repli sur fuse-overlayfs, nettement plus lent que l’overlay natif.
Ports publiés par Docker et pare-feu local : le contournement de ufw
Section intitulée « Ports publiés par Docker et pare-feu local : le contournement de ufw »C’est le piège de l’auto-hébergement, celui qui expose une base de données en croyant l’avoir fermée. Quand Docker publie un port (-p 5432:5432), le démon ne fait pas écouter un processus sur l’hôte : il insère une règle DNAT (Destination NAT, pour Network Address Translation) dans la table nat, puis des règles d’acceptation en tête de la chaîne FORWARD. Le paquet entrant est réécrit vers l’adresse du conteneur avant tout filtrage, puis routé. Il ne traverse jamais la chaîne INPUT, là où ufw (Uncomplicated Firewall) pose ses règles.
Le schéma montre les deux trajets : celui d’un port publié par un démon root, et celui d’un port publié en rootless.
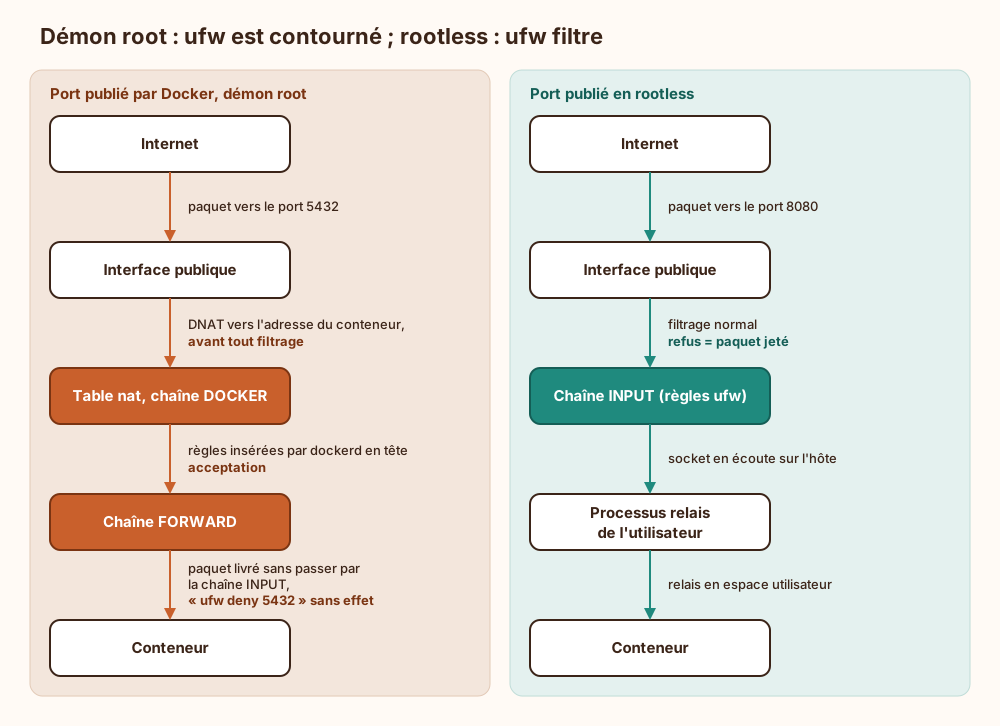
Résultat : ufw status affiche fièrement une politique de refus par défaut pendant que le port répond depuis Internet, puisque la publication se fait par défaut sur toutes les adresses de l’hôte. Un pare-feu qui dit non pendant que le paquet passe par la porte d’à côté, c’est une forme de sérénité.
Les contre-mesures, par ordre de rentabilité :
- Publier sur la boucle locale :
127.0.0.1:5432:5432. Seul le proxy inverse est publié sur l’adresse publique. La clé"ip": "127.0.0.1"dedaemon.jsonen fait l’adresse de publication par défaut, mais seulement sur le réseau bridge par défaut : les réseaux créés par Compose l’ignorent, d’où l’intérêt d’écrire l’adresse dans chaque publication. - Ne pas publier du tout les services internes : deux conteneurs sur le même réseau Docker se joignent sans port publié.
- Filtrer dans la chaîne
DOCKER-USER, prévue pour cela et évaluée avant les règles du démon. Attention : à ce stade le paquet a déjà subi le DNAT, le filtrage par port d’origine passe par le module conntrack. - Un pare-feu en amont (celui de l’hébergeur ou de la box) comme périmètre réel.
Désactiver la gestion d’iptables par le démon ("iptables": false) casse la sortie réseau des conteneurs et se paie en règles manuelles : mauvais remède. Podman rootful pose lui aussi des règles de traduction : même prudence, et même vérification depuis l’extérieur. En rootless (Podman ou Docker), le port est ouvert par un processus ordinaire de l’hôte : le pare-feu local s’applique normalement. C’est un bénéfice du rootless rarement cité, et pas le moindre. Le reste du durcissement réseau de l’hôte relève de la checklist de durcissement d’un serveur Linux.
Compose, Quadlet et mises à jour automatiques
Section intitulée « Compose, Quadlet et mises à jour automatiques »L’argument le plus sérieux en faveur de Docker n’est pas technique : chaque projet autohébergeable livre un fichier Compose, et docker compose up -d fonctionne. Côté Podman, trois voies, de valeur inégale.
podman composen’est qu’un lanceur : il appelle un fournisseur externe. Avecdocker-compose, il faut activer le socket d’API de Podman (retour du problème du socket, à l’échelle du compte). Avecpodman-compose, projet communautaire, la couverture de la spécification Compose est partielle : les fichiers exotiques cassent.- Quadlet est la voie native : un fichier
.containerpar service, plus.networket.volumeau besoin. La traduction d’un fichier Compose se fait à la main ou avec l’outilpodlet. C’est un coût d’entrée réel, une fois par service. podman kube playaccepte un manifeste au format Kubernetes, intéressant seulement si ce format existe déjà.
Pour les mises à jour, les deux modèles s’opposent encore. Côté Docker, l’automatisation passe par un conteneur tiers qui exige le socket, donc un équivalent root connecté à un registre public : beaucoup de confiance accordée pour s’épargner un docker compose pull. Côté Podman, podman auto-update est intégré : les conteneurs marqués AutoUpdate=registry (nom d’image complet, registre inclus) sont comparés au registre par le minuteur podman-auto-update.timer, l’unité systemd est redémarrée, et l’image précédente est restaurée si le redémarrage échoue. Aucun socket, aucun privilège.
Dans les deux cas, la mise à jour automatique d’une étiquette flottante revient à exécuter ce que le registre servira demain. Elle se défend pour un proxy inverse ou un service sans état ; pour une base de données, épingler une version majeure et mettre à jour à la main après sauvegarde. Le choix des images elles-mêmes est traité dans la page sur la généalogie des images de base Docker.
Docker ou Podman : arbre de décision pour un serveur autohébergé
Section intitulée « Docker ou Podman : arbre de décision pour un serveur autohébergé »Le compromis central tient en une phrase : le rootless réduit ce que vaut une compromission (un compte au lieu de la machine) et se paie en friction sur le réseau, les volumes et l’outillage. Sur une machine exposée tenue par une seule personne, sans équipe pour détecter une intrusion, réduire la portée d’une compromission vaut plus que le confort. Les risques propres à cette configuration sont développés dans l’éditorial sur l’infrastructure tenue par une seule personne.
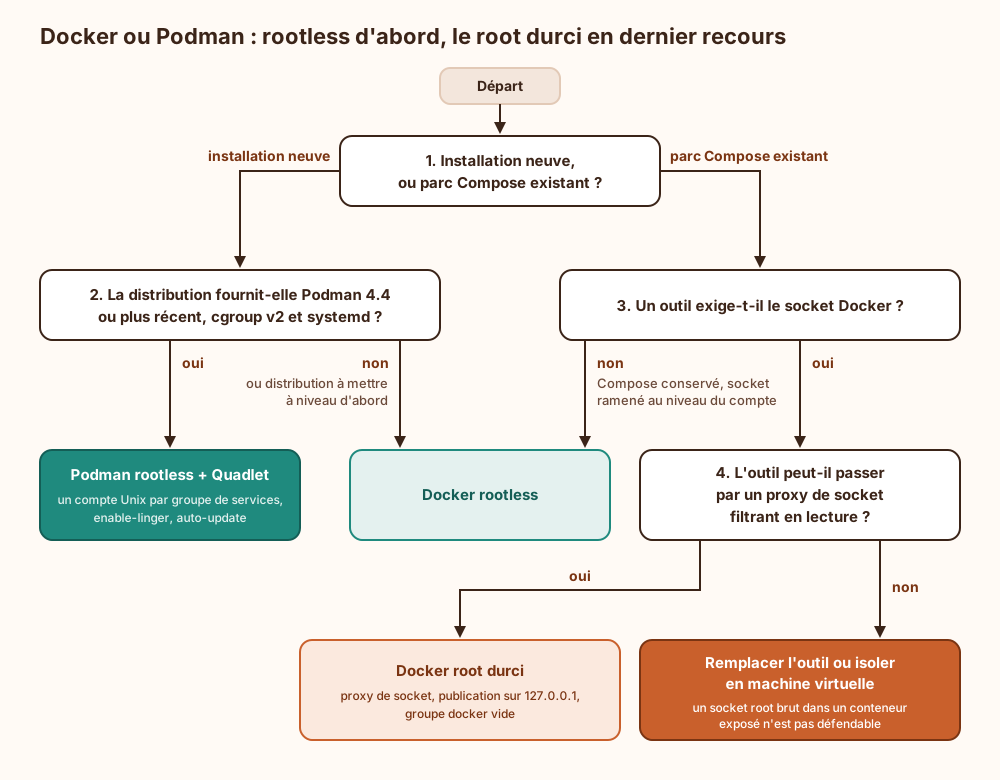
Conditions de validité de la recommandation Podman rootless : accepter de traduire les fichiers Compose, vérifier la conservation de l’adresse source avant de brancher un bannissement automatique, et ne pas avoir besoin de fonctions réseau qui exigent root. Si l’un de ces points bloque, Docker rootless est le repli raisonnable. Docker root durci reste tenable à trois conditions : aucun compte humain dans le groupe docker (passer par sudo, qui journalise), aucun socket brut monté dans un conteneur, aucun port publié hors boucle locale sauf le proxy inverse.
Dernière règle, valable dans tous les cas : en rootless, les conteneurs d’un même compte partagent la même plage d’identifiants et le même stockage. La séparation entre services passe par des comptes Unix distincts (un par groupe de services), chacun avec sa plage dans /etc/subuid.
Exemple : service Podman rootless déclaré en Quadlet
Section intitulée « Exemple : service Podman rootless déclaré en Quadlet »Un serveur web statique sous un compte dédié, publié sur la boucle locale pour un proxy inverse en amont. Le fichier se dépose tel quel ; le nom du fichier donne le nom du service.
[Unit]Description=Site statique servi en rootless
[Container]# Nom complet, registre inclus : exigé par la mise à jour automatiqueImage=docker.io/library/caddy:2# Boucle locale uniquement, port non privilégiéPublishPort=127.0.0.1:8080:80# %h = répertoire personnel ; ro = lecture seule ; Z = étiquette SELinux privéeVolume=%h/srv/site:/usr/share/caddy:ro,ZAutoUpdate=registry
[Service]Restart=on-failure
[Install]# Démarrage avec le gestionnaire systemd de l'utilisateurWantedBy=default.target# Maintenir les services du compte hors session et au bootsudo loginctl enable-linger "$USER"
mkdir -p ~/srv/site ~/.config/containers/systemdecho 'ok' > ~/srv/site/index.html
# Génération de site.service par Quadlet, puis démarragesystemctl --user daemon-reloadsystemctl --user start site.service
# Vérification quotidienne des images marquées AutoUpdatesystemctl --user enable --now podman-auto-update.timer
curl -s http://127.0.0.1:8080/ # doit répondre : okÀ noter : une unité générée par Quadlet ne s’active pas avec systemctl enable ; c’est la section [Install] du fichier qui la rattache au démarrage. Les journaux se lisent avec journalctl --user -u site.service.
Limites de l’isolation rootless et conditions d’exploitation
Section intitulée « Limites de l’isolation rootless et conditions d’exploitation »Prérequis de plateforme. Espaces de noms utilisateur non privilégiés autorisés par le noyau (certaines distributions les restreignent), binaires newuidmap et newgidmap installés, plages déclarées dans /etc/subuid et /etc/subgid pour chaque compte, cgroup v2, systemd avec session utilisateur persistante, paquet fournissant pasta, et Podman 4.4 au minimum pour Quadlet.
Ce que le rootless ne garantit pas. Le noyau reste partagé : une faille noyau exploitable depuis un conteneur traverse l’isolation, rootless ou non. Les espaces de noms utilisateur élargissent d’ailleurs la surface noyau accessible à un compte sans privilège, raison pour laquelle certaines distributions les brident. Le rootless ne sépare pas non plus les conteneurs d’un même compte, ne protège pas les données que ce compte héberge, et ne dit rien du contenu des images. Pour une frontière forte entre un service à risque et le reste, la réponse est une machine virtuelle : voir la comparaison des hyperviseurs de type 1 et de type 2.
Secrets. Une variable d’environnement se lit dans la sortie de inspect et dans le fichier Compose ou Quadlet. Podman fournit podman secret et la clé Secret= de Quadlet, qui montent le secret en fichier dans le conteneur. Avec Docker hors Swarm, les secrets Compose sont des fichiers montés : leur protection dépend des droits du fichier source. L’architecture d’ensemble est traitée dans la page sur la gestion des secrets en environnement distribué.
Sauvegarde et reprise. Les volumes vivent sous /var/lib/docker/volumes (Docker root) ou sous ~/.local/share/containers/storage/volumes (Podman rootless). En rootless, la sauvegarde doit tourner en root ou dans l’espace de noms (podman unshare), faute de quoi les fichiers aux identifiants subordonnés sont ignorés sans bruit. Sauvegarder aussi les fichiers Quadlet ou Compose et les plages de /etc/subuid : restaurer des volumes sur une machine dont la plage diffère donne des fichiers au mauvais propriétaire. Une restauration jamais testée est une hypothèse, pas une sauvegarde.
Supervision. Le pilote de journaux par défaut de Docker (json-file) ne fait aucune rotation tant que max-size n’est pas configuré : un conteneur bavard finit par remplir le disque. Avec Quadlet, les journaux partent dans journald, qui applique ses propres quotas. Dans les deux cas, surveiller l’état des unités ou des conteneurs, l’espace disque du stockage d’images (nettoyage périodique par prune) et le résultat des mises à jour automatiques. Les autres briques de l’hébergement personnel sont recensées dans la rubrique Infrastructure.
🐝 Ce qui arrive si on s’en passe
Section intitulée « 🐝 Ce qui arrive si on s’en passe »Rester sur l’installation par défaut sans arbitrer, c’est accepter que tous les services partagent un même sort. Le démon exécute chaque requête en root sans consigner par défaut quel compte l’a émise : après un incident, impossible d’attribuer une création de conteneur à une personne ou à un outil. La compromission d’un seul service relié au socket emporte les volumes de tous les autres, les clés d’accès de l’hôte et les sauvegardes locales. La reprise change alors de nature : une machine où un attaquant a été root ne se nettoie pas, elle se réinstalle, et chaque secret qu’elle contenait doit être renouvelé. Avec un compte dédié par service, la même intrusion se traite en supprimant un compte et ses données.
🦫 Explication de la marmotte 🍫
Section intitulée « 🦫 Explication de la marmotte 🍫 »Un conteneur est un programme lancé dans un espace isolé du reste de la machine. Pour le lancer, il faut un logiciel appelé moteur. Docker confie ce travail à un programme permanent qui tourne avec le compte administrateur, celui qui a tous les droits. On lui parle par un fichier spécial : toute personne ou tout programme autorisé à écrire dans ce fichier peut lui demander n’importe quoi, donc obtenir tous les droits sur la machine. Podman procède autrement : aucun programme permanent, chaque conteneur est lancé directement par le compte ordinaire qui le demande, et ne peut jamais dépasser les droits de ce compte. Si un attaquant s’échappe du conteneur, il se retrouve avec un compte limité au lieu du compte administrateur. Ce choix a un prix. Un compte ordinaire ne peut pas écouter sur les portes d’entrée réseau réservées, les fichiers partagés changent de propriétaire apparent, et le service peut ne plus voir l’adresse réelle des visiteurs. Autre point : quand Docker ouvre un service vers l’extérieur, il modifie lui-même les règles de filtrage réseau, avant celles posées par l’administrateur ; un service que l’on croit bloqué reste alors joignable depuis Internet. Dans tous les cas, les conteneurs partagent le cœur du système : une faille à cet endroit traverse l’isolation, quel que soit le moteur.
À lire aussi
- Conteneurs, Kubernetes, CNI et service meshComprendre les réseaux de conteneurs et Kubernetes : namespaces réseau, bridges, CNI, Services, Ingress, NetworkPolicy, DNS de cluster, egress et service mesh.
- Sécuriser l’auto-scaling des instances éphémèresArchitecture cloud-native d’auto-scaling et sécurité des instances qui apparaissent et disparaissent dynamiquement.
- Exploiter une race condition TOCTOU sur fichier privilégiéDémonstration d'une attaque TOCTOU sur une opération de fichier privilégiée, avec mécanisme, reproduction contrôlée et contre-mesures.
- Linux shell, permissions et processus, le modèle de contrôle d'accèsComment un système Linux décide qui a le droit de faire quoi, du shell qui lance les processus aux identités, permissions et capabilities que ces processus portent.
Pages voisines
La citent
Docker ou Podman en auto-hébergement : root, rootless, isolation
Elle cite
- Lien dans les deux sens :Écrire un Dockerfile durci avec condensé, multi-étapes et non root
- Lien dans les deux sens :Isolation des conteneurs Docker : namespaces, cgroups et évasions
- Durcir un serveur Linux avant la mise en production, checklist
- Gestion des secrets applicatifs distribués avec rotation
- Hyperviseur Type 1 ou Type 2 : lequel choisir
- Images Docker de base et confiance héritée
- Mettre en place un rate limiting anti-DDoS L7
- NAT, translations et publication de services
- Systemd : gérer services, unités et journal sous Linux
- Une infrastructure tenue par une seule personne
: les deux pages se citent l’une l’autre.