
Détecter la persistance IAM dans AWS
Détecter la persistance IAM dans AWS
Section intitulée « Détecter la persistance IAM dans AWS »La persistance IAM (Identity and Access Management, gestion des identités et des accès) consiste à conserver un chemin d’accès après la compromission d’un environnement AWS (Amazon Web Services). Le compromis central est brutal : journaliser et comparer finement les configurations coûte en stockage, en requêtes et en exploitation, mais ignorer les changements d’identité laisse l’attaquant choisir tranquillement la date de son retour.
→ Lire l’explication complète de la marmotte
Prérequis CloudTrail et inventaire IAM
Section intitulée « Prérequis CloudTrail et inventaire IAM »La détection doit reposer sur deux sources distinctes : un journal d’événements et un état de référence. AWS CloudTrail enregistre les appels aux interfaces AWS, tandis qu’AWS Config, ou un export périodique des politiques IAM, permet de comparer la configuration effective à une version approuvée. CloudTrail seul explique qu’un changement a eu lieu, pas si ce changement est acceptable. C’est un journal, pas un oracle moral.
Activer un trail d’organisation, multi-région, vers un compte de journalisation séparé. Inclure les événements de gestion et conserver les journaux au moins 400 jours pour couvrir une clé dormante créée avant un cycle annuel d’audit. La rétention chaude peut être plus courte, à condition que les archives restent interrogeables depuis Amazon Athena ou CloudTrail Lake.
Les prérequis minimaux sont les suivants :
- CloudTrail organisationnel avec validation d’intégrité des fichiers activée.
- AWS Config sur toutes les régions activées, y compris celles supposées inutilisées.
- Un inventaire versionné des rôles, politiques gérées, clés d’accès et règles EventBridge.
- Un compte de sécurité disposant d’un rôle de lecture inter-comptes, sans droit de modification.
- Une synchronisation horaire correcte : corréler une création de clé, une élévation de privilège et un premier usage devient absurde avec des horloges divergentes.
La désactivation de CloudTrail, la modification de sa destination ou de sa politique de chiffrement doit produire une alerte de priorité maximale. Une détection de persistance sans protection des journaux revient à installer une caméra dont le bouton marche est posé dehors, sous une pancarte « ne pas toucher ».
Le périmètre IAM dépasse les utilisateurs humains. Inclure les rôles assumables, les identités fédérées, les clés d’accès, les politiques en ligne, les politiques gérées, les fournisseurs OpenID Connect et les autorisations de ressources. Cette cartographie complète l’architecture des identités et doit être reliée à la surface de menace (page à venir), pas enfermée dans un tableur d’habilitations.
Rôles de confiance modifiés
Section intitulée « Rôles de confiance modifiés »La politique de confiance d’un rôle définit qui peut appeler AssumeRole auprès du service STS (Security Token Service, service de jetons de sécurité). Modifier cette politique est une persistance très rentable : un principal externe, un autre compte, un fournisseur d’identité ou un service AWS peut obtenir des identifiants temporaires légitimes.
Surveiller les événements UpdateAssumeRolePolicy, CreateRole, DeleteRole, PutRolePermissionsBoundary et TagRole. Les tags peuvent conditionner des politiques d’autorisation, notamment via aws:PrincipalTag ou aws:ResourceTag. Une politique de confiance sans condition sur l’identifiant externe pour un partenaire tiers est une porte arrière contractuelle, pas une fédération.
Une requête CloudTrail Lake isole les mutations de confiance, puis chaque nouvelle politique est confrontée à la référence :
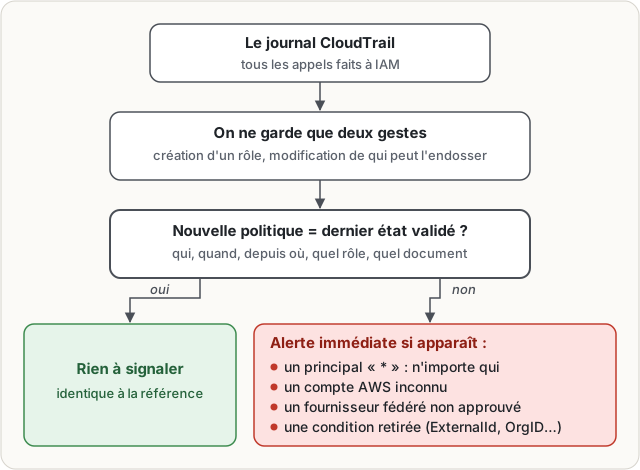
La requête seule ne suffit pas à qualifier le risque. Extraire le document de politique, le normaliser, puis le comparer au dernier état validé. Déclencher une alerte immédiate lorsqu’apparaissent un principal *, un compte inconnu, un fournisseur fédéré non approuvé, ou une suppression de conditions aws:PrincipalOrgID, sts:ExternalId, aws:SourceArn ou aws:SourceAccount.
La contre-mesure ne consiste pas à interdire tous les rôles inter-comptes. Elle consiste à imposer une liste explicite de relations de confiance, des conditions de contexte, et une revue des écarts. Une Service Control Policy, ou SCP (Service Control Policy, politique de contrôle de service), peut empêcher certains appels IAM hors comptes délégués, mais ne détecte rien et ne remplace pas le contrôle sémantique des politiques.
Clés d’accès dormantes et réactivation
Section intitulée « Clés d’accès dormantes et réactivation »Une clé d’accès IAM est une paire d’identifiants permanents utilisée par des outils, des scripts ou des applications anciennes. Une clé inactive depuis longtemps, jamais utilisée ou créée pour un utilisateur désactivé constitue une persistance discrète : elle peut être réactivée, ou n’attendre qu’une fuite déjà survenue. Les clés permanentes sont rarement nécessaires pour les charges AWS natives. Le moindre rôle temporaire bien conçu bat une clé statique, même si cela vend moins de licences de coffre à secrets.
Le rapport d’identifiants IAM distingue les clés actives, leur dernière utilisation et leur date de rotation. Générer ce rapport quotidiennement, l’archiver, puis alerter sur les cas suivants :
- clé active sans utilisation depuis 45 jours ;
- clé active jamais utilisée après sept jours ;
- clé utilisée après plus de 45 jours de silence ;
- clé appartenant à un utilisateur sans activité console ou sans propriétaire recensé ;
- création de clé suivie d’un appel API depuis une adresse réseau inhabituelle.
Une requête CloudTrail Lake cherche, clé par clé, une réapparition après une absence de 45 jours. Elle nécessite de conserver les événements de gestion sur une période supérieure à cette fenêtre.
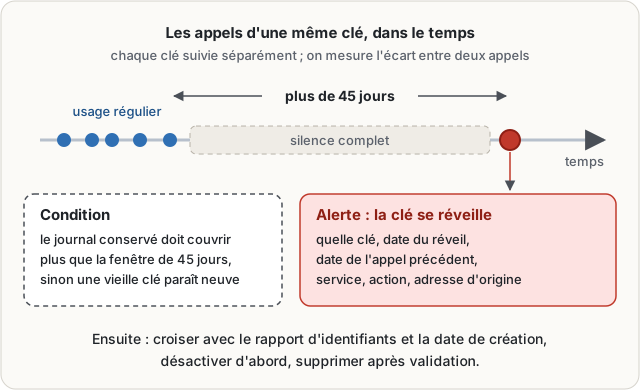
Cette détection dépend du journal disponible. Une clé utilisée hors période de rétention semble neuve, alors qu’elle est seulement mal documentée. Corréler avec le rapport d’identifiants et avec la date de création de la clé. Désactiver d’abord, supprimer ensuite après validation applicative. Supprimer sans phase d’observation transforme parfois une persistance en incident de production, ce qui est une façon très créative de perdre la chronologie.
La rotation doit être pilotée par un propriétaire technique identifié et non par l’âge seul. Une rotation automatique sans mécanisme de distribution atomique casse les consommateurs ; une rotation jamais exécutée casse la sécurité. Entre les deux, il existe l’ingénierie.
Lambda et règles EventBridge persistantes
Section intitulée « Lambda et règles EventBridge persistantes »Une fonction AWS Lambda exécutée par une règle Amazon EventBridge peut créer une persistance différée. La règle lance la fonction selon un calendrier ou un événement ; la fonction assume ensuite un rôle, crée une clé, modifie une politique ou exfiltre des données. Le code n’a pas besoin d’être sophistiqué. Un appel IAM dans une fonction planifiée suffit, ce qui est hélas compatible avec beaucoup de démonstrations de « cloud automation ».
Détecter les créations et modifications de règles, cibles, permissions Lambda et code de fonction. Les événements à surveiller sont PutRule, PutTargets, RemoveTargets, DeleteRule, AddPermission, CreateFunction, UpdateFunctionCode et UpdateFunctionConfiguration. Une même requête CloudTrail Lake les rassemble en une liste chronologique, qui suit pas à pas la chaîne installée par l’attaquant.
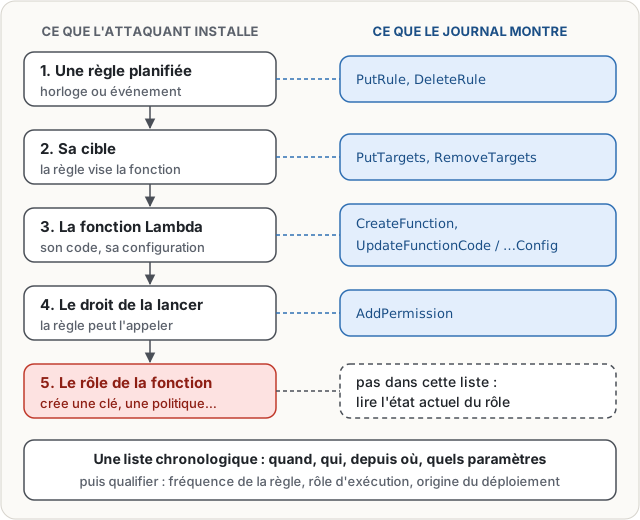
Qualifier l’alerte en récupérant l’état actuel : expression de planification, cible, rôle d’exécution, variables d’environnement, couche Lambda, image de conteneur éventuelle et politique de ressource. Une fonction avec un rôle permissif et une règle toutes les cinq minutes mérite davantage d’attention qu’une fonction de traitement déclarée dans l’infrastructure-as-code et déclenchée par un événement métier connu.
AWS Config peut vérifier l’existence des ressources, mais pas l’intention fonctionnelle. Exiger que chaque règle et fonction ait un propriétaire, une étiquette de criticité et une origine de déploiement. Les ressources créées hors pipeline CI/CD (Continuous Integration and Continuous Delivery, intégration et livraison continues) doivent être exceptionnelles et traçables.
Matrice de couverture et priorisation
Section intitulée « Matrice de couverture et priorisation »| Technique | Signal primaire | Requête ou contrôle | Contre-mesure | Limite résiduelle |
|---|---|---|---|---|
| Politique de confiance modifiée | UpdateAssumeRolePolicy | CloudTrail Lake, comparaison JSON normalisée | Conditions de confiance, liste de principaux autorisés | Une modification approuvée reste indiscernable sans référence |
| Clé d’accès dormante | Reprise d’activité, rapport d’identifiants | Écart entre deux appels supérieur à 45 jours | Désactivation, rotation, migration vers rôles temporaires | L’historique incomplet masque l’inactivité réelle |
| Règle EventBridge vers Lambda | PutRule, PutTargets, AddPermission | Corrélation règle, cible, rôle et code | Infrastructure-as-code, permission minimale | Le code légitime peut contenir une action abusive |
| Politique d’administration attachée | AttachRolePolicy, PutRolePolicy | Détection de politiques administratives ou inconnues | Permissions boundary, revue des écarts | Une politique sur mesure peut équivaloir à l’administration |
| Fournisseur fédéré ajouté | CreateOpenIDConnectProvider, CreateSAMLProvider | Inventaire des émetteurs approuvés | Approbation centralisée, restrictions de confiance | Un fournisseur approuvé peut être compromis hors AWS |
La priorité opérationnelle doit suivre la capacité d’action : d’abord les changements de confiance et les élévations de privilège, ensuite les nouvelles clés et automatisations, enfin les écarts d’inventaire. Alertes sans propriétaire ni délai de traitement finissent en décoration de tableau de bord. Les tableaux de bord ont déjà assez souffert.
Limites, réponses et exploitation des alertes
Section intitulée « Limites, réponses et exploitation des alertes »La détection de persistance IAM ne garantit pas l’absence de compromission. Elle ne voit pas une session temporaire déjà émise avant la révocation, une action réalisée avec des droits légitimes, un jeton fédéré obtenu auprès d’un fournisseur compromis, ni un secret exfiltré sans appel AWS observable. La révocation d’une politique ne révoque pas rétroactivement toutes les sessions STS déjà délivrées ; réduire leur durée maximale est donc une mesure de confinement, pas une préférence esthétique.
Lorsqu’une alerte est confirmée, préserver d’abord les journaux et l’état des politiques. Désactiver les clés concernées, retirer les permissions ajoutées, rétablir la politique de confiance depuis une version validée, puis invalider ou réduire les sessions selon les mécanismes disponibles. Supprimer immédiatement la fonction ou la règle suspecte détruit parfois la preuve et ne garantit pas que le rôle associé soit sain.
Les sauvegardes doivent inclure les exports de politiques IAM, les rapports d’identifiants, les définitions EventBridge et les configurations Lambda. Sauvegarder seulement les données applicatives ne permet pas de reconstruire l’identité du système. Or l’identité est précisément ce que l’attaquant essaie de posséder.
Enfin, protéger les rôles de lecture du dispositif. Un rôle de sécurité capable de lire tous les journaux et toutes les politiques devient une cible de choix. Séparer collecte, analyse et administration, appliquer le moindre privilège, puis tester régulièrement qu’un compte compromis ne peut ni effacer les traces ni modifier la référence. La gouvernance des accès (page à venir) doit traiter ce dispositif comme une fonction de sécurité, pas comme un export mensuel.
🐝 Ce qui arrive si on s’en passe
Section intitulée « 🐝 Ce qui arrive si on s’en passe »Sans ce dispositif, la porte de la ruche reste ouverte après la fermeture du dossier : la remédiation se limite aux accès connus, et un rôle de confiance élargi ou une clé jamais utilisée suffit à rouvrir l’accès sans nouvelle intrusion visible. La conséquence la plus coûteuse est l’impossibilité de dater le début de la compromission : sans état de référence versionné ni journal conservé au delà de la fenêtre d’audit, aucun périmètre d’incident n’est démontrable, et la question de savoir quelles données ont été atteintes reste sans réponse défendable devant un auditeur ou une autorité. La reconstruction du compte devient alors une reconstruction à l’aveugle, puisque les droits restaurés proviennent de l’état courant, c’est à dire potentiellement de celui laissé par l’attaquant. Les rotations de secrets perdent leur effet si les relations de confiance modifiées subsistent.
🦫 Explication de la marmotte 🍫
Section intitulée « 🦫 Explication de la marmotte 🍫 »Dans un environnement informatique, des identités donnent le droit d’effectuer des actions : lire des données, lancer un programme, créer un compte ou modifier une règle. Une personne malveillante qui obtient un accès cherche souvent à en créer un autre, moins visible, afin de revenir plus tard même si le premier accès est supprimé.
La surveillance commence par l’enregistrement des actions réalisées dans le service en ligne. Ces enregistrements indiquent quelle identité a modifié une règle, créé une clé d’accès ou ajouté un programme automatique. Il faut aussi conserver une liste approuvée des droits et des programmes attendus. Sans cette liste, on sait qu’un changement existe, mais pas s’il est autorisé.
Trois contrôles sont particulièrement utiles. Le premier repère une modification des personnes ou services autorisés à utiliser un rôle. Le deuxième cherche les clés d’accès restées inutilisées longtemps puis soudainement réemployées. Le troisième surveille les programmes qui peuvent être lancés automatiquement à une heure prévue ou lors d’un événement.
Quand un écart est détecté, il faut conserver les preuves, vérifier l’origine du changement, retirer les droits ou clés suspects et restaurer la configuration validée. Si les journaux ont été supprimés, si la liste approuvée manque, ou si les droits temporaires restent actifs, l’enquête devient incomplète et le retour de l’attaquant peut passer inaperçu.
À lire aussi
- Mettre en place un accès JIT AWS pour comptes à privilègesGuide pratique pour déployer un accès juste-à-temps AWS avec rôles temporaires, approbation, révocation automatisée et audit CloudTrail.
- Configurer GitHub Actions OIDC vers AWS sans clé statiqueGuide pratique pour fédérer une identité GitHub Actions vers AWS avec OpenID Connect et des rôles temporaires strictement limités à un dépôt et une branche.
- Mettre en place la fédération d’identité de chargeLa fédération d’identité de charge de travail remplace les clés cloud statiques par des jetons temporaires liés à l’environnement d’exécution.
- Comment gouverner les coûts cloud contre un compte compromisLa gouvernance des coûts cloud limite l'impact financier d'un compte compromis en complétant la détection, les identités et la réponse à incident.
Pages voisines
La citent
- Mettre en place la fédération d’identité de charge
- Auditer la couverture réelle du mTLS service mesh
- Chiffrer les flux est-ouest dans un data center
- Cloud IaaS, PaaS, SaaS et modèles de déploiement, qui sécurise quoi
- Cloud networking, VPC/VNet, CDN et équilibrage
- Comment auditer la responsabilité partagée cloud
- Comment gouverner les coûts cloud contre un compte compromis
- Gérer une crise cloud multi-tenant
- Isolation réseau multi-tenant avec VPC et NetworkPolicy
- Quotas cloud contre le déni de service par coût
- Réconcilier inventaire IaC et cloud réel
- Réduire RBAC Kubernetes et bloquer les pods dangereux
Détecter la persistance IAM dans AWS