
Écrire un Dockerfile durci avec condensé, multi-étapes et non root
Écrire un Dockerfile durci avec condensé, multi-étapes et non root
Section intitulée « Écrire un Dockerfile durci avec condensé, multi-étapes et non root »Un Dockerfile est du code qui s’exécute avec des droits élevés, télécharge des dépendances depuis Internet et fige le résultat dans un artefact copié partout. Ce guide part d’un Dockerfile naïf et le durcit instruction par instruction : FROM épinglé par condensé, construction multi-étapes, USER non root, secrets de construction, puis verrouillage en CI (Continuous Integration, intégration continue). La position défendue est nette : chaque mesure ne vaut que si un contrôle automatique empêche de revenir en arrière.
→ Lire l’explication complète de la marmotte
Prérequis : BuildKit, registre et outillage de contrôle
Section intitulée « Prérequis : BuildKit, registre et outillage de contrôle »Avant d’écrire la moindre ligne :
- BuildKit, le moteur de construction moderne de Docker, par défaut depuis Docker Engine 23.0. Les montages de secrets et les options de
RUNemployés ici n’existent pas dans l’ancien constructeur. - La directive
# syntax=docker/dockerfile:1en première ligne du fichier, qui fixe la version de la syntaxe indépendamment du moteur installé sur le runner. - Un registre d’images où pousser, et de préférence un miroir interne des images de base (voir les conditions d’exploitation plus bas).
- Un linter de Dockerfile (hadolint ici) et un analyseur de vulnérabilités d’image (Trivy ici), exécutables dans le pipeline.
- Un outil de mise à jour des dépendances capable de réécrire les condensés dans un
FROM(Renovate et Dependabot le font). - Une protection de branche qui rend les contrôles bloquants. Sans elle, le reste de la page est une suggestion.
Le choix de l’image de base elle-même (Debian, Alpine, distroless, généalogie des couches) relève de la page Images Docker de base et confiance héritée ; ce guide suppose le choix fait et s’occupe de l’écriture.
Dockerfile naïf : point de départ et inventaire des défauts
Section intitulée « Dockerfile naïf : point de départ et inventaire des défauts »Voici le fichier que tout dépôt a contenu un jour, pour un service écrit en Go qui dépend de modules privés :
FROM golang:latestADD . /srcWORKDIR /srcARG GIT_TOKENRUN git config --global url."https://ci:${GIT_TOKEN}@git.example.internal/".insteadOf "https://git.example.internal/"RUN go build -o /app ./cmd/appCMD ["/app"]Sept lignes, six défauts. latest désigne une image différente à chaque construction. ADD . embarque tout le répertoire, .git et fichiers .env compris. Le jeton passe par ARG, donc finit dans l’historique de l’image dès le RUN qui suit, et il est en prime écrit dans /root/.gitconfig, donc dans une couche. L’image finale contient le compilateur, git, un shell et un gestionnaire de paquets. Le processus tourne en root. Et rien ne vérifie quoi que ce soit.
Le compromis central du durcissement tient en une phrase : on gagne une image reproductible, petite et pauvre en outils pour un intrus ; on paie en maintenance (un condensé figé ne reçoit plus aucun correctif tout seul) et en confort de diagnostic (plus de shell dans l’image). Le marché est bon à deux conditions : la mise à jour des condensés est automatisée, et l’équipe sait diagnostiquer un conteneur sans y entrer. Si l’une manque, il faut la construire avant de durcir, pas après.
Image de base épinglée par condensé et mise à jour outillée
Section intitulée « Image de base épinglée par condensé et mise à jour outillée »Un tag est un pointeur mutable : le propriétaire du dépôt d’images (ou quiconque a compromis son compte) peut le faire pointer ailleurs sans que le Dockerfile change d’un octet. Un condensé (@sha256:…, l’empreinte cryptographique du manifeste) désigne un contenu et un seul. L’écriture retenue combine les deux : FROM golang:1.26-bookworm@sha256:…. Quand un condensé est présent, c’est lui qui fait foi ; le tag reste là pour les humains et pour l’outil de mise à jour.
Deux pièges. Le premier : pour une image multi-architecture, il existe un condensé pour l’index (la liste des variantes) et un par plateforme. Épingler celui de l’index conserve la résolution par architecture ; épingler celui d’une plateforme casse la construction sur les autres. La commande docker buildx imagetools inspect affiche celui de l’index.
Le second piège est le vrai sujet : un condensé épinglé à la main est une image de base qui ne sera plus jamais corrigée. Vingt ans de métier apprennent que « on le mettra à jour régulièrement » est une phrase qui précède de peu l’oubli. L’épinglage et le robot de mise à jour forment donc un tout : le robot ouvre une demande de fusion à chaque nouveau condensé du tag suivi, le pipeline reconstruit et analyse, un humain fusionne. Chaque changement de base devient un commit daté et réversible, ce qu’un tag flottant ne donnera jamais.
Construction multi-étapes et image finale minimale
Section intitulée « Construction multi-étapes et image finale minimale »Une construction multi-étapes déclare plusieurs FROM dans le même fichier. Chaque étape repart d’une image propre ; seul ce qui est explicitement copié par COPY --from= passe à la suivante. L’étape de compilation peut donc contenir tout l’outillage du monde, l’image finale n’en hérite pas.
Le schéma montre ce qui franchit la frontière entre les étapes, et surtout ce qui ne la franchit pas.
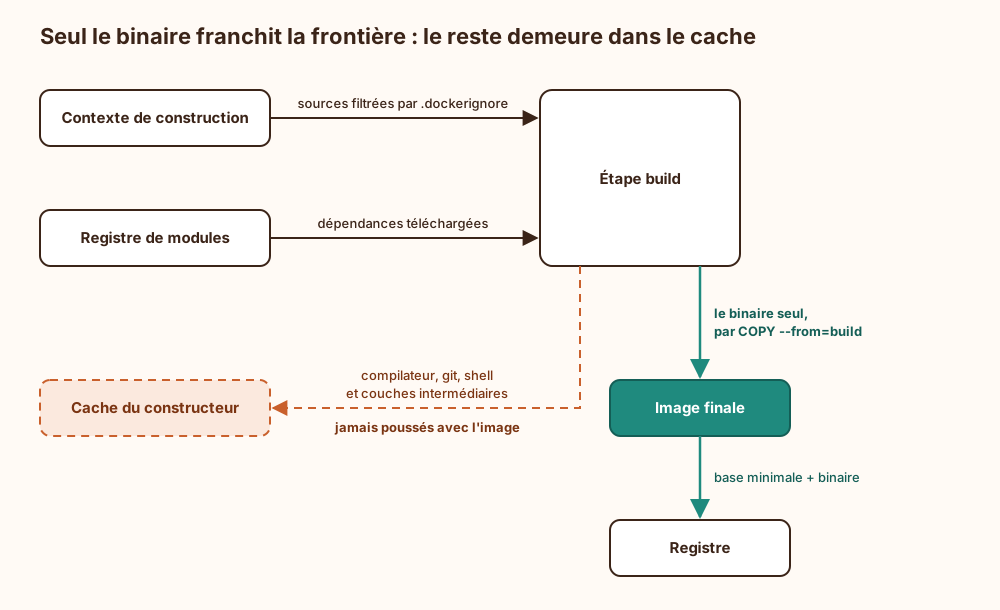
Pour l’image finale, la recommandation est une base distroless (image sans shell ni gestionnaire de paquets, réduite aux dépendances d’exécution) quand le langage le permet : binaire statique Go ou Rust sur la variante static, variantes dédiées pour Java, Python ou Node.js. Un intrus qui obtient une exécution de code n’y trouve ni sh, ni curl, ni de quoi installer la suite. Ce n’est pas une barrière absolue, c’est un travail supplémentaire imposé à l’attaquant, et un nombre de paquets vulnérables qui s’effondre dans les rapports d’analyse.
Le prix : docker exec ne sert plus à rien. Le diagnostic passe par les journaux, les métriques et, sous Kubernetes, par un conteneur éphémère attaché au pod (kubectl debug). Si l’application exige une bibliothèque C dynamique ou des paquets système, une base Debian slim reste un choix défendable ; la question qui tranche est « de quoi le processus a-t-il besoin à l’exécution », jamais « de quoi a-t-on besoin pour le dépanner ».
Secrets de construction : RUN —mount=type=secret contre ARG, ENV et COPY
Section intitulée « Secrets de construction : RUN —mount=type=secret contre ARG, ENV et COPY »Une image est une pile de couches immuables, accompagnée d’une configuration et d’un historique. Tout ce qu’une instruction écrit y reste, même si l’instruction suivante l’efface. Le schéma indique où finit un secret selon l’instruction employée.
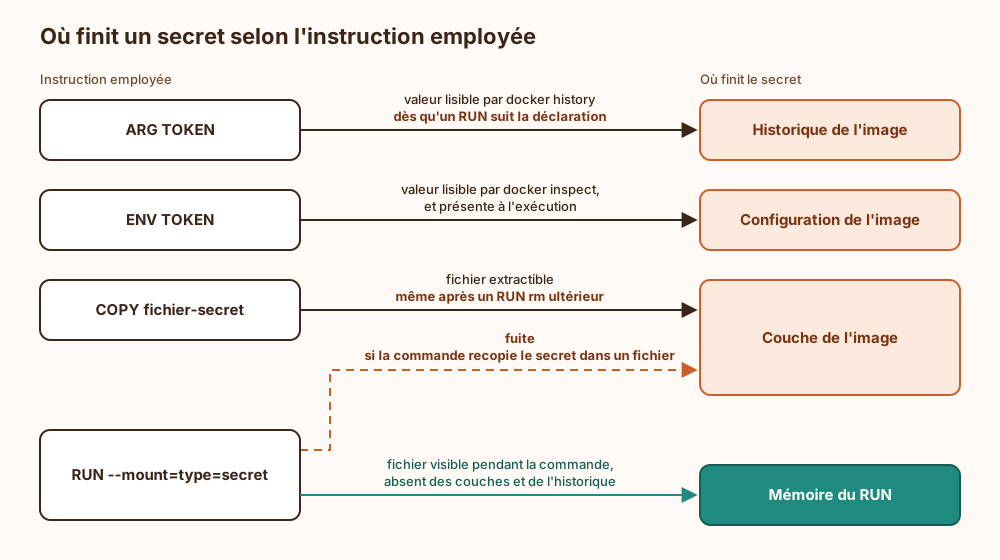
RUN --mount=type=secret,id=… monte le secret en mémoire, par défaut sous /run/secrets/<id>, pour la durée d’une seule commande. Il est fourni au moment de la construction (docker build --secret id=…,src=… pour un fichier, env=… pour une variable d’environnement) et n’entre ni dans les couches ni dans l’historique. Pour une clé SSH (Secure Shell), l’équivalent est --mount=type=ssh, qui relaie l’agent sans exposer la clé.
Ce que le montage ne garantit pas, et c’est la dernière ligne du schéma : si la commande écrit elle-même le secret quelque part (un git config avec le jeton dans l’URL, un .npmrc, un fichier de configuration de gestionnaire de paquets), le secret atterrit dans la couche. Le montage protège le transport, pas ce que l’outil en fait. La règle : monter le secret directement à l’emplacement où l’outil le lit (target=), et ne jamais le recopier.
Autre idée reçue à enterrer : « le secret est dans l’étape de build, donc il ne sort pas ». Il ne sort pas dans l’image finale, certes. Il reste dans le cache du constructeur, part avec lui si le cache est exporté vers un registre, et les attestations de provenance en mode complet consignent les arguments de construction. Un ARG n’est pas un canal pour un secret, quelle que soit l’étape.
Dernier détail : la valeur d’un secret monté n’entre pas dans la clé de cache. Changer de jeton ne relance donc pas l’étape ; c’est voulu, et c’est à savoir le jour d’une rotation. La fourniture du secret côté pipeline, elle, relève de la sécurisation des identifiants du pipeline CI/CD et d’un coffre-fort de secrets.
Utilisateur non root, UID numérique et système de fichiers en lecture seule
Section intitulée « Utilisateur non root, UID numérique et système de fichiers en lecture seule »Sans instruction USER, le processus tourne en root dans le conteneur. L’isolation limite ce que ce root peut faire, mais bien des failles d’évasion publiées commencent par « un processus root dans le conteneur peut… ». Autant ne pas offrir la prémisse.
USER se déclare avec un UID (User IDentifier, identifiant numérique d’utilisateur) et un groupe numériques : USER 65532:65532. Raison précise : Kubernetes, avec runAsNonRoot: true, refuse de démarrer un conteneur dont l’utilisateur est un nom, faute de pouvoir prouver qu’il ne correspond pas à l’UID 0. Un nom oblige aussi à faire confiance au fichier /etc/passwd de l’image ; un nombre, non.
Trois règles d’écriture vont avec :
- Le binaire et ses fichiers restent la propriété de root, en lecture et exécution seules pour l’utilisateur applicatif. Un
COPY --chownvers l’utilisateur du service lui donne le droit de réécrire son propre exécutable, soit l’inverse du but recherché. - L’application écoute sur un port non privilégié (1024 ou plus), ce qui évite de dépendre d’une capacité Linux ou d’un réglage du moteur d’exécution.
- L’application n’écrit rien dans son image. Les chemins d’écriture nécessaires (
/tmp, un répertoire de données) sont identifiés et documentés, pour être montés à l’exécution.
Ce dernier point prépare le système de fichiers racine en lecture seule, qui s’active à l’exécution (--read-only avec Docker, readOnlyRootFilesystem: true sous Kubernetes) et pas dans le Dockerfile. Le Dockerfile rend la mesure possible ; il ne l’applique pas. Une application qui écrit ses journaux dans son répertoire d’installation la rend impossible, et c’est en général à ce moment que le durcissement est « reporté à la prochaine version ».
.dockerignore, COPY plutôt que ADD et versions de paquets
Section intitulée « .dockerignore, COPY plutôt que ADD et versions de paquets ».dockerignore. Le contexte de construction (le répertoire transmis au constructeur) contient par défaut tout le dépôt. Un COPY . . y puise sans discernement : historique git, fichiers .env, clés de test, artefacts locaux. Le fichier .dockerignore filtre en amont. La forme la plus sûre est la liste d’autorisation : tout exclure (*), puis réadmettre ce qui sert (!go.mod, !go.sum, !cmd/, !internal/). Une liste d’exclusion oublie toujours le fichier créé la semaine suivante.
COPY plutôt que ADD. ADD fait deux choses en plus : il télécharge une URL (Uniform Resource Locator) et décompresse automatiquement une archive tar locale. Deux comportements implicites, deux surprises possibles. COPY copie, point. Si un téléchargement est indispensable, il se fait avec une empreinte vérifiée (ADD --checksum=sha256:… ou une vérification explicite dans le RUN), jamais à l’aveugle.
Versions de paquets. Fixer les versions (apt-get install -y --no-install-recommends paquet=version) rend la construction déterministe, et la rend cassante : les dépôts de distribution retirent les anciennes versions, la construction échoue alors sans qu’une ligne ait changé. Position : épinglage strict pour les dépendances applicatives, via les fichiers de verrouillage du langage (go.sum, package-lock.json, poetry.lock) ; pour les paquets système, l’image de base épinglée par condensé fait l’essentiel du travail, et le mieux reste d’en installer le moins possible, idéalement aucun dans l’image finale. --no-install-recommends est non négociable : les paquets « recommandés » sont la voie royale vers une image qui contient un serveur de courrier sans que personne sache pourquoi.
Exemple : Dockerfile durci et commandes de vérification
Section intitulée « Exemple : Dockerfile durci et commandes de vérification »Première étape, relever le condensé de l’index de chaque image de base :
# Le champ Digest affiché est celui à reporter après le @ dans le FROMdocker buildx imagetools inspect golang:1.26-bookwormdocker buildx imagetools inspect gcr.io/distroless/static-debian12:nonrootLe Dockerfile durci. Les deux condensés ci-dessous sont des valeurs d’illustration (ils changent à chaque republication du tag) : ceux relevés à l’instant les remplacent.
# syntax=docker/dockerfile:1
# --- Étape de compilation : outillage complet, jamais livrée ---FROM golang:1.26-bookworm@sha256:0123456789abcdef0123456789abcdef0123456789abcdef0123456789abcdef AS buildWORKDIR /src
# Modules privés : nom d'hôte non secret, sans jetonENV GOPRIVATE=git.example.internal/*
# Dépendances d'abord, pour profiter du cache de couchesCOPY go.mod go.sum ./
# Le fichier .netrc est monté là où git et go le lisent, le temps de ce RUNRUN --mount=type=secret,id=netrc,target=/root/.netrc \    go mod download
# Sources filtrées par .dockerignoreCOPY . .
# Compilation statique, sans accès réseau : tout est déjà téléchargéRUN --network=none CGO_ENABLED=0 \    go build -trimpath -o /out/app ./cmd/app
# --- Image finale : ni shell, ni gestionnaire de paquets ---FROM gcr.io/distroless/static-debian12:nonroot@sha256:fedcba9876543210fedcba9876543210fedcba9876543210fedcba9876543210COPY --from=build /out/app /appUSER 65532:65532ENTRYPOINT ["/app"]
Construction, puis vérifications :
# Le secret est fourni hors Dockerfile et hors argumentsdocker build --secret id=netrc,src=$HOME/.netrc \  -t registry.example.internal/app:1.4.2 .
# 1. Aucun jeton dans l'historique des couchesdocker history --no-trunc registry.example.internal/app:1.4.2
# 2. Utilisateur déclaré : attendu 65532:65532docker inspect --format '{{.Config.User}}' registry.example.internal/app:1.4.2
# 3. Le service démarre avec racine en lecture seule et sans capacitédocker run --rm --read-only --cap-drop=ALL \  --security-opt=no-new-privileges registry.example.internal/app:1.4.2
Le troisième test est le plus instructif : s’il échoue, l’application écrit quelque part ou réclame un privilège, et mieux vaut l’apprendre ici qu’au déploiement. L’option --network=none sur la compilation a un second effet : un script de construction qui tenterait de joindre l’extérieur échoue bruyamment.
Contrôle en CI : linter, analyse de vulnérabilités et refus de fusion
Section intitulée « Contrôle en CI : linter, analyse de vulnérabilités et refus de fusion »Un Dockerfile durci non contrôlé redevient naïf en trois demandes de fusion : quelqu’un rajoute un USER root « temporaire », un ADD d’archive, un tag sans condensé. Le durcissement se joue dans la chaîne ci-dessous, où chaque contrôle est bloquant.
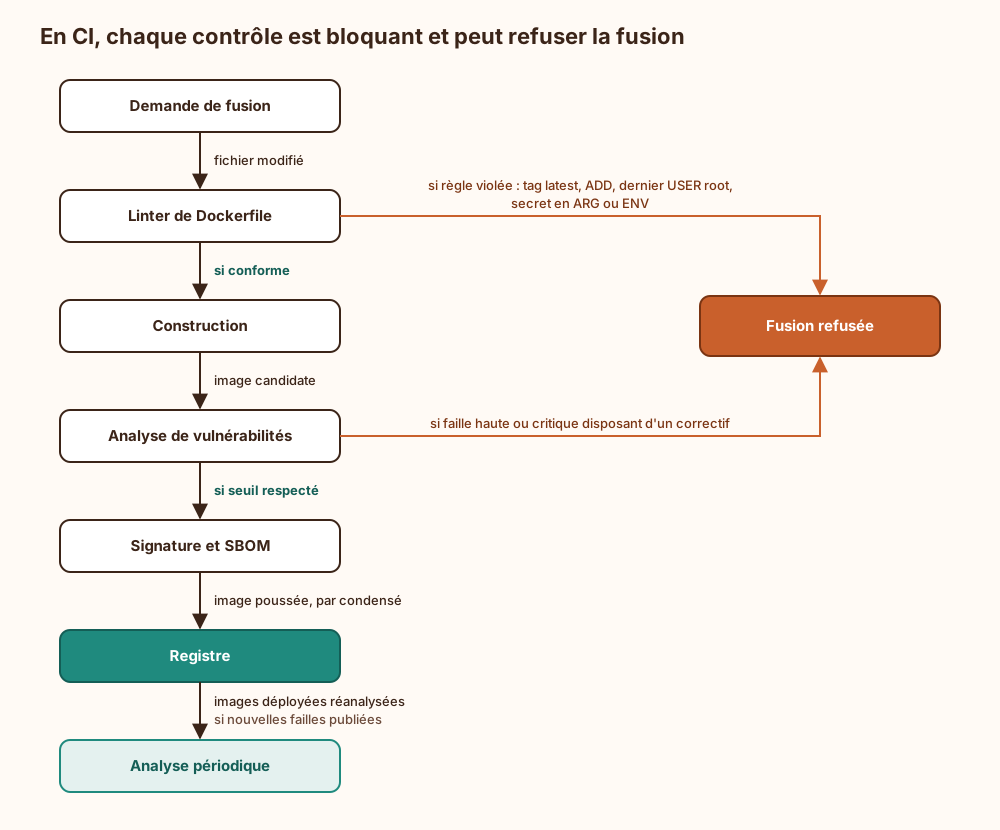
Les commandes correspondantes :
# Linter : échec à partir du niveau avertissementhadolint --failure-threshold warning Dockerfile
# Contrôles intégrés au constructeur, dont la détection de secrets en ARG/ENVdocker build --check .
# Analyse de l'image : code de retour non nul si faille haute ou critique corrigeabletrivy image --exit-code 1 --severity HIGH,CRITICAL --ignore-unfixed \  registry.example.internal/app:1.4.2
hadolint couvre directement plusieurs points de cette page : DL3007 (tag latest), DL3020 (ADD au lieu de COPY), DL3002 (dernier USER à root), DL3008 (paquets apt sans version). Cette dernière se désactive en connaissance de cause si la position prise plus haut sur les paquets système est retenue : une règle ignorée par écrit dans le fichier de configuration vaut mieux qu’un linter non bloquant.
Sur le seuil d’analyse, le choix de --ignore-unfixed est assumé : bloquer sur une CVE (Common Vulnerabilities and Exposures, identifiant public d’une faille) sans correctif disponible bloque l’équipe sans rien corriger, et apprend à tout le monde à contourner le contrôle. Les exceptions se consignent dans un fichier versionné (.trivyignore), avec une justification et une date de revue ; le traitement du reste relève de la gestion des vulnérabilités. La suite de la chaîne est décrite dans signer et vérifier les artefacts de build et générer un SBOM (Software Bill of Materials, inventaire des composants) dans le pipeline.
Surface d’attaque restante et limites du Dockerfile
Section intitulée « Surface d’attaque restante et limites du Dockerfile »Ce que le Dockerfile durci laisse ouvert, par ordre d’importance :
- La construction exécute du code tiers. Scripts d’installation de dépendances, greffons de compilation : tout cela tourne dans l’étape de build, avec le réseau et le secret monté à portée. Contre-mesures : secret monté sur la seule commande qui en a besoin, compilation sans réseau, jeton en lecture seule à durée de vie courte, runners éphémères.
- Le condensé garantit l’identité, pas l’innocuité. Une image de base malveillante épinglée reste malveillante, de façon parfaitement reproductible. L’épinglage protège contre la substitution ; la confiance dans l’éditeur vient d’ailleurs (provenance, signature, analyse).
- L’analyseur ne voit que ce qu’il sait inventorier : paquets du système, dépendances déclarées des langages. Un binaire téléchargé par
curldans unRUNlui est invisible. Raison de plus pour ne pas en télécharger. USERest une valeur par défaut. N’importe qui lance le conteneur avec--user 0ou un contexte de sécurité permissif. Le Dockerfile propose, la plateforme dispose.
Et ce qu’il ne règle pas du tout, parce que ce sont des options d’exécution : le retrait des capacités Linux (les fragments du pouvoir de root, à supprimer en bloc), le filtrage des appels système par seccomp (secure computing mode), l’interdiction d’élévation de privilèges (allowPrivilegeEscalation: false), la lecture seule effective, les limites de ressources, le cloisonnement réseau. Tout cela vit dans la configuration du moteur ou de l’orchestrateur : voir l’audit de durcissement d’un cluster Kubernetes, et l’isolation des conteneurs par namespaces et cgroups pour les mécanismes eux-mêmes. Un Dockerfile irréprochable lancé avec --privileged reste un conteneur privilégié avec un joli fichier.
Conditions d’exploitation : rotation, reconstruction et reprise
Section intitulée « Conditions d’exploitation : rotation, reconstruction et reprise »Secrets. Le jeton de construction est dédié à cet usage, en lecture seule, limité aux dépôts nécessaires. Sa rotation ne demande aucune reconstruction puisqu’il n’est dans aucune image. À l’inverse, un secret parti dans une couche poussée est compromis : supprimer le tag ne retire pas la couche des machines qui l’ont déjà tirée. La seule réponse est la révocation.
Reconstruction. Une image qui n’est pas reconstruite vieillit, même si son code ne bouge pas. Le rythme est donné par le robot de mise à jour des condensés ; pour les services au code stable, une reconstruction planifiée complète le dispositif.
Supervision. L’analyse au moment de la fusion ne dit rien des failles publiées ensuite. Les images réellement déployées sont réanalysées périodiquement, à partir de leur condensé ou de leur inventaire de composants, et les résultats alimentent le même circuit de traitement.
Sauvegarde et reprise. Un FROM épinglé dépend de la disponibilité de ce condensé précis chez l’éditeur. Un miroir interne des images de base, alimenté par le pipeline, supprime cette dépendance et permet de reconstruire à l’identique pendant une panne du registre amont. Le Dockerfile, le .dockerignore et la configuration des contrôles vivent dans le dépôt, donc dans ses sauvegardes ; le cache de construction, lui, est jetable par définition.
Faut-il épingler par condensé une image de base interne ?
Section intitulée « Faut-il épingler par condensé une image de base interne ? »Oui. L’argument « le registre est interne, donc de confiance » confond l’emplacement et l’intégrité : un tag interne est aussi mutable qu’un tag public, et une republication accidentelle change la base de tous les services qui en dépendent sans laisser de trace dans leurs dépôts.
Une image construite sur scratch vaut-elle mieux qu’une base distroless ?
Section intitulée « Une image construite sur scratch vaut-elle mieux qu’une base distroless ? »scratch (l’image vide) contient encore moins de choses, y compris ce qui manque vite : certificats racine, données de fuseaux horaires, entrée d’utilisateur non root. Tout se recopie depuis l’étape de build, à la main. La base distroless statique fournit ces éléments, maintenus par quelqu’un d’autre. Le choix dépend d’une question : qui met à jour les certificats racine ?
Le mode rootless du moteur dispense-t-il de l’instruction USER ?
Section intitulée « Le mode rootless du moteur dispense-t-il de l’instruction USER ? »Non, les deux mesures se cumulent. Le mode rootless (voir Docker ou Podman en auto-hébergement) limite ce qu’un root de conteneur devient sur l’hôte ; USER limite ce que le processus peut faire dans le conteneur. L’image, en outre, voyage : elle sera un jour lancée sur une plateforme qui ne l’est pas.
🐝 Ce qui arrive si on s’en passe
Section intitulée « 🐝 Ce qui arrive si on s’en passe »Sans condensé, le contenu déployé peut changer sans qu’aucun commit ne l’explique : l’historique du dépôt cesse d’être une source de vérité, et une régression ou une compromission de la base devient impossible à dater. Sans séparation des étapes, un intrus trouve dans le conteneur un compilateur, un client git et un shell, soit de quoi fabriquer ses outils sur place. Un jeton passé en argument devient lisible par toute identité autorisée à tirer l’image, ce qui transforme un droit de lecture sur le registre en droit de lecture sur les dépôts de code. Et sans contrôle bloquant, aucune de ces dérives ne déclenche d’alerte : elles s’installent par petites modifications, chacune raisonnable prise isolément.
🦫 Explication de la marmotte 🍫
Section intitulée « 🦫 Explication de la marmotte 🍫 »Un Dockerfile est un fichier texte qui décrit, ligne par ligne, comment fabriquer une image : un paquet contenant un programme et tout ce qu’il lui faut pour tourner. La fabrication part d’une image existante. La désigner par son nom ne suffit pas, car ce nom peut pointer demain vers un autre contenu ; on ajoute donc son empreinte, une suite de caractères calculée à partir du contenu, qui change dès qu’un seul octet change. Un robot propose ensuite la nouvelle empreinte à chaque correction publiée. La fabrication se fait en deux temps : une première image compile le programme avec tous les outils nécessaires, puis une seconde, presque vide, ne reçoit que le programme terminé. Les mots de passe utiles pendant la compilation sont prêtés le temps d’une seule commande et ne sont jamais enregistrés ; écrits autrement, ils restent lisibles par quiconque récupère l’image, même après effacement. Le programme est réglé pour démarrer avec un compte sans pouvoir d’administration et sans écrire dans son propre paquet. Enfin, à chaque modification proposée, des outils automatiques relisent le fichier et cherchent les failles connues dans l’image ; si un contrôle échoue, la modification est refusée. Certaines protections ne dépendent pas de ce fichier : elles se règlent au lancement du programme.
À lire aussi
- SBOM pour inventorier les composants réellement exécutésUne SBOM permet d’identifier les composants qui composent réellement un logiciel, à condition de la produire au bon endroit et de l’exploiter.
- Gérer les risques tiers et la chaîne logicielleCette page traite de la gestion des risques liés aux fournisseurs, dépendances et composants de la chaîne d'approvisionnement logicielle.
- Vérifier une chaîne de compilation reproductibleFondations de la compilation reproductible, des attaques de build et de la vérification moderne de la chaîne de compilation.
- L'attaque de la chaîne d'approvisionnement logicielle en une pageComment une dépendance piégée traverse le build, reçoit une signature valide et s'installe chez tous les clients, en cinq étapes animées, avec SolarWinds, xz-utils, event-stream et les parades qui coupent la chaîne.
Pages voisines
La citent
Écrire un Dockerfile durci avec condensé, multi-étapes et non root
Elle cite
- Lien dans les deux sens :Docker ou Podman en auto-hébergement : root, rootless, isolation
- Lien dans les deux sens :Images Docker de base et confiance héritée
- Déployer Vault ou OpenBao pour supprimer les secrets en clair
- Générer un SBOM CycloneDX dans un pipeline CI
- Sécuriser les identifiants CI/CD avec OIDC
- Signer et vérifier les artefacts de build
- Auditer et durcir un cluster Kubernetes avec kube-bench
- Mettre en place une gestion récurrente des vulnérabilités
- Attaques supply chain et protection des dépendances
- Isolation des conteneurs Docker : namespaces, cgroups et évasions
: les deux pages se citent l’une l’autre.