
Serveur web
Infrastructure
Logiciel (et, par extension, machine qui l'héberge) qui écoute les requêtes HTTP ou HTTPS des clients et leur renvoie des ressources : pages, fichiers statiques, réponses d'API. Il sert le contenu lui-même ou relaie la demande vers une application placée derrière lui.
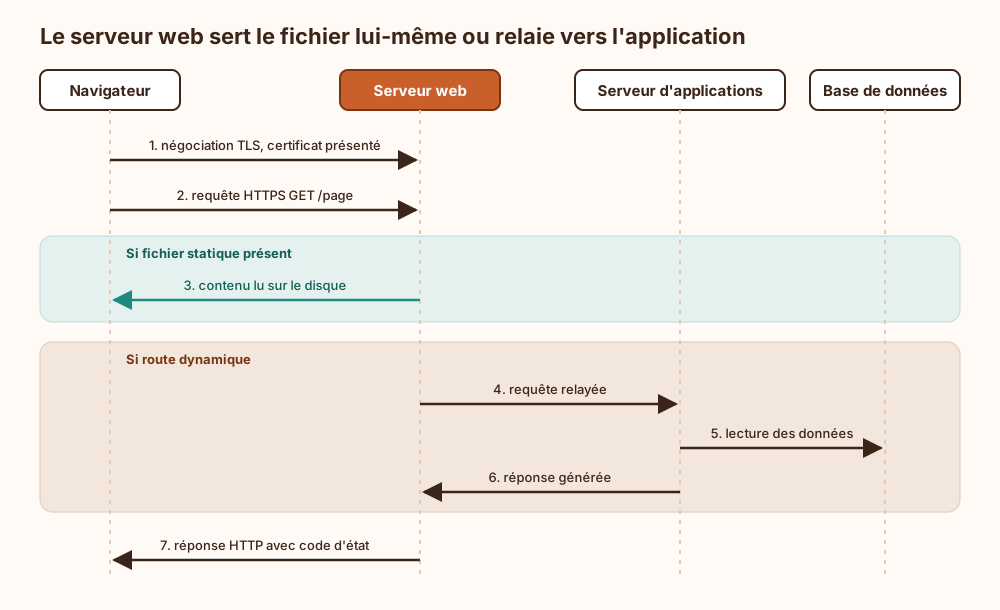
Statique ou dynamique : Pour un fichier présent sur le disque (HTML, image, script), le serveur web le lit et le renvoie tel quel. Pour une page calculée à la volée, il transmet la requête à un serveur d'applications (via proxy inverse ou FastCGI) et se contente de relayer la réponse.
Terminaison TLS : Il porte en général le certificat, négocie le chiffrement et déchiffre le trafic HTTPS avant de le traiter ou de le transmettre. Derrière lui, la requête repart souvent en clair vers l'application : le chiffrement s'arrête donc exactement là où commence la confiance accordée au réseau interne, laquelle ne se vérifie jamais.
Logiciels courants : NGINX, Apache httpd, Caddy et IIS dominent le terrain. Ils écoutent par convention sur le port 80 (HTTP) et le port 443 (HTTPS), et la page d'accueil qui félicite l'administrateur d'une installation réussie reste le signe le plus fiable qu'elle n'est pas terminée.
À ne pas confondre : Le serveur web gère les connexions, le routage des URL, la compression et le cache. La logique métier vit dans le serveur d'applications, même quand les deux tournent dans le même processus.
Ce qui arrive si on s'en passe
Sans serveur web en écoute, aucune requête HTTP ou HTTPS n'obtient de réponse : la connexion vers le port 80 ou 443 est refusée ou expire, les pages, fichiers statiques et réponses d'API deviennent inaccessibles, et aucun journal d'accès ne consigne ces tentatives. Le contournement habituel consiste à exposer directement l'application. Elle doit alors assurer seule ce que le serveur placé devant elle prend normalement en charge : terminaison TLS, limites de taille des requêtes, délais d'attente face aux clients lents, service des fichiers statiques et journalisation des accès. Les serveurs de développement intégrés aux frameworks (Flask, Django) sont explicitement documentés comme inadaptés à la production. Les placer en première ligne revient à les confronter à des connexions qu'ils n'ont pas été conçus pour filtrer.
Explication de la marmotte
Quand tu tapes l'adresse d'un site, ton téléphone envoie une demande à un ordinateur allumé jour et nuit, quelque part dans le monde. Sur cet ordinateur tourne un programme qui joue le rôle d'un guichetier de bibliothèque. Il reçoit ta demande et va chercher la bonne page dans ses rayons. Si la page dépend de toi (ton profil, ton panier), il demande à un collègue de la préparer. Ensuite, il te la renvoie, et l'application qui t'affiche les sites n'a plus qu'à la montrer à l'écran. Des milliers de personnes peuvent demander en même temps : le guichetier les sert toutes, très vite, sans jamais prendre de pause.
Où ce terme est utilisé
- Shellshock CVE-2014-6271 : exécution de code via l'environnement Bash (5 occurrences)
- TA0003 Persistance : rester quand tout est redémarré (4 occurrences)
- Comprendre pourquoi les systèmes communiquent (3 occurrences)
- Filtrage, segmentation, NAC et Zero Trust (3 occurrences)
- TA0002 Exécution : faire tourner son code chez quelqu'un d'autre (3 occurrences)
- Upload de shell PHP déguisé en image dans un CMS (3 occurrences)
- CWE-434 : téléversement d'un fichier de type dangereux (2 occurrences)
- Le moindre privilège pour une machine qui improvise (2 occurrences)
- Nmap pour cartographier un réseau, des hôtes aux services exposés (2 occurrences)
- Requête d'autorisation poussée et signée (PAR, JAR) (2 occurrences)