
Prioriser les vulnérabilités avec CVSS 4.0, EPSS, KEV et exposition
Prioriser les vulnérabilités avec CVSS 4.0, EPSS, KEV et exposition
Section intitulée « Prioriser les vulnérabilités avec CVSS 4.0, EPSS, KEV et exposition »Un scanner remonte des milliers de failles, et la capacité de correction en absorbe quelques dizaines par cycle. Trois signaux publics prétendent aider à choisir : CVSS (Common Vulnerability Scoring System), EPSS (Exploit Prediction Scoring System) et le catalogue KEV (Known Exploited Vulnerabilities). Aucun ne mesure un risque. Cette page dit ce que chacun mesure, ce qu’il ignore, et dans quel ordre les croiser avec l’exposition réelle.
→ Lire l’explication complète de la marmotte
Le compromis central : trier par score CVSS ou trier par exploitation et exposition
Section intitulée « Le compromis central : trier par score CVSS ou trier par exploitation et exposition »Trier par score brut coûte peu : un nombre, un seuil, un tableau de bord, et un auditeur content. Le prix se paie ailleurs. Le tri par score se trompe dans les deux sens : il mobilise des équipes sur des failles « critiques » que personne n’exploite et qui ne sont pas atteignables, et il laisse dormir des failles « moyennes » activement utilisées pour passer d’un poste compromis à un domaine entier.
Trier par croisement de signaux donne le bon ordre, mais exige ce que le score permettait d’éviter : un inventaire qui sait ce qui est exposé, une notion de criticité des actifs, et des flux rafraîchis chaque jour. La position défendue ici :
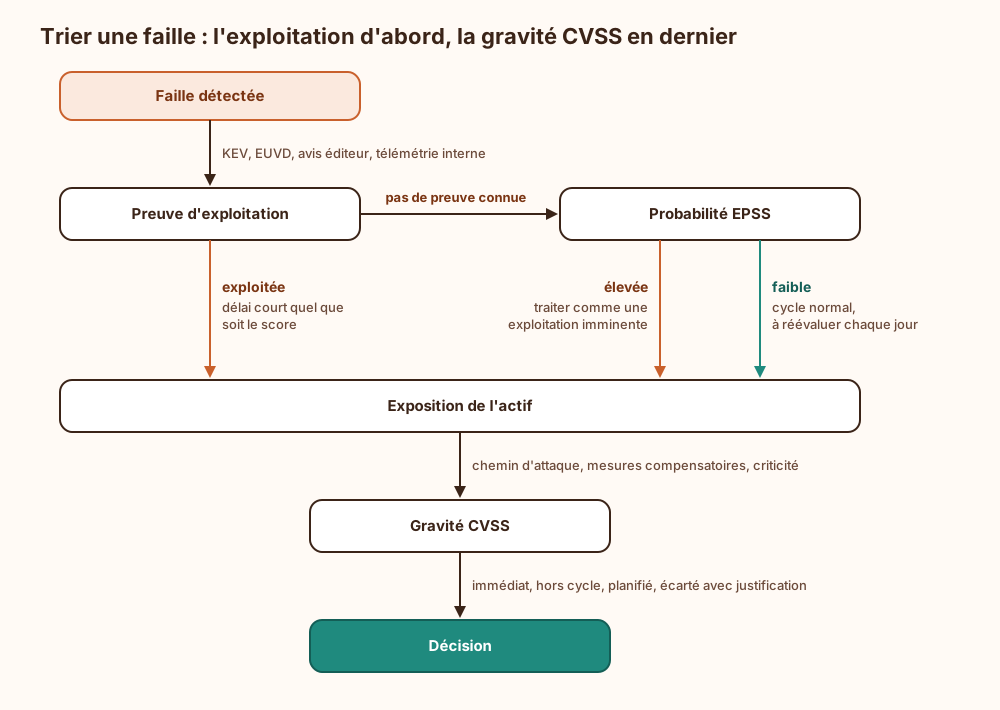
- La preuve d’exploitation décide en premier (KEV, base européenne, avis d’éditeur, télémétrie interne).
- L’exposition réelle de l’actif décide en second.
- EPSS départage ce qui reste.
- Le score CVSS de base arrive en dernier, comme description de l’impact, pas comme ordre de passage.
Condition de validité : sans inventaire fiable de l’exposition, ce classement retombe sur les deux signaux globaux (exploitation avérée, puis EPSS). Cela reste meilleur que le score seul, et c’est le signe que le premier chantier est l’inventaire, pas l’outil de scoring.
Le schéma ci-dessous montre l’ordre des questions, et non une formule : chaque signal répond à une question différente.
CVSS 4.0 : une gravité intrinsèque, pas un risque
Section intitulée « CVSS 4.0 : une gravité intrinsèque, pas un risque »CVSS 4.0 a été publié en novembre 2023 par FIRST (Forum of Incident Response and Security Teams). La spécification découpe l’évaluation en quatre groupes de métriques, et c’est ce découpage qu’il faut retenir avant le chiffre.
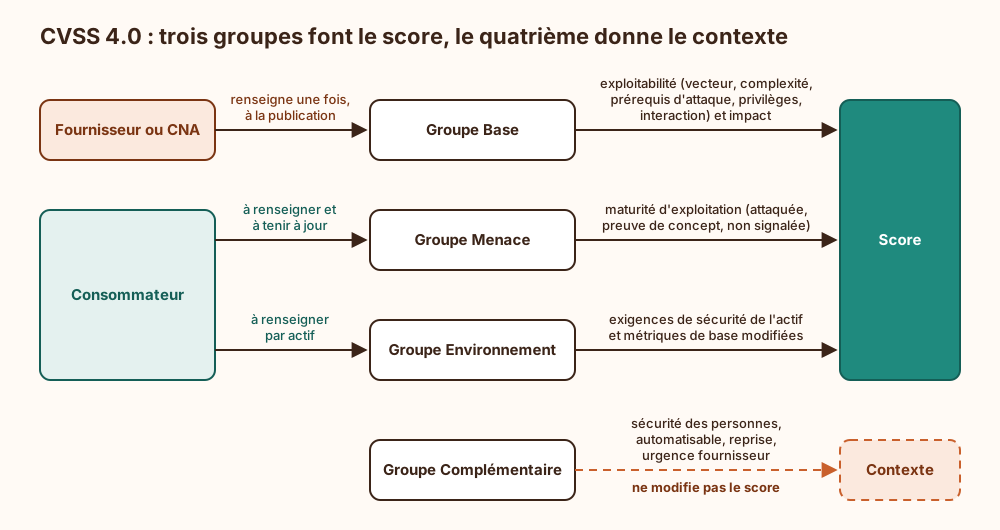
Lecture du schéma : seul le groupe Base est rempli par celui qui publie. Les deux groupes qui transforment une gravité en quelque chose d’approchant un risque sont à la charge de celui qui exploite le parc.
La norme impose d’ailleurs de nommer ce qu’on affiche : CVSS-B (base seule), CVSS-BT (base et menace), CVSS-BE (base et environnement), CVSS-BTE (les trois). Le score lu dans un avis, une base publique ou un rapport de scan est presque toujours un CVSS-B. C’est la gravité théorique maximale de la faille, sur n’importe quel système, dans le pire contexte.
Ce qui change depuis la version 3.1
Section intitulée « Ce qui change depuis la version 3.1 »- Attack Requirements (prérequis d’attaque) : nouvelle métrique, séparée de la complexité d’attaque. La complexité décrit les défenses à contourner ; les prérequis décrivent les conditions de déploiement hors du contrôle de l’attaquant (condition de course, position d’intercepteur).
- Interaction utilisateur à trois valeurs : aucune, passive (la victime fait ce qu’elle fait d’habitude), active (la victime doit accomplir un geste précis et inhabituel).
- Disparition de Scope, remplacée par deux jeux d’impact, chacun en confidentialité, intégrité et disponibilité : sur le système vulnérable et sur les systèmes suivants. Un impact sur l’hôte depuis un conteneur se lit désormais sans gymnastique.
- Groupe Menace réduit à une seule métrique, Exploit Maturity (maturité d’exploitation) : attaquée, preuve de concept, non signalée. Les anciennes métriques temporelles de niveau de correctif et de confiance dans le rapport ont disparu.
- Groupe Complémentaire : six métriques (dont Automatable et Safety) qui informent sans toucher au score.
- Calcul : plus de formule arithmétique, mais des classes d’équivalence de vecteurs classées par des experts, avec interpolation. Conséquence pratique : un score 3.1 et un score 4.0 de la même faille ne sont pas comparables, et un seuil hérité de la 3.1 ne se transpose pas tel quel.
Détail qui change la lecture : quand la maturité d’exploitation n’est pas renseignée, la norme suppose le pire, soit « attaquée ». Un CVSS-B est donc numériquement un CVSS-BT qui considère la faille comme exploitée. Renseigner cette métrique ne peut que baisser le score, jamais le monter. Du point de vue de la menace, le score de base n’est pas une estimation prudente, c’est un plafond. Seules les métriques d’environnement peuvent le dépasser, par exemple quand un service noté pour un réseau adjacent se trouve en réalité routé depuis Internet.
Ce que CVSS ne mesure pas
Section intitulée « Ce que CVSS ne mesure pas »- La probabilité d’exploitation. Deux failles à 9,8 peuvent différer de plusieurs ordres de grandeur sur ce point.
- L’exposition réelle. Le vecteur « réseau » dit que l’attaque est possible à distance, pas que le service est joignable depuis Internet.
- La valeur de l’actif. Sauf à remplir les exigences de sécurité du groupe Environnement, ce que presque personne ne fait à l’échelle.
- Le chaînage. CVSS note une faille isolée. Une élévation de privilèges locale notée « moyenne » devient la seconde moitié d’une compromission complète dès qu’un accès initial par ingénierie sociale a réussi.
Les comités de pilotage l’apprennent vite : un nombre avec une décimale finit toujours par être pris pour une mesure. Celui-ci est une échelle ordinale habillée en chiffre.
EPSS : une probabilité d’exploitation observée, pas une prédiction locale
Section intitulée « EPSS : une probabilité d’exploitation observée, pas une prédiction locale »EPSS, également porté par FIRST, estime la probabilité qu’une faille dotée d’un identifiant CVE (Common Vulnerabilities and Exposures) fasse l’objet d’une activité d’exploitation observée dans les 30 jours suivants. Le modèle est statistique, entraîné sur des observations fournies par des partenaires (capteurs réseau, pots de miel, détections), et les scores sont recalculés chaque jour pour l’ensemble des CVE publiées.
Deux valeurs sont publiées, et les confondre fausse tout le reste :
- la probabilité, entre 0 et 1 ;
- le centile, soit la part des CVE dont le score est inférieur ou égal.
La distribution est très déséquilibrée : l’immense majorité des CVE a une probabilité proche de zéro. Une probabilité d’apparence modeste place donc déjà dans les centiles hauts. Un seuil se fixe sur l’une ou l’autre, en le sachant, et il se documente.
Limites à garder en tête :
- Ce n’est pas un risque. EPSS ignore l’impact et ignore totalement le parc de celui qui le consulte.
- Le modèle voit ce que ses capteurs voient. L’exploitation de masse, bruyante, y est bien représentée ; une attaque ciblée ou une faille dans un équipement de niche lui échappe en grande partie.
- Une faille toute neuve est mal notée. Le score existe vite, mais repose sur peu de signaux et peut bondir en quelques jours. D’où la réévaluation quotidienne, et non un calcul unique à la détection.
- Les versions du modèle ne sont pas comparables. Un changement de version majeure déplace les scores ; un historique qui mélange les versions raconte n’importe quoi.
- La preuve prime sur la prédiction. FIRST le dit lui-même : une exploitation avérée, d’où qu’elle vienne, rend le score EPSS sans objet pour cette faille.
EPSS est le meilleur outil disponible pour une tâche précise : ordonner la masse des failles sans exploitation connue. L’utiliser pour autre chose, c’est demander à la météo nationale s’il pleut dans la salle serveur.
Catalogue KEV de la CISA et base EUVD : la preuve d’exploitation
Section intitulée « Catalogue KEV de la CISA et base EUVD : la preuve d’exploitation »Le catalogue KEV est tenu par la CISA (Cybersecurity and Infrastructure Security Agency), l’agence américaine de cybersécurité. Il découle de la BOD 22-01 (Binding Operational Directive), directive contraignante publiée en novembre 2021. Une faille y entre si trois critères sont réunis :
- un identifiant CVE attribué ;
- une preuve fiable d’exploitation active (un balayage, une recherche de sécurité ou une preuve de concept publique ne comptent pas) ;
- une action de remédiation définie : correctif, mesure de contournement ou retrait du produit.
La directive oblige les agences civiles fédérales américaines à corriger avant l’échéance inscrite sur chaque entrée : deux semaines par défaut pour les CVE attribuées à partir de 2021, six mois pour les plus anciennes, la CISA ajustant l’échéance entrée par entrée. Hors de ce périmètre, rien n’est obligatoire, mais le catalogue reste la liste publique la plus exploitable. Chaque entrée porte un champ knownRansomwareCampaignUse (valeurs Known ou Unknown) qui signale un usage connu par des opérateurs de rançongiciel, signal à relier au marché des accès et des exploits.
Les limites sont structurelles :
- L’absence du catalogue ne vaut pas absence d’exploitation. Pas de CVE, pas d’entrée. Pas de remédiation définie, pas d’entrée. Pas de preuve parvenue à la CISA, pas d’entrée.
- Le catalogue arrive après l’exploitation, par construction.
- Le biais de périmètre est assumé : le catalogue sert d’abord les réseaux fédéraux américains. Un produit surtout déployé en Europe y est mécaniquement moins représenté.
Unknownne veut pas dire « non » pour l’usage par rançongiciel.
Côté européen, l’ENISA (Agence de l’Union européenne pour la cybersécurité) exploite l’EUVD (European Union Vulnerability Database), prévue par la directive NIS2 et ouverte en 2025. Elle agrège plusieurs sources, attribue ses propres identifiants et propose une vue dédiée aux vulnérabilités exploitées. Elle se consomme en complément de KEV, pas en remplacement. Les organismes cités ont chacun leur fiche : FIRST, la CISA, l’ENISA, le NIST et MITRE, qui tient le programme CVE. Deux autres sources de preuve valent autant : les avis des éditeurs, et la télémétrie interne. Une tentative d’exploitation vue dans ses propres journaux est la meilleure donnée de menace qui existe, et elle ne figure dans aucun catalogue.
Contexte d’exposition : métriques d’environnement, SSVC et VEX
Section intitulée « Contexte d’exposition : métriques d’environnement, SSVC et VEX »Les signaux précédents sont globaux. Le contexte d’exposition est le seul signal local, donc le seul que personne ne fournira. Il tient en quatre questions par actif :
- Joignabilité. Service exposé à Internet, à un réseau partenaire, au réseau interne, à un réseau d’administration isolé ? La mesure de l’exposition publique se vérifie de l’extérieur, pas dans le schéma d’architecture.
- Chemin d’attaque. Combien de frontières à franchir, et lesquelles sont réellement filtrantes ? Voir la page sur le mouvement latéral et la segmentation.
- Mesures compensatoires. Filtrage, authentification en amont, fonctionnalité désactivée. Une mesure compensatoire non vérifiée est une hypothèse, pas une mesure.
- Criticité. Ce que l’actif détient ou permet d’atteindre (annuaire, hyperviseur, sauvegardes, chaîne de déploiement).
CVSS 4.0 sait encoder cela : les métriques de base modifiées (ramener le vecteur d’attaque à « adjacent » ou « local » pour un service non routé) et les exigences de sécurité produisent un CVSS-BE ou un CVSS-BTE. C’est rigoureux, et rarement tenable à la main sur un parc entier : un vecteur par couple faille et actif.
D’où l’intérêt de SSVC (Stakeholder-Specific Vulnerability Categorization), conçu par le CERT/CC (CERT Coordination Center) et repris par la CISA. SSVC ne produit pas de score mais une décision, au bout d’un arbre dont chaque nœud est une question à réponse discrète. La variante de la CISA enchaîne état d’exploitation (aucune, preuve de concept, active), caractère automatisable, impact technique, puis impact sur la mission et le bien-être public, et aboutit à quatre issues : Track, Track*, Attend, Act. La variante du CERT/CC pour les exploitants remplace une partie de ces nœuds par l’exposition du système (réduite, contrôlée, ouverte) et aboutit à : différer, planifier, hors cycle, immédiat.
Le choix entre score composite et arbre dépend d’une question : faut-il expliquer la décision à quelqu’un ? Un score pondéré maison ne s’explique pas (pourquoi 0,4 pour EPSS ?). Un arbre se lit, se conteste et se corrige nœud par nœud. Recommandation : l’arbre.
Dernier outil, VEX (Vulnerability Exploitability eXchange) : une déclaration, émise par un fournisseur ou une équipe interne, indiquant qu’un produit est not_affected, affected, fixed ou under_investigation pour une faille donnée, avec justification (par exemple, code vulnérable absent du chemin d’exécution). C’est ce qui permet d’écarter proprement le bruit des dépendances embarquées. Le versant inventaire est traité dans la page sur le SBOM (Software Bill of Materials) et ce qui tourne vraiment, le versant éditeur dans celle sur le PSIRT et la divulgation coordonnée.
Exemple chiffré : cinq failles fictives triées par score puis par croisement
Section intitulée « Exemple chiffré : cinq failles fictives triées par score puis par croisement »Les cinq failles ci-dessous sont fictives, identifiants et valeurs compris. Elles servent uniquement à montrer que l’ordre change.
| Faille | Actif | CVSS-B | EPSS | Exploitation avérée | Exposition |
|---|---|---|---|---|---|
| F-1 | Bibliothèque d’image dans un traitement par lots | 9,8 | 0,02 | Non | Interne, VEX not_affected |
| F-2 | Console d’administration d’hyperviseur | 9,1 | 0,04 | Non | Réseau d’administration isolé |
| F-3 | Passerelle d’accès distant | 8,8 | 0,91 | Oui, rançongiciel Known | Internet |
| F-4 | Serveur web frontal | 7,5 | 0,62 | Non | Internet |
| F-5 | Élévation de privilèges locale, postes de travail | 6,5 | 0,35 | Oui | Tous les postes |
Tri par score brut : F-1, F-2, F-3, F-4, F-5. La faille exploitée par des rançongiciels sur un équipement exposé passe en troisième position, derrière une bibliothèque dont le code vulnérable n’est jamais appelé.
L’arbre appliqué est le suivant.
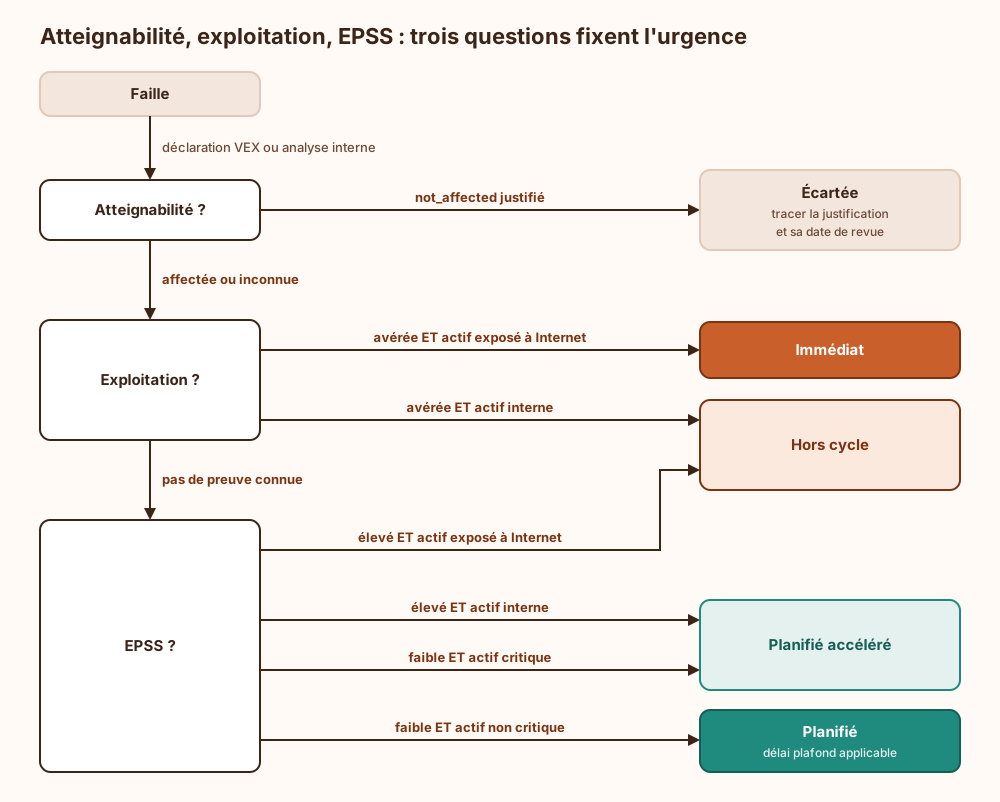
Résultat : F-3 en immédiat. F-5 hors cycle, parce qu’une élévation locale exploitée est le maillon qui transforme un poste hameçonné en compromission du domaine. F-4 hors cycle également, sans preuve mais avec une probabilité élevée et une exposition totale. F-2 en planifié accéléré : rien n’indique une exploitation, le réseau est isolé, mais un hyperviseur ne se laisse pas traîner. F-1 écartée, avec sa justification conservée.
Ordre final : F-3, F-5, F-4, F-2, F-1. La première du tri par score finit dernière. Le mode opératoire complet relève de deux guides : mettre en place une gestion récurrente des vulnérabilités pour l’inventaire, le scanner et les délais, et le patch management d’un parc hétérogène pour les fenêtres de correctifs. Cette page n’en approfondit que la décision.
Limites des sources : retards de la NVD et scores divergents
Section intitulée « Limites des sources : retards de la NVD et scores divergents »La NVD (National Vulnerability Database) du NIST (National Institute of Standards and Technology) enrichit les enregistrements CVE avec un score, une catégorie de faiblesse et les produits affectés. Depuis 2024, cet enrichissement accuse des retards : des CVE restent longtemps sans score ni liste de produits. Un outil qui apparie les failles au parc par ces listes de produits ne voit pas ce qui n’a pas été enrichi. « Pas de score » ne signifie pas « pas grave », et « pas de correspondance » ne signifie pas « pas concerné ».
Autre piège : pour une même CVE, le score de la CNA (CVE Numbering Authority, souvent l’éditeur) et celui de la NVD divergent régulièrement. L’éditeur connaît son produit et a un intérêt à ne pas noircir le tableau ; la NVD note sans contexte et retient le pire quand l’information manque. Règle à fixer une fois : quelle source fait foi, et que faire en cas d’écart (retenir le plus élevé tant qu’aucune analyse ne tranche). La CISA publie en outre, dans les enregistrements CVE, un enrichissement comprenant des points de décision SSVC, qui compense une partie du retard.
Prérequis, surface d’attaque et exploitation de la chaîne de priorisation
Section intitulée « Prérequis, surface d’attaque et exploitation de la chaîne de priorisation »Prérequis. Un inventaire où chaque actif porte un attribut d’exposition et une criticité, tenus à jour par la source qui fait autorité (règles de pare-feu, publication de services), pas saisis à la main une fois. Des identifiants de composants qui permettent l’appariement avec les CVE. Les flux consommés en version nommée : CVSS (3.1 ou 4.0, sans mélange), version du modèle EPSS, date du catalogue KEV.
Surface d’attaque du mécanisme. La priorisation est elle-même une cible, ou au moins un point de défaillance :
- Attribut d’exposition périmé. Un service déclaré interne puis publié par une règle temporaire reste classé « planifié ». Contre-mesure : recalcul de l’exposition depuis la configuration réelle et balayage externe régulier.
- VEX complaisant ou erroné. Un
not_affectedfournisseur retire une faille du tri sans autre contrôle. Contre-mesure : exiger la justification, vérifier l’origine et la signature du document, revoir à chaque nouvelle version. Le sujet rejoint celui des attaques sur la chaîne d’approvisionnement. - Fenêtre laissée par la dépriorisation. Tout ce qui est classé « planifié » reste exploitable pendant le délai, et l’exploitation de failles déjà publiées va plus vite que la plupart des cycles de correctifs. Contre-mesure : un délai plafond pour toutes les classes, et une détection sur les actifs en attente.
- Flux gelé. Une synchronisation en panne ne fait aucun bruit : les scores restent affichés, simplement faux.
Ce que la priorisation ne garantit pas. Elle ne voit ni les failles sans CVE, ni les défauts de configuration, ni les secrets exposés, ni les actifs absents de l’inventaire. Elle ne corrige rien. Elle ordonne une file d’attente ; la détection et la segmentation couvrent ce qui attend dans la file.
Conditions d’exploitation. Rafraîchir EPSS et KEV chaque jour et réévaluer tout le stock ouvert, pas seulement les nouvelles détections : une faille connue depuis deux ans peut entrer au catalogue demain matin. Alerter sur l’âge des flux. Journaliser chaque décision avec les valeurs des signaux au moment où elle a été prise, sinon aucune revue a posteriori n’est possible. Prévoir le mode dégradé : flux indisponible, retour à la preuve d’exploitation connue et à l’exposition. Garder le nombre de failles classées « immédiat » assez bas pour que le mot conserve un sens, faute de quoi la file reproduit la fatigue d’alerte sous un autre nom.
🐝 Ce qui arrive si on s’en passe
Section intitulée « 🐝 Ce qui arrive si on s’en passe »Sans croisement des signaux, la file de correction se remplit dans l’ordre du score de base. La capacité de correctifs part sur des failles théoriquement graves mais inatteignables, et les fenêtres de maintenance sont consommées avant que les failles réellement exploitées n’arrivent en tête. Les failles de gravité moyenne utilisées pour élever des privilèges restent ouvertes pendant des cycles entiers, puisque aucun seuil ne les fait remonter. L’entrée d’une faille ancienne dans un catalogue d’exploitation ne déclenche rien, faute de réévaluation du stock. Les exceptions s’accumulent sans justification datée, donc sans revue possible. Enfin, après un incident, personne ne peut reconstituer pourquoi la faille en cause attendait : la décision n’a jamais été prise, seulement héritée d’un chiffre.
🦫 Explication de la marmotte 🍫
Section intitulée « 🦫 Explication de la marmotte 🍫 »Un parc informatique contient en permanence des milliers de défauts connus, et les équipes ne peuvent en corriger qu’une petite partie à la fois. Il faut donc choisir un ordre. La première information disponible est une note de gravité, de 0 à 10, donnée par celui qui publie le défaut. Cette note décrit le pire dégât possible en théorie. Elle ne dit pas si quelqu’un attaque vraiment, ni si la machine concernée est joignable. La deuxième information est une probabilité, recalculée chaque jour, que le défaut soit attaqué dans le mois qui vient ; elle repose sur ce que des capteurs observent dans le monde, donc elle rate les attaques discrètes. La troisième est une liste officielle de défauts dont l’utilisation par des attaquants est prouvée ; un défaut absent de la liste peut quand même être utilisé. La quatrième information ne vient de personne d’autre : il faut savoir soi-même quelles machines sont accessibles depuis Internet et lesquelles comptent le plus. La méthode consiste à regarder d’abord la preuve d’attaque, puis l’accessibilité, puis la probabilité, et seulement ensuite la note. Si l’inventaire des machines est faux ou si les informations ne sont plus mises à jour, l’ordre obtenu est faux, sans que rien ne le signale.
À lire aussi
- Comment les attaquants utilisent l'IA : de la CVE au zero-dayCe que l'intelligence artificielle apporte réellement aux attaquants d'après les rapports publiés par OpenAI, Anthropic, Google et Microsoft, l'accélération de l'exploitation des vulnérabilités publiées, la recherche de zero-days assistée par IA et ce que les défenseurs doivent changer.
- WannaCry et MS17-010 : fenêtre d'exposition et correctifsWannaCry, EternalBlue et MS17-010 montrent comment les deux mois entre un correctif publié et un correctif déployé deviennent la fenêtre d'exposition d'un parc Windows.
- Partager le renseignement sur la menace avec ISAC, MISP et STIXAvec qui partager le renseignement sur la menace, par quel canal (ISAC, MISP, STIX et TAXII), sous quelles règles TLP et PAP, et ce qu'on retire d'un événement avant envoi pour ne pas s'exposer.
- Monter un CSIRT interne, missions, services FIRST et rattachementComment monter un CSIRT interne, du mandat au catalogue de services du cadre FIRST, avec son rattachement, son astreinte et sa coopération avec le CERT-FR et les CSIRT sectoriels.
Pages voisines
Prioriser les vulnérabilités avec CVSS 4.0, EPSS, KEV et exposition
Elle cite
- Lien dans les deux sens :Courtiers d'accès initial et marché des zero-day, détecter en amont
- Lien dans les deux sens :CISA
- Lien dans les deux sens :Mettre en place une gestion récurrente des vulnérabilités
- Lien dans les deux sens :MITRE ATT&CK et CVE en cybersécurité
- Lien dans les deux sens :Patch management d’un parc de postes hétérogène
- Lien dans les deux sens :PSIRT et divulgation coordonnée des vulnérabilités produit sous CRA
- OSINT défensif : mesurer et réduire l'exposition publique
- Attaques supply chain et protection des dépendances
- Comment contrer le spear phishing et la fraude au président
- Comment limiter le mouvement latéral après compromission
- Ransomware-as-a-Service et double extorsion
- Réduire la fatigue d’alerte dans un SOC
: les deux pages se citent l’une l’autre.