
Réponse à incident NIST SP 800-61r3, cycle complet et architecture
Réponse à incident NIST SP 800-61r3, cycle complet et architecture
Section intitulée « Réponse à incident NIST SP 800-61r3, cycle complet et architecture »La réponse à incident se joue pour l’essentiel avant l’incident : le jour venu, on ne dispose que des journaux déjà collectés, des coupures déjà possibles et des sauvegardes déjà restaurables. La révision 3 de la SP 800-61 (Special Publication) du NIST (National Institute of Standards and Technology), publiée en avril 2025, acte cette réalité en abandonnant le cycle en quatre phases de la révision 2. Cette page fait correspondre l’ancien cycle au nouveau modèle, puis détaille ce que chaque phase exige de l’architecture.
→ Lire l’explication complète de la marmotte
De la SP 800-61r2 à la r3 : du cycle en quatre phases aux fonctions du CSF 2.0
Section intitulée « De la SP 800-61r2 à la r3 : du cycle en quatre phases aux fonctions du CSF 2.0 »La révision 2, datée de 2012, a installé dans toutes les têtes un cycle en quatre phases : préparation ; détection et analyse ; confinement, éradication et récupération ; activité post-incident. La révision 3 (« Incident Response Recommendations and Considerations for Cybersecurity Risk Management: A CSF 2.0 Community Profile ») la remplace et ne reprend pas ce cycle. Elle se présente comme un profil du CSF (Cybersecurity Framework) 2.0 et range la réponse à incident dans ses six fonctions : Gouverner, Identifier, Protéger, Détecter, Répondre, Rétablir.
Le découpage change de nature. Gouverner, Identifier et Protéger constituent la préparation. Détecter, Répondre et Rétablir constituent la réponse proprement dite. L’amélioration continue (catégorie « Amélioration », Improvement, rattachée à la fonction Identifier) n’est plus une phase de clôture : elle alimente toutes les autres, y compris pendant l’incident. La raison de la bascule est factuelle : les incidents sont fréquents, le rétablissement dure des semaines, et l’idée d’une boucle qu’on parcourt puis qu’on referme ne décrit plus le terrain.
Le schéma suivant donne la correspondance. On y lit que la préparation de la r2 éclate en trois fonctions, et que l’activité post-incident devient un flux permanent.
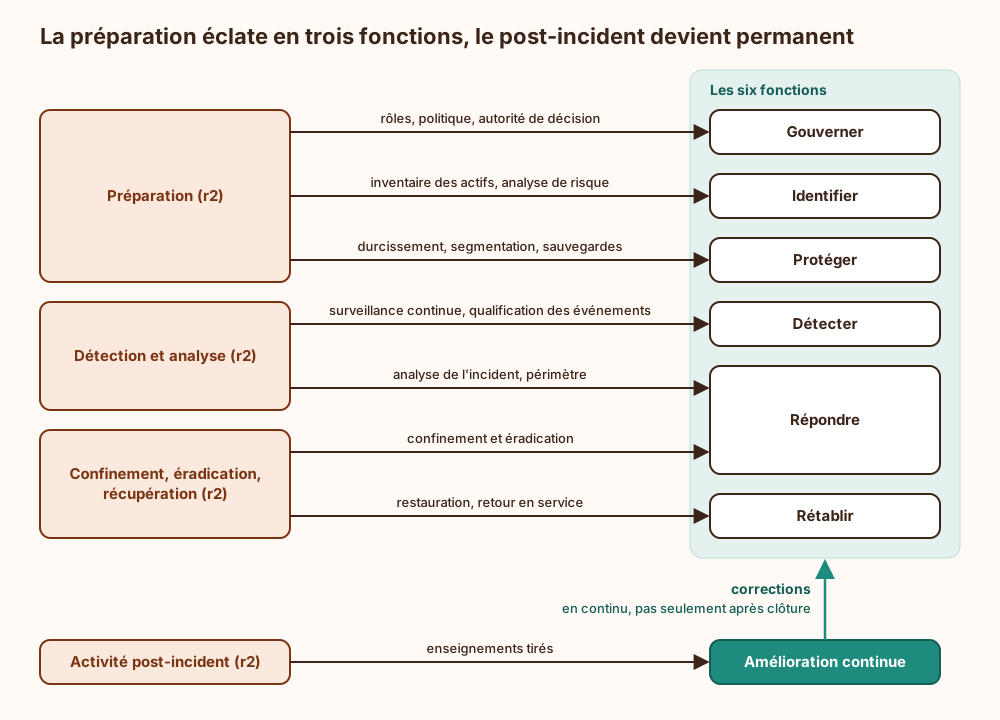
Position défendue ici : garder les quatre phases comme vocabulaire de cellule de crise (tout le monde comprend « on est encore en confinement »), et adopter le modèle de la r3 pour tout ce qui se décide à froid, budget et architecture compris. Présenter le cycle en quatre phases comme « le modèle NIST en vigueur » est en revanche périmé depuis avril 2025. Autre conséquence pratique : la r3 est un document de gestion du risque. Elle ne fournit pas de procédures techniques détaillées ; celles-ci relèvent des pages de détail, par exemple les premières minutes d’un incident ou la chaîne de conservation des preuves.
Le compromis central : confiner vite ou comprendre d’abord
Section intitulée « Le compromis central : confiner vite ou comprendre d’abord »Toute réponse à incident bute sur la même tension. Confiner tôt limite les dégâts, mais détruit des preuves (une machine éteinte perd sa mémoire vive) et prévient l’attaquant, qui active alors ses accès de secours. Observer plus longtemps permet de cartographier le périmètre, mais laisse l’attaquant travailler. La seconde moitié du compromis est symétrique : rétablir vite remet l’activité en route, mais une restauration lancée avant la fin de l’éradication réinstalle l’attaquant avec les données.
La recommandation tient en trois règles.
- Isoler au niveau réseau sans éteindre, chaque fois que l’architecture le permet. On gagne le confinement sans payer la perte de preuve.
- Couper sans délai, preuve sacrifiée, quand une destruction est en cours (chiffrement, effacement). Aucune analyse ne vaut les données qui disparaissent pendant qu’on la mène.
- Ne pas commencer l’éradication avant d’avoir borné le périmètre. Une éradication partielle informe l’attaquant et ne retire que les accès déjà connus ; les autres sont décrits dans la page sur la persistance de l’attaquant.
Condition de validité : ces règles supposent une capacité d’isolement fin et des journaux exploitables. Sans elles, le choix se réduit à tout éteindre ou tout subir, et aucun plan de réponse, aussi bien relié soit-il, ne change cette alternative.
Ce que chaque phase exige de l’architecture : journaux, isolement, sauvegardes
Section intitulée « Ce que chaque phase exige de l’architecture : journaux, isolement, sauvegardes »Le schéma suivant relie les phases aux trois piliers. Le lien à repérer est celui qui va des journaux aux sauvegardes : c’est la date de compromission, lue dans les journaux, qui désigne le point de restauration utilisable.
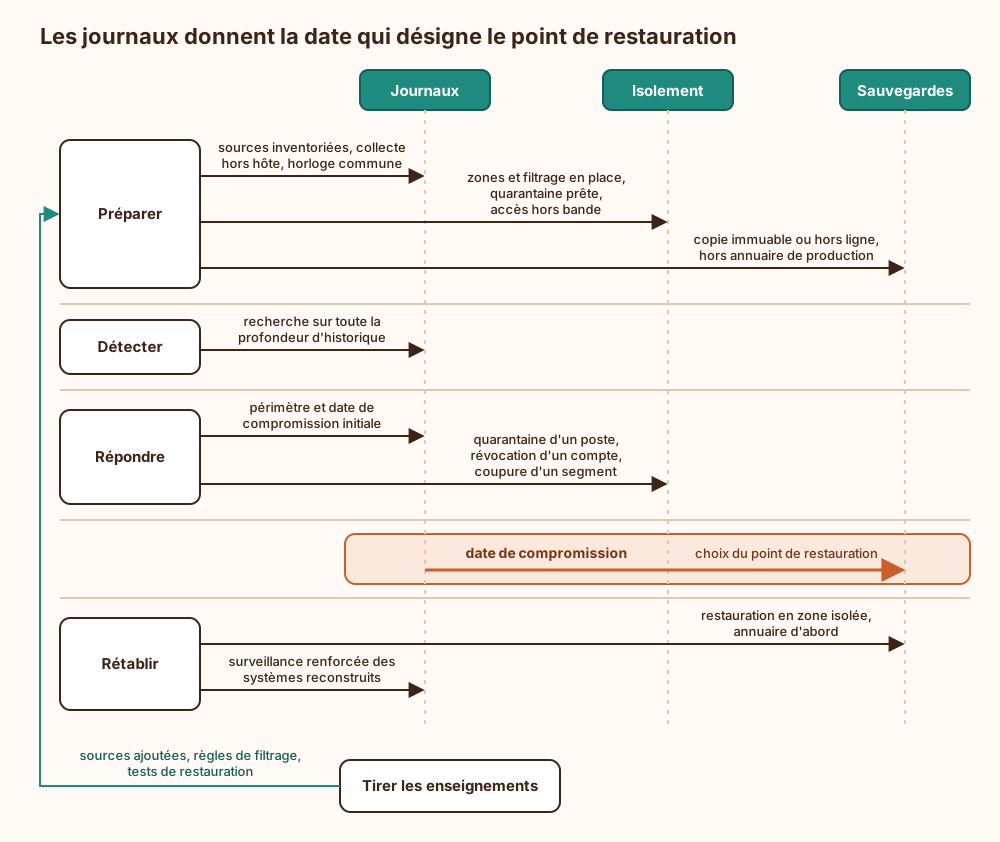
| Phase | Exigence d’architecture | Preuve que c’est prêt |
|---|---|---|
| Préparer (Gouverner, Identifier, Protéger) | Inventaire des actifs et des sources de journaux ; zones réseau filtrées ; sauvegarde hors de portée de l’annuaire de production | Une machine tirée au hasard se retrouve dans l’inventaire, avec sa zone et sa politique de sauvegarde |
| Détecter | Collecte centralisée quasi temps réel, horloge commune, rétention couvrant le délai de découverte visé | Une recherche sur une adresse et une date anciennes renvoie une machine et un compte |
| Répondre (confinement) | Quarantaine d’un poste, d’un compte, d’un segment ; administration hors bande | Un poste est isolé pendant un exercice, par quelqu’un qui n’a pas écrit la procédure |
| Répondre (éradication) | Capacité à réinitialiser les secrets de l’annuaire et à reconstruire depuis des images de confiance | La procédure de réinitialisation a été déroulée hors production |
| Rétablir | Copie antérieure à la compromission, zone de restauration isolée, ordre de reconstruction écrit | Une restauration complète de l’annuaire a été chronométrée |
| Tirer les enseignements | Journal de crise horodaté, tenu hors du système touché | Chaque décision de l’exercice précédent se retrouve avec son heure et son auteur |
Journaux : collecte centralisée, rétention, horodatage, intégrité
Section intitulée « Journaux : collecte centralisée, rétention, horodatage, intégrité »Un journal qui reste sur la machine qui l’a produit appartient à l’attaquant dès que celui-ci y obtient les droits d’administration. L’effacement du journal de sécurité Windows laisse bien une trace (événement 1102), mais cette trace ne sert que si elle a quitté la machine avant. D’où la première exigence : une collecte hors hôte au fil de l’eau, vers une plateforme que les comptes de production n’administrent pas. Une plateforme de journaux jointe à l’annuaire de production tombe avec lui ; l’administrateur du domaine compromis devient administrateur des preuves.
La rétention se dimensionne sur le délai de découverte qu’on veut pouvoir couvrir, pas sur le prix du stockage. Un historique plus court que la durée de présence de l’attaquant interdit de dater l’entrée initiale, donc de choisir une sauvegarde saine. Les sources qui manquent le plus souvent le jour venu sont les moins prestigieuses : requêtes DNS (Domain Name System), baux DHCP (Dynamic Host Configuration Protocol), journaux de proxy, authentifications, créations de processus avec ligne de commande, plan de contrôle des fournisseurs cloud. Sans les baux DHCP, une adresse relevée dans un journal vieux de trois semaines ne désigne aucune machine.
L’horodatage exige une source de temps commune par NTP (Network Time Protocol), un stockage en UTC (temps universel coordonné), et deux dates par événement : celle de l’événement et celle de sa réception. Un écart de quelques minutes entre deux serveurs suffit à inverser l’ordre d’un déplacement latéral dans une reconstruction de chronologie. L’intégrité passe par des identifiants d’écriture seule côté sources et un stockage WORM (Write Once Read Many) ; le détail est dans la page sur la journalisation d’audit immuable, et la mise en forme dans celle sur la normalisation des journaux.
Isolement : poste, compte, segment, administration hors bande
Section intitulée « Isolement : poste, compte, segment, administration hors bande »L’isolement se prépare à trois échelles, et chacune a son piège.
Le poste. L’isolement par l’EDR (Endpoint Detection and Response) coupe le réseau en conservant le canal vers la console, machine allumée, mémoire intacte. Il dépend d’un agent vivant : un attaquant qui a neutralisé l’agent a aussi neutralisé le bouton. Il faut donc un second moyen indépendant du poste : bascule du port de commutateur vers un VLAN (Virtual Local Area Network) de quarantaine, ou déconnexion de la carte réseau virtuelle depuis l’hyperviseur.
Le compte. Désactiver un compte ne ferme ni les sessions ouvertes ni les tickets de service déjà délivrés, valables dix heures par défaut dans un domaine Active Directory. Les jetons de rafraîchissement des services cloud demandent une révocation explicite. Et si le compte krbtgt (celui qui signe les tickets du domaine) est suspecté, son mot de passe se réinitialise deux fois, l’annuaire conservant la valeur précédente.
Le segment. Les règles de coupure (sortie Internet, liaisons entre sites, zone d’administration) s’écrivent et se testent avant. Un réseau à plat ne se confine pas, il s’éteint ; la page sur le mouvement latéral et la segmentation traite le découpage lui-même.
Reste l’administration hors bande : un réseau de gestion séparé, des cartes de gestion à distance joignables sans l’annuaire de production, des comptes de secours locaux dont les secrets sont conservés hors ligne. Le piège classique est la dépendance circulaire : console EDR, coffre de mots de passe et VPN (Virtual Private Network) branchés sur l’authentification unique de l’annuaire compromis. Les outils de réponse deviennent injoignables au moment précis où ils justifient leur licence. Même logique pour la cellule de crise : un canal de communication qui ne passe ni par la messagerie ni par l’annuaire touchés.
Sauvegardes : immuables ou hors ligne, restauration testée, annuaire d’abord
Section intitulée « Sauvegardes : immuables ou hors ligne, restauration testée, annuaire d’abord »La console et le catalogue de sauvegarde figurent parmi les premières cibles d’un attaquant qui prépare un chiffrement. L’infrastructure de sauvegarde vit donc hors de l’annuaire de production, avec ses propres comptes et une authentification multifacteur. L’immuabilité se vérifie au lieu de se croire : sur les stockages objet à verrou de rétention, le mode dit gouvernance se lève avec une permission dédiée, le mode dit conformité ne se lève pas avant l’échéance, même par le compte racine. Une immuabilité fondée sur une durée dépend en outre de l’horloge du système qui la porte.
La profondeur de rétention des sauvegardes obéit à la même règle que celle des journaux : si tous les points de restauration sont postérieurs à la compromission, chacun contient l’implant. D’où le principe de reconstruire les systèmes depuis des images de confiance et de ne restaurer que les données. Une sauvegarde jamais restaurée est une hypothèse, et une hypothèse se vérifie mal un jour de crise.
L’ordre de reconstruction s’écrit à l’avance, car il suit les dépendances : annuaire d’abord (sans identité, rien ne s’authentifie), puis résolution de noms et source de temps, infrastructure de gestion de clés (PKI, Public Key Infrastructure), outillage d’administration et de sauvegarde, enfin les applications par ordre de criticité métier. La restauration se fait dans une zone isolée, raccordée à la production seulement après contrôle. Détails dans les pages sauvegarde immuable anti-ransomware, test de restauration et continuité et reprise.
Exemple : décision de confinement sur un poste compromis
Section intitulée « Exemple : décision de confinement sur un poste compromis »Le schéma suivant déroule la décision sur un poste signalé par une alerte. Il applique les trois règles du compromis central : couper net si une destruction est en cours, sinon isoler machine allumée, puis élargir avant d’éradiquer.
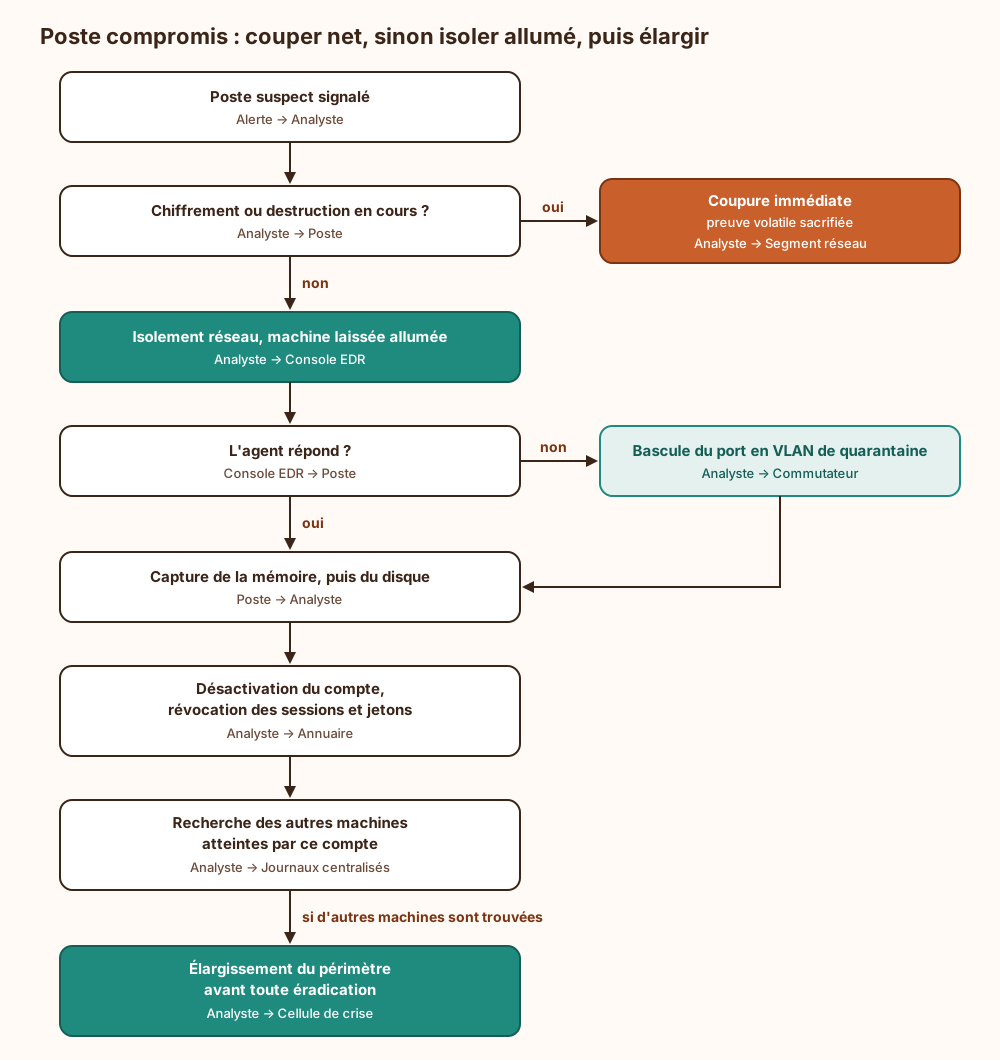
Trois points méritent l’attention. La question posée en premier porte sur la destruction en cours, pas sur la gravité supposée : c’est elle seule qui justifie de sacrifier la mémoire. Le second moyen d’isolement (le commutateur) n’apparaît que si l’agent ne répond plus, ce qui est en soi un indice. Enfin, la recherche dans les journaux part du compte, pas de la machine : un attaquant se déplace avec des identités, et le poste signalé est rarement le premier touché. L’ordre de capture (mémoire avant disque) et la traçabilité des preuves sont traités dans la page sur la chaîne de conservation.
Prérequis d’organisation et de plateforme
Section intitulée « Prérequis d’organisation et de plateforme »Avant tout plan, quatre choses doivent exister. Un inventaire des actifs tenu à jour, faute de quoi le périmètre d’un incident est indéfinissable. Une autorité de décision nommée, joignable, habilitée à couper un service métier sans réunir un comité ; la répartition des rôles est décrite dans les pages sur le CSIRT (Computer Security Incident Response Team) interne et le SOC (Security Operations Center). Un contrat d’assistance externe signé à froid, parce que négocier des conditions générales pendant un chiffrement donne rarement de bons tarifs. Et un plan consultable hors du système d’information : le plan de réponse stocké sur le partage de fichiers chiffré par l’attaquant est un classique du genre.
Surface d’attaque du dispositif de réponse à incident
Section intitulée « Surface d’attaque du dispositif de réponse à incident »Le dispositif de réponse concentre des pouvoirs considérables, ce qui en fait une cible.
- La console EDR. Elle isole et exécute des commandes sur tout le parc. Compromise, elle devient un outil de déploiement pour l’attaquant. Contre-mesures : authentification multifacteur indépendante de l’annuaire de production, comptes nominatifs, journal des actions exporté ailleurs.
- La plateforme de journaux. Un attaquant qui y lit sait ce qui est vu ; un attaquant qui y écrit fabrique de fausses pistes. Contre-mesures : écriture seule depuis les sources, administration séparée, alerte sur toute suppression.
- Les comptes de secours. Privilégiés, rarement utilisés, donc rarement surveillés. Contre-mesures : alerte à chaque usage, rotation après chaque usage, secret scindé entre plusieurs détenteurs.
- Les communications de crise. Un attaquant présent dans la messagerie lit le plan de confinement avant son exécution. Contre-mesure : canal hors bande, décidé et testé à froid.
- La sauvegarde. Ciblée pour suppression ou empoisonnement lent. Contre-mesures : immuabilité vérifiée, comptes distincts, restauration d’essai régulière qui détecte aussi les copies corrompues.
Ce que la réponse à incident ne garantit pas
Section intitulée « Ce que la réponse à incident ne garantit pas »Elle ne prouve jamais l’absence de l’attaquant. L’éradication retire les accès identifiés ; la confiance revient par la reconstruction depuis des sources saines et par une surveillance renforcée après retour en service, pas par une déclaration de clôture.
Elle ne rend pas les données exfiltrées. Une restauration parfaite remet le service en route et laisse intacte la question de ce qui est sorti ; cette réponse vient des journaux de flux sortants, s’ils existent.
Elle ne règle pas les obligations légales. Certains incidents déclenchent des notifications à délai court (directive NIS 2, règlement général sur la protection des données) : échéances et conditions sont sur la page notification d’incident.
Elle ne remplace pas la prévention. Un dispositif de réponse rodé sur un système non durci s’entraîne beaucoup, ce qui est une façon coûteuse de progresser.
Conditions d’exploitation : secrets de secours, supervision, exercices
Section intitulée « Conditions d’exploitation : secrets de secours, supervision, exercices »Un dispositif de réponse se dégrade en silence, comme tout ce qui ne sert pas tous les jours. Quatre contrôles le maintiennent en état.
- Silence des sources. Une source de journaux qui cesse d’émettre doit lever une alerte. Sans ce contrôle, la panne de collecte se découvre pendant l’investigation, soit au pire moment disponible.
- Secrets de secours. Rotation après chaque usage et à échéance fixe, vérification périodique que le secret conservé hors ligne ouvre encore quelque chose.
- Restauration. Essai complet et chronométré, annuaire inclus, en zone isolée. La durée mesurée remplace la durée espérée dans le plan de continuité.
- Exercices. Une simulation d’incident vérifie les preuves du tableau plus haut, par des personnes qui n’ont pas rédigé les procédures.
Le retour d’expérience ferme la boucle, à condition de produire des modifications d’architecture datées et attribuées, pas un document de plus. Il ne fonctionne que si les erreurs se disent sans crainte de sanction, ce que développe la page sur la culture juste ; son déroulé est dans la page communication de crise et retour d’expérience.
La révision 2 de la SP 800-61 reste-t-elle utilisable ?
Section intitulée « La révision 2 de la SP 800-61 reste-t-elle utilisable ? »Elle est remplacée par la r3 et ne fait plus référence. Son cycle en quatre phases garde une valeur de vocabulaire opérationnel, et rien n’interdit de s’en servir pour rythmer une cellule de crise. Pour structurer un programme, un audit ou une feuille de route, c’est le modèle en six fonctions qui s’applique.
Faut-il éteindre une machine compromise ?
Section intitulée « Faut-il éteindre une machine compromise ? »Non par défaut. L’extinction efface la mémoire vive, où se trouvent processus, connexions et parfois clés de chiffrement. L’isolement réseau machine allumée donne le confinement sans cette perte. L’exception est la destruction en cours, où la coupure immédiate prime.
Quelle durée de rétention viser pour les journaux ?
Section intitulée « Quelle durée de rétention viser pour les journaux ? »La question à poser : combien de temps une compromission peut-elle rester inaperçue, et jusqu’où veut-on pouvoir remonter ? Les journaux d’authentification, d’administration et de résolution de noms méritent la profondeur la plus longue, quitte à passer en stockage froid. Ces journaux contiennent des données personnelles : la durée retenue se justifie et se documente.
🐝 Ce qui arrive si on s’en passe
Section intitulée « 🐝 Ce qui arrive si on s’en passe »Sans collecte hors hôte, l’attaquant efface ses traces avec les droits qu’il vient d’obtenir, et la date d’entrée reste inconnue. Sans cette date, aucun point de restauration ne peut être déclaré sain : la reprise repart d’une copie qui contient peut-être déjà l’accès de l’attaquant, lequel revient quelques jours après la remise en service. Sans quarantaine ciblée, le seul confinement disponible est l’arrêt général, donc une interruption d’activité infligée par la défense elle-même. Sans accès hors bande, les équipes perdent la main sur leurs propres outils en même temps que sur l’annuaire. Et sans ordre de reconstruction écrit, les applications sont restaurées avant les services dont elles dépendent, puis restaurées une seconde fois.
🦫 Explication de la marmotte 🍫
Section intitulée « 🦫 Explication de la marmotte 🍫 »Répondre à une attaque informatique se déroule en plusieurs temps, et le premier a lieu avant l’attaque. Il faut d’abord savoir quelles machines existent et qui décide en cas de problème, puis installer trois choses. La première : chaque machine envoie en continu l’enregistrement de ce qu’elle fait vers un endroit séparé, que l’attaquant ne peut pas effacer, avec la même heure partout. La deuxième : le réseau est découpé en zones, il existe un moyen de couper une machine, un compte ou une zone sans tout arrêter, et un accès de secours ne dépend pas du réseau habituel. La troisième : des copies des données que personne ne peut modifier, dont la remise en service a été essayée pour de bon. Quand une attaque survient, les enregistrements servent à repérer le problème, puis à trouver quelles machines sont touchées et depuis quelle date. On coupe alors les machines et les comptes concernés, on retire ce que l’attaquant a installé, puis on reconstruit à partir d’une copie plus ancienne que l’attaque, en commençant par le système qui gère les comptes, car tout le reste en dépend. Si les enregistrements manquent, la date reste inconnue et on risque de remettre en service une copie déjà piégée. Si le découpage manque, il faut tout éteindre. À la fin, on note ce qui a manqué et on le corrige.
À lire aussi
- Analyse mémoire et réseau après un incidentL’analyse mémoire et réseau complète l’analyse disque en préservant les processus, clés et communications visibles au moment de l’incident.
- Inventorier les objets IoT oubliés sur le réseauMéthode d’identification, de confinement et d’exploitation des objets connectés non inventoriés.
- Cloud IaaS, PaaS, SaaS et modèles de déploiement, qui sécurise quoiDéfinition du cloud computing selon le NIST, modèles de service IaaS, PaaS, SaaS et modèles de déploiement, avec ce que chacun délègue réellement en sécurité et ce qu'il laisse au client.
- CERT-EU réponse aux incidents des institutions européennesCERT-EU est le service opérationnel de réponse aux incidents des institutions, organes et agences de l’Union européenne, distinct d’ENISA et d’Europol.
Pages voisines
Réponse à incident NIST SP 800-61r3, cycle complet et architecture
Elle cite
- Lien dans les deux sens :Forensics numérique et chaîne de conservation après incident
- Lien dans les deux sens :Monter un CSIRT interne, missions, services FIRST et rattachement
- Lien dans les deux sens :Architecture de journalisation d’audit immuable centralisée
- Lien dans les deux sens :Réagir aux premières minutes d’un incident suspecté
- Communiquer pendant un incident et mener un retex
- Reconstruire une timeline d'attaque après incident
- Comment limiter le mouvement latéral après compromission
- Détecter la persistance d’un attaquant après incident
- Normaliser les logs avec OCSF, ECS ou CIM
- SOC centre des opérations de sécurité : rôle, organisation, mesure
- Comment mener un exercice de simulation d'incident
- Continuité, sauvegardes, PRA/PCA et haute disponibilité
: les deux pages se citent l’une l’autre.