
SOC centre des opérations de sécurité : rôle, organisation, mesure
SOC centre des opérations de sécurité : rôle, organisation, mesure
Section intitulée « SOC centre des opérations de sécurité : rôle, organisation, mesure »Un SOC (Security Operations Center, centre des opérations de sécurité) réunit les équipes et l’outillage qui surveillent en continu un système d’information, qualifient ce qui ressemble à une attaque et déclenchent la réponse. Il ne se juge ni au nombre d’écrans ni au volume de journaux ingérés. Il se juge à une seule question : une attaque réelle sur le périmètre couvert est-elle vue, comprise et contenue avant de faire des dégâts ?
→ Lire l’explication complète de la marmotte
Mission du SOC : surveiller, qualifier, déclencher la réponse
Section intitulée « Mission du SOC : surveiller, qualifier, déclencher la réponse »La mission tient en trois verbes, et chacun a un livrable vérifiable.
- Surveiller : collecter les traces d’activité pertinentes et y appliquer des règles de détection. Le livrable est une alerte horodatée, rattachée à un actif et à une identité.
- Qualifier : décider si l’alerte est un vrai positif, en estimer la gravité et le périmètre. Le livrable est un ticket tranché (incident, faux positif, activité légitime documentée), pas un « à surveiller » qui pourrit dans la file.
- Déclencher la réponse : appliquer le confinement de premier niveau prévu par procédure (isoler un poste, désactiver un compte, bloquer un domaine) et escalader. Le livrable est une action tracée et une équipe prévenue.
Les frontières avec les équipes voisines sont floues dans les organogrammes et nettes dans les incidents qui tournent mal :
- CSIRT ou CERT (Computer Security Incident Response Team, Computer Emergency Response Team) : il porte l’incident de bout en bout, de l’investigation approfondie à la remédiation, avec l’analyse forensique (voir forensique et chaîne de conservation), la coordination et la communication de crise. Le SOC détecte et confine ; le CSIRT conduit. Dans une petite structure, les mêmes personnes portent les deux casquettes, mais pas avec les mêmes droits ni les mêmes délais.
- Exploitation : elle possède les systèmes et exécute la remédiation (reconstruction, correctif, restauration). Un SOC qui reconstruit lui-même des serveurs a cessé de surveiller pendant ce temps.
- Gestion des vulnérabilités : elle travaille en amont et réduit la surface. Le SOC consomme son inventaire pour prioriser : une tentative d’exploitation sur un actif réellement vulnérable et exposé ne pèse pas comme la même tentative sur un serveur corrigé.
Le compromis central du sujet se pose dès ici : couverture contre contexte. Élargir la couverture (plus de sources, plus d’heures, plus d’analystes, un prestataire) se paie en perte de connaissance fine du système surveillé. Or la qualification repose entièrement sur ce contexte : savoir que tel compte de service se connecte normalement depuis tel bastion, et jamais depuis un poste de travail. La recommandation de cette page en découle : externaliser des heures de veille est raisonnable, externaliser le contexte et le droit d’agir ne l’est jamais.
Briques d’un SOC : sources, SIEM, SOAR, cas d’usage et astreinte
Section intitulée « Briques d’un SOC : sources, SIEM, SOAR, cas d’usage et astreinte »Le flux nominal se lit de gauche à droite. Chaque étape peut échouer en silence, et c’est précisément pour cela qu’il faut le dessiner :
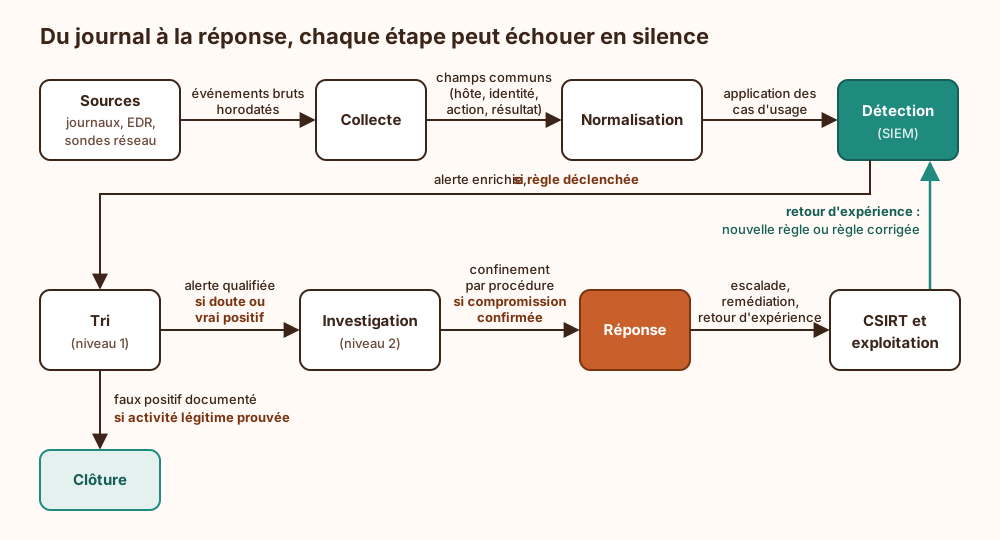
La dernière flèche est celle que la plupart des SOC n’implémentent jamais. Sans elle, le dispositif ne s’améliore pas : il vieillit.
Sources. Trois familles, complémentaires : les journaux (annuaire, authentification, proxy, DNS, VPN (Virtual Private Network), consoles cloud), l’EDR (Endpoint Detection and Response, voir la page dédiée) qui voit les processus et la mémoire sur les terminaux, et les sondes réseau (NDR, Network Detection and Response) qui voient les flux, y compris ceux des équipements sur lesquels aucun agent ne s’installe. Chacune a ses angles morts : l’EDR ne voit pas l’imprimante, la sonde ne voit pas dans un flux chiffré, les journaux ne voient que ce que l’application a bien voulu écrire.
Collecte et normalisation. Un champ « utilisateur » écrit de quatre façons différentes selon la source rend toute corrélation fausse. Ce travail d’ingénierie est décrit dans normalisation des journaux et pipelines.
SIEM (Security Information and Event Management) : le moteur qui stocke, indexe et corrèle. Son fonctionnement et le calibrage des règles sont traités dans la théorie de la détection dans un SIEM.
Cas d’usage de détection. L’unité de valeur d’un SOC n’est pas la source, c’est le cas d’usage. Un cas d’usage complet comprend six éléments : la menace visée (idéalement une technique ATT&CK), les données nécessaires, la règle, la procédure de traitement, un propriétaire qui la maintient, et un test qui prouve qu’elle se déclenche. Une règle sans procédure produit une alerte que personne ne sait traiter ; une règle sans test produit une illusion.
SOAR (Security Orchestration, Automation and Response) : il enrichit les alertes (réputation, propriétaire de l’actif, historique) et exécute des actions. Son gain le plus sûr est l’enrichissement, qui économise des minutes à chaque alerte. Les actions automatiques destructrices (isolement, désactivation de compte) méritent une validation humaine tant que la règle source n’a pas prouvé sa précision.
Procédures et astreinte. Une procédure dit quoi faire, avec quels droits, et qui prévenir. L’astreinte dit qui le fait à 3 h un dimanche. Sans les deux, une alerte critique nocturne attend le lundi matin, horodatée avec une précision remarquable.
Prérequis avant d’ouvrir le moindre écran : un inventaire d’actifs et d’identités tenu à jour, des horloges synchronisées par NTP (Network Time Protocol) sur toutes les sources (une chronologie à décalage variable est inexploitable), une rétention définie (au moins la durée de présence typique d’un attaquant, qui se compte en semaines), et un annuaire de contacts d’escalade réellement joignables.
Organisation d’un SOC : niveaux de tri, d’investigation et de chasse
Section intitulée « Organisation d’un SOC : niveaux de tri, d’investigation et de chasse »Le découpage classique en trois niveaux :
- Niveau 1 (tri) : qualification rapide, selon procédure, en quelques minutes par alerte. Il clôt, documente ou escalade.
- Niveau 2 (investigation) : corrélation entre sources, délimitation du périmètre, confinement initial.
- Niveau 3 (chasse et ingénierie de détection) : recherche proactive d’attaquants que les règles n’ont pas vus (voir threat hunting par hypothèses) et écriture des nouveaux cas d’usage.
Ce découpage a un coût que les organigrammes ne montrent pas. Chaque passage de niveau perd du contexte : l’analyste de niveau 2 relit ce que le niveau 1 a déjà vu. Un niveau 1 sanctionné pour les vrais positifs manqués, jamais pour les escalades inutiles, escalade tout par défaut, et le niveau 2 devient un niveau 1 mieux payé. Enfin, un poste de tri pur s’use vite ; les ressorts humains sont traités dans la fatigue d’alerte et dans la charge cognitive d’un analyste SOC.
Deux correctifs valent mieux qu’un niveau supplémentaire : donner au niveau 1 le droit de clore avec justification et de proposer la modification d’une règle bruyante, et faire tourner les analystes entre tri, investigation et chasse. Une équipe réduite d’analystes polyvalents adossés à une petite cellule d’ingénierie de détection bat souvent une pyramide à trois étages.
Couverture horaire réelle. Une année compte 8 760 heures. Un équivalent temps plein (ETP) en fournit de l’ordre de 1 600 travaillées, une fois retirés congés, formation et absences. Tenir un seul poste en continu demande donc cinq à six ETP ; deux analystes présents en permanence, onze à douze. C’est le calcul qui explique pourquoi beaucoup de « SOC 24/7 » sont en réalité une collecte 24/7, une analyse en heures ouvrées et une astreinte la nuit. Ce modèle se défend, à condition de l’écrire (voir organiser une astreinte cybersécurité durable) : quelles alertes réveillent l’astreinte, en combien de minutes elle doit agir, avec quels droits. Les opérateurs de rançongiciel savent lire un planning et préfèrent les nuits et les week-ends (voir ransomware-as-a-service).
SOC interne, MSSP ou hybride : ce qui reste à la charge de l’organisation
Section intitulée « SOC interne, MSSP ou hybride : ce qui reste à la charge de l’organisation »Trois modèles :
- Interne : contexte maximal, coût fixe élevé, difficulté de recrutement et de rétention. Il se justifie quand le volume et la sensibilité du système d’information occupent réellement une équipe d’ingénierie de détection.
- Externalisé : MSSP (Managed Security Services Provider) ou SOC managé, parfois vendu sous l’étiquette MDR (Managed Detection and Response) quand le prestataire opère aussi l’EDR et agit sur les terminaux. Il achète des heures et une mutualisation de la veille sur les menaces. Il n’achète pas le contexte.
- Hybride : le prestataire assure la veille continue et le tri ; l’interne garde l’ingénierie des cas d’usage, l’investigation sur les actifs critiques et la décision de réponse.
Recommandation : pour une organisation qui n’a pas la masse critique d’une équipe de nuit, le modèle hybride est le bon défaut. Le choix entre interne et hybride dépend d’une question : l’organisation peut-elle tenir seule une rotation de nuit et un rythme d’écriture de nouvelles détections ? Si la réponse est non, le SOC interne « 24/7 » sera un SOC 8/5 avec une étiquette optimiste.
Quel que soit le modèle, ces éléments restent à la charge de l’organisation, et aucun contrat ne les transfère :
- l’inventaire des actifs, des identités et de leur criticité ;
- le contexte métier : comptes de service, flux normaux, fenêtres de maintenance ;
- les contacts d’escalade joignables à toute heure, testés ;
- le droit d’agir : une autorisation écrite et préalable qui dit qui peut isoler quoi, sans réunion ;
- le signalement des changements du système d’information, faute de quoi le prestataire surveille un réseau qui n’existe plus.
Clauses à exiger au contrat : propriété des règles de détection et accès aux journaux bruts, durée de rétention, définitions précises des engagements de délai (délai de qualification et délai de notification sont deux choses différentes), et réversibilité (récupération des règles, des données et de l’historique des tickets).
En France, l’ANSSI (Agence nationale de la sécurité des systèmes d’information) délivre la qualification PDIS (Prestataires de Détection des Incidents de Sécurité), fondée sur un référentiel d’exigences publié par l’agence ; la liste des prestataires qualifiés figure sur son site. La qualification atteste qu’un prestataire respecte ce référentiel, ce qui pèse lourd pour un choix de fournisseur. Elle ne remplace ni le contexte ni le droit d’agir, et ne transfère aucune responsabilité de l’organisation surveillée. Pour savoir si une qualification est exigée dans un cas donné, se reporter aux textes applicables et au référentiel officiel.
Surface d’attaque du SOC et ce qu’il ne garantit pas
Section intitulée « Surface d’attaque du SOC et ce qu’il ne garantit pas »Un SOC est une cible. Il centralise la cartographie du système d’information, des comptes à privilèges sur les outils de réponse et des secrets d’API vers presque tout. Attaques connues et contre-mesures :
- Aveuglement des sources : désactivation de l’agent EDR (notamment via un pilote vulnérable chargé par l’attaquant), effacement des journaux d’événements, arrêt du service de transfert. Contre-mesure : détecter le silence. Une source qui cesse d’émettre doit lever une alerte, au même titre qu’une attaque ; transférer les journaux au fil de l’eau vers un stockage où l’hôte source n’a aucun droit d’effacement.
- Saturation : générer du bruit pour noyer l’action réelle. Contre-mesure : agrégation par actif et par identité plutôt que par alerte, et quotas de bruit par règle.
- Compromission des outils : un compte administrateur du SIEM ou du SOAR offre une vue complète et souvent des actions sur tout le parc. Contre-mesure : administration depuis des postes dédiés, authentification multifacteur, comptes de service à privilèges minimaux, actions destructrices soumises à validation.
- Accès du prestataire : la connexion d’un MSSP à plusieurs clients est un vecteur de chaîne d’approvisionnement (voir attaques sur la chaîne d’approvisionnement). Contre-mesure : accès nominatifs, journalisés, limités dans le temps et surveillés comme n’importe quel accès tiers.
Ce que le SOC ne garantit pas : la prévention (un SOC constate, il n’empêche pas), la détection de ce qui n’est pas collecté, la détection d’un abus commis avec des droits légitimes et un comportement banal, et la remédiation. Le reste vient du durcissement, de la segmentation (voir mouvement latéral et segmentation), de la gestion des identités et de l’exploitation.
Conditions d’exploitation :
- Secrets : les clés d’API des connecteurs (cloud, messagerie, annuaire) vont dans un coffre, avec rotation planifiée et alerte sur tout usage hors des adresses du collecteur.
- Supervision du SOC lui-même : retard d’ingestion, sources muettes, file d’alertes en attente, règles en erreur. Un pipeline en retard de six heures produit une détection en temps réel de ce qui s’est passé ce matin.
- Sauvegarde : règles et procédures versionnées dans un dépôt (« detection as code »), avec revue et tests ; configuration des collecteurs reproductible.
- Reprise : prévoir le mode dégradé quand le SIEM tombe (consoles EDR directes, journaux locaux conservés), parce qu’un attaquant attentif choisit volontiers ce moment.
Mesurer un SOC : couverture ATT&CK, délais, faux positifs et exercices
Section intitulée « Mesurer un SOC : couverture ATT&CK, délais, faux positifs et exercices »Quatre familles d’indicateurs, à lire ensemble.
Couverture des techniques. La matrice MITRE ATT&CK (Adversarial Tactics, Techniques and Common Knowledge) sert de grille : pour chaque technique jugée probable sur ce système d’information, existe-t-il un cas d’usage, alimenté par une source active, et testé dans les trois derniers mois ? Une technique ne compte pas comme couverte parce que la source existe ou que le fournisseur livre une règle. La carte de chaleur toute verte présentée en comité mesure surtout l’habileté de l’outil à colorier ; sa version honnête comporte trois teintes : non couvert, règle présente non testée, règle testée.
Délais, exprimés en distribution (médiane et 90e centile) et non en moyenne : délai entre l’événement et l’alerte, entre l’alerte et la prise en charge, entre la prise en charge et le confinement.
Faux positifs, mesurés par règle. Un taux global de 95 % de faux positifs ne dit rien ; savoir que trois règles produisent l’essentiel du bruit dit quoi corriger demain matin.
Exercices : émulation de techniques sur un environnement de production contrôlé (exercices « purple team »), injection d’événements témoins pour vérifier le flux de bout en bout, tests d’astreinte à heure imprévue. Un exercice qui ne se déclenche pas vaut mieux qu’un tableau de bord rassurant : il dit où regarder.
Pourquoi MTTD et MTTR seuls trompent. Le MTTD (Mean Time To Detect) et le MTTR (Mean Time To Respond, parfois lu « to Recover », ce qui n’est pas la même mesure) ne portent que sur les incidents détectés : un attaquant jamais vu n’entre pas dans la moyenne, et un SOC aveugle affiche donc un excellent MTTD. Le début réel d’une compromission n’est connu qu’après investigation, souvent bien plus tôt que la première alerte. La moyenne écrase les cas graves sous des dizaines de cas triviaux. Enfin, piloter une équipe au MTTR pousse à clore vite plutôt qu’à clore juste. Ces indicateurs n’ont de sens qu’accompagnés de la couverture testée et des résultats d’exercices ; l’éditorial Pourquoi MTTD et MTTR biaisent la sécurité développe la critique.
Échecs classiques d’un SOC
Section intitulée « Échecs classiques d’un SOC »- Collecte sans cas d’usage. Ingérer tout « au cas où » produit une facture au gigaoctet et aucune détection. Vingt ans de métier apprennent que le lac de données de sécurité finit en marécage dès que personne n’est chargé d’y pêcher. La règle : aucune source sans au moins un cas d’usage ou un besoin d’investigation écrit.
- Alertes jamais revues. Des règles écrites une fois, jamais testées, dont la source a changé de format depuis : elles ne se déclenchent plus et personne ne le remarque, puisque le silence ressemble à de la sécurité. Revue périodique obligatoire, avec propriétaire nommé.
- Prestataire sans contexte. Il notifie fidèlement « connexion inhabituelle » sur un compte qu’il ne sait pas critique, en heures ouvrées, par courriel. La qualification revient alors à l’organisation, ce qui annule l’intérêt du contrat.
- Absence de droit d’isoler. Le SOC voit, qualifie, puis attend qu’un responsable réponde au téléphone pour autoriser l’isolement d’un poste. Un chiffrement de parc se compte en heures ; une chaîne de validation se compte souvent en jours.
- Sources muettes non détectées. L’agent désinstallé, le collecteur saturé, le connecteur cloud dont le jeton a expiré : chaque silence est un trou de couverture invisible tant qu’il n’est pas lui-même surveillé.
Exemple : chaîne de détection d’un compte de service détourné
Section intitulée « Exemple : chaîne de détection d’un compte de service détourné »Scénario : un compte de service d’application, censé se connecter uniquement depuis deux serveurs, ouvre une session interactive sur un poste de travail, puis une tâche planifiée est créée sur un serveur de fichiers. Le schéma montre où chaque brique intervient et où se placent les décisions :
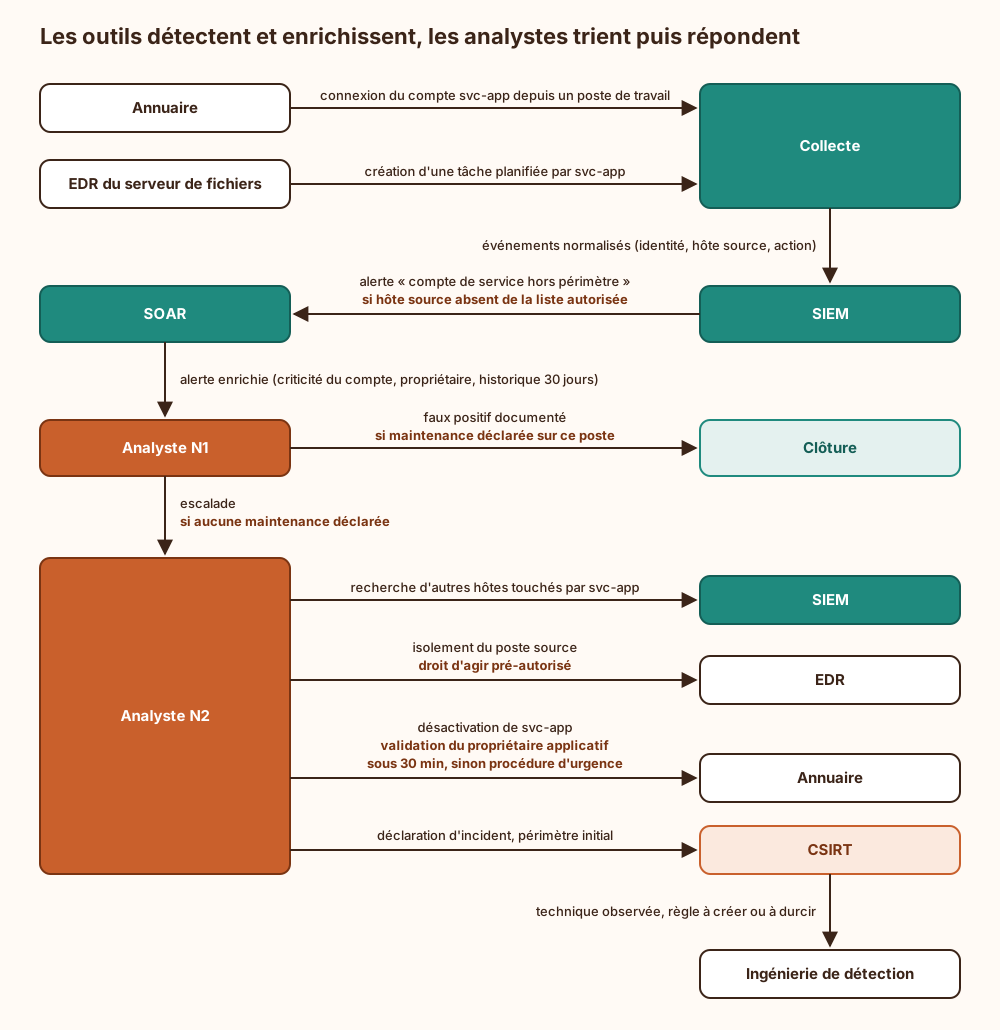
Trois points à retenir. La règle n’existe que parce que l’inventaire décrit les serveurs autorisés pour ce compte : sans ce contexte, l’événement est une connexion parmi des millions. L’isolement du poste est immédiat parce qu’il a été autorisé à l’avance, alors que la désactivation du compte, qui peut arrêter une application métier, passe par une validation bornée dans le temps. Enfin, la dernière flèche referme la boucle : la technique observée devient une détection testée, et la couverture mesurée progresse d’une ligne réelle.
🐝 Ce qui arrive si on s’en passe
Section intitulée « 🐝 Ce qui arrive si on s’en passe »Sans centre des opérations de sécurité, les traces existent mais personne ne les lit. Les étapes bruyantes d’une intrusion (reconnaissance de l’annuaire, connexions anormales, création de tâches planifiées) passent sans réaction. L’attaquant n’est alors découvert qu’à sa phase visible, souvent par un tiers ou par une note de rançon. Les journaux restés sur les hôtes tournent selon leur taille maximale : les premiers événements de l’intrusion sont écrasés avant que quiconque les consulte. Sans chronologie, le point d’entrée et le périmètre touché restent inconnus. La remédiation doit donc traiter tout le parc comme suspect, au risque de laisser en place la porte utilisée. Les données réellement consultées ne peuvent pas non plus être établies, ce qui rend imprécise toute notification réglementaire.
🦫 Explication de la marmotte 🍫
Section intitulée « 🦫 Explication de la marmotte 🍫 »Un centre des opérations de sécurité est une équipe chargée de repérer les attaques informatiques contre une organisation, puis de lancer la riposte. Tout commence par la collecte : les ordinateurs, les serveurs et le réseau écrivent en permanence des traces de ce qu’ils font, par exemple « tel compte s’est connecté depuis telle machine ». Ces traces sont rassemblées dans un logiciel central qui les met dans un format commun. Des règles écrites à l’avance y cherchent les comportements suspects ; quand une règle se déclenche, elle crée une alerte. Un premier analyste regarde l’alerte et décide si c’est une vraie attaque ou une fausse alarme. En cas de doute, un analyste plus expérimenté enquête, mesure l’étendue des dégâts et coupe l’accès à la machine ou au compte touché. Ensuite, une autre équipe répare. Pour que cela marche, il faut une liste à jour des machines, des personnes joignables la nuit et l’autorisation écrite de couper une machine sans attendre. Les échecs fréquents : collecter des montagnes de traces sans règles pour les lire, garder des règles qui ne fonctionnent plus, confier la surveillance à une entreprise extérieure qui ne connaît pas l’organisation, ou devoir demander une permission pendant que l’attaque continue. Enfin, mesurer seulement la vitesse de détection trompe : les attaques jamais vues n’apparaissent dans aucun chiffre.
À lire aussi
- Collecter et fiabiliser les logs de sécuritéCollecter, horodater, normaliser et contrôler les événements de sécurité conditionne la détection autant que le choix du SIEM.
- Exécuter un threat hunting à partir d'une hypothèseGuide pas-à-pas pour préparer, exécuter et pérenniser un exercice de threat hunting fondé sur une hypothèse vérifiable.
- Monter un CSIRT interne, missions, services FIRST et rattachementComment monter un CSIRT interne, du mandat au catalogue de services du cadre FIRST, avec son rattachement, son astreinte et sa coopération avec le CERT-FR et les CSIRT sectoriels.
- Menaces réseau, détection et réponse opérationnelleRelier attaques réseau, détection, triage, réponse à incident, DDoS et exploitation SOC sans transformer le site en manuel offensif.
Pages voisines
La citent
- Monter un CSIRT interne, missions, services FIRST et rattachement
- OSINT défensif : mesurer et réduire l'exposition publique
- Partager le renseignement sur la menace avec ISAC, MISP et STIX
SOC centre des opérations de sécurité : rôle, organisation, mesure
Elle cite
- Lien dans les deux sens :MITRE ATT&CK et CVE en cybersécurité
- Comment calibrer les alertes d’un SIEM sans noyer le SOC
- EDR : fonctionnement, angles morts et contournements
- Normaliser les logs avec OCSF, ECS ou CIM
- Réduire la fatigue d’alerte dans un SOC
- Attaques supply chain et protection des dépendances
- Comment formuler une hypothèse de threat hunting
- Comment limiter le mouvement latéral après compromission
- Forensics numérique et chaîne de conservation après incident
: les deux pages se citent l’une l’autre.