
Détecter le contenu IA malveillant : limites
Détecter le contenu IA malveillant : limites
Section intitulée « Détecter le contenu IA malveillant : limites »Un modèle de langage transforme un coût humain en coût machine : phishing personnalisé, faux avis, commentaires de désinformation et messages de fraude peuvent être produits en variantes quasi infinies. Chercher à déterminer après coup si chaque phrase vient d’une machine paraît séduisant, mais ce contrôle échoue précisément là où l’attaquant a le plus de latitude.
→ Lire l’explication complète de la marmotte
LLM et industrialisation du contenu malveillant
Section intitulée « LLM et industrialisation du contenu malveillant »Un LLM (Large Language Model, grand modèle de langage) ne rend pas une fraude intrinsèquement plus crédible. Il retire surtout les limites de production : temps de rédaction, adaptation linguistique, déclinaison par secteur, personnalisation depuis des données publiques et maintien d’une cohérence superficielle. C’est un changement économique, pas une nouvelle classe de vulnérabilité.
Une campagne traditionnelle doit arbitrer entre volume et personnalisation. Avec un modèle de langage, cet arbitrage devient beaucoup moins coûteux. Un scrape de profils publics, de communiqués d’entreprise, de dépôts de code ou d’annonces de recrutement alimente des messages ciblés : nom du responsable, projet en cours, fournisseur cité, vocabulaire métier. La victime ne reçoit plus un message bourré de fautes. Elle reçoit un message grammaticalement banal, ce qui est beaucoup plus dangereux et beaucoup moins glamour sur les slides de vendeurs.
La même logique touche les places de marché et les réseaux sociaux. Des avis synthétiques soutiennent une arnaque commerciale, des commentaires coordonnés donnent une impression de consensus, et des réponses automatisées prolongent une conversation avec une victime. Le texte n’a pas besoin d’être parfait. Il doit seulement être assez plausible pour obtenir un clic, une réponse ou un paiement.
Le compromis central est net : la détection de contenu promet du filtrage sans modifier le parcours métier, mais elle paie cette commodité par une décision probabiliste prise sur un signal manipulable. L’authentification de la source impose des changements d’infrastructure et de processus, mais elle contrôle une propriété que l’attaquant ne peut pas corriger par une reformulation.
La recommandation est donc de ne pas utiliser un détecteur de texte généré comme contrôle de blocage principal. Le réserver à l’enquête, au tri de signalements et à la détection de campagnes à grande échelle. Pour les flux où une décision entraîne un paiement, une modification d’identité ou une divulgation de données, l’autorité doit venir de l’identité authentifiée et d’une validation hors bande.
Cette distinction rejoint les limites exposées dans la section IA locale : un modèle est un composant de traitement, pas une source de vérité. Lui attribuer une intention ou une provenance à partir de sa prose reste une erreur de catégorie.
Détecteurs de contenu IA : signaux faibles, faux positifs et contournement
Section intitulée « Détecteurs de contenu IA : signaux faibles, faux positifs et contournement »Les détecteurs exploitent généralement la perplexité, la régularité statistique des séquences de mots, des classifieurs entraînés sur des corpus humains et synthétiques, ou des marques statistiques introduites lors de la génération. La perplexité mesure à quel point une suite de mots est prévisible pour un modèle. Un texte très prévisible peut être signalé comme synthétique, mais ce n’est pas une preuve de provenance.
Le problème fondamental est l’absence de frontière stable entre texte humain et texte produit par machine. Un humain peut écrire de façon régulière, notamment dans un contexte administratif, scolaire, juridique ou lorsqu’il utilise une langue seconde. Un modèle peut au contraire produire des formulations irrégulières, reprendre une citation ou intégrer des fautes volontairement. Un détecteur qui bloque du contenu sur ce fondement pénalise mécaniquement des textes humains légitimes.
Les faux positifs ont une conséquence opérationnelle plus grave que l’imprécision d’un tableau de bord. Sur une messagerie, ils peuvent mettre en quarantaine une demande fournisseur réelle. Sur une plateforme de publication, ils peuvent censurer un utilisateur. Sur un système de modération, ils créent une file d’appel humaine impossible à absorber. Un seuil abaissé réduit les contenus synthétiques non détectés, mais augmente les erreurs contre les contenus légitimes. Il n’existe pas de réglage magique caché dans un menu avancé, malgré les brochures qui semblent avoir été écrites par un générateur de brochures.
Le contournement est trivial dès que l’attaquant peut post-traiter le texte. Reformuler avec un autre modèle, traduire puis retraduire, mélanger des phrases humaines et synthétiques, modifier le rythme, ajouter des détails factuels ou demander une réécriture dans un style personnel suffisent souvent à dégrader le score. Le détecteur reconnaît une distribution observée, pas une origine métaphysique du texte.
Les filigranes statistiques, parfois appelés watermarks, ne résolvent pas ce problème. Ils consistent à favoriser certains choix de mots pendant la génération afin de laisser une signature détectable. Ils peuvent être utiles pour attribuer une sortie brute à un générateur coopératif, sous conditions strictes : texte assez long, modèle émetteur connu, secret de marquage protégé et transformation limitée. Une paraphrase, une traduction ou une réécriture détruit ou affaiblit le signal. Un attaquant n’a aucune obligation de conserver le texte brut. C’est même rarement son hobby préféré.
Les modèles et les détecteurs évoluent donc dans une course à l’armement. Un détecteur publié fournit un objectif de contournement. Une nouvelle génération modifie les statistiques observées. Réentraîner le détecteur améliore parfois la mesure sur un jeu de test, puis le terrain mélange modèles, humains, outils de correction et contenus hybrides. Le score n’est pas une preuve exploitable pour une sanction automatisée.
Authentification de la source plutôt que police du style
Section intitulée « Authentification de la source plutôt que police du style »Le contrôle doit porter sur l’identité de l’émetteur, le canal et l’action demandée. Pour l’e-mail, cela implique SPF (Sender Policy Framework), DKIM (DomainKeys Identified Mail) et DMARC (Domain-based Message Authentication, Reporting, and Conformance). SPF autorise des serveurs d’envoi pour un domaine. DKIM signe cryptographiquement certains en-têtes et le corps. DMARC impose l’alignement entre le domaine visible dans l’adresse d’expédition et les identités validées par SPF ou DKIM, puis définit une politique de traitement.
Ces mécanismes ne disent rien sur la qualité du message. Ils établissent qu’un domaine contrôlé a émis ou autorisé le message, selon les règles configurées. C’est exactement le bon niveau de preuve contre l’usurpation directe. Un e-mail parfaitement rédigé mais sans alignement DMARC n’acquiert aucune légitimité parce qu’un détecteur le juge humain. Une prose suspecte venant d’un domaine partenaire authentifié mérite, elle, une analyse de fraude métier plutôt qu’une condamnation stylistique.
L’authentification de domaine ne protège pas contre un compte légitime compromis, un domaine ressemblant, un fournisseur malveillant ou une fraude initiée depuis une boîte interne. Le reste doit provenir de contrôles transactionnels : validation hors bande d’un changement de coordonnées bancaires, approbation à deux personnes pour les paiements, interdiction de changer un bénéficiaire et d’émettre un ordre dans la même session, journalisation des décisions et détection d’anomalies de relation.
Sur une marketplace, la vérification doit relier le vendeur à une identité vérifiée, un moyen de paiement, un historique et un canal de recours. La vérification documentaire seule est insuffisante : les documents peuvent être volés ou obtenus frauduleusement. Lier les actions sensibles à une authentification forte, imposer une période d’attente avant décaissement et surveiller les changements de compte de versement réduisent la rentabilité de l’industrialisation.
Le même principe s’applique à la désinformation. Détecter la syntaxe d’un commentaire est fragile. Limiter la création de comptes, vérifier les numéros ou les identités selon le risque, ralentir les nouveaux comptes, corréler les grappes de publication et rendre l’origine du contenu traçable produit des signaux plus résistants. Le texte reste une donnée parmi d’autres, jamais le juge unique.
Les mécanismes d’identité s’inscrivent dans une architecture plus large décrite dans la section identités. Sans cycle de vie des comptes, révocation et traces d’audit, signer un message revient à mettre un joli sceau sur une enveloppe dont tout le monde possède la clé.
Exemple : router un e-mail selon son authentification
Section intitulée « Exemple : router un e-mail selon son authentification »Le schéma suivant illustre une règle de tri minimale à partir de l’en-tête Authentication-Results, ajouté par un relais qui a déjà vérifié SPF, DKIM et DMARC. Le filtre ne valide pas les signatures lui-même : faire confiance à un en-tête reçu depuis Internet serait une erreur grossière. Le relais doit supprimer tout en-tête homonyme entrant puis ajouter le sien.
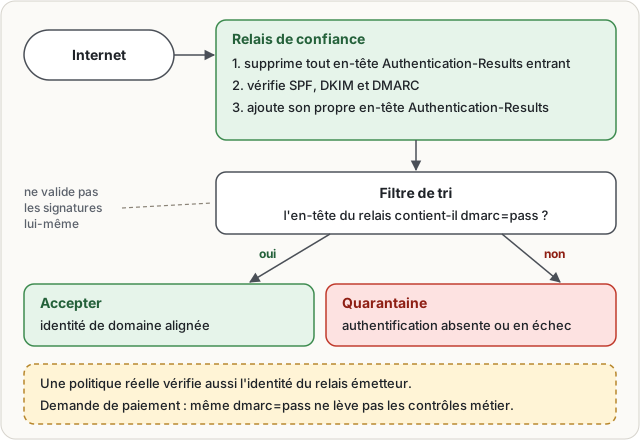
Cette règle ne détecte pas un LLM et ne doit pas prétendre le faire. Elle place le message dans une catégorie de confiance fondée sur une vérification technique. Pour les demandes de paiement, même dmarc=pass ne doit pas lever les contrôles métier : le domaine partenaire peut être compromis, et la fraude adore les autorisations implicites.
Exploitation : clés DKIM, supervision et reprise
Section intitulée « Exploitation : clés DKIM, supervision et reprise »DKIM dépend d’une paire de clés asymétriques. La clé privée reste dans le système de signature, idéalement sous contrôle d’accès dédié ou dans un HSM (Hardware Security Module, module matériel de sécurité) lorsque le volume, la criticité ou les exigences de cloisonnement le justifient. La clé publique est publiée dans le DNS (Domain Name System, système de noms de domaine) sous un sélecteur. Le sélecteur permet de faire coexister une ancienne et une nouvelle clé pendant une rotation.
Une rotation sûre publie d’abord la nouvelle clé DNS, attend sa propagation, active la signature avec le nouveau sélecteur, puis retire l’ancienne clé après expiration des messages encore en transit. Supprimer la clé publique avant cette fenêtre casse la vérification de messages légitimes. Conserver indéfiniment les anciennes clés transforme la rotation en décoration murale.
La supervision doit suivre les rapports DMARC, les taux d’échec par domaine, les domaines récemment observés, les modifications de politique et les erreurs de résolution DNS. Une hausse brutale d’échecs peut signaler une usurpation, une mauvaise configuration d’un prestataire ou une clé expirée. Ces causes ont des remèdes opposés : bloquer sans qualifier l’événement casse la messagerie métier avec une régularité presque artistique.
Les sauvegardes doivent contenir la configuration de signature, les sélecteurs, les enregistrements DNS attendus et les procédures de révocation. Elles ne doivent pas multiplier des copies non chiffrées de clés privées. En cas de compromission, générer une nouvelle paire, publier un nouveau sélecteur, basculer la signature et révoquer les accès au système compromis constituent la reprise minimale. Les journaux d’émission restent nécessaires pour évaluer la période d’exposition.
La détection de contenu généré par IA peut compléter cette architecture sous forme de score d’enquête, corrélé avec l’âge du domaine, l’échec d’authentification, la nouveauté d’un bénéficiaire ou une demande inhabituelle. Isolé, ce score mesure surtout l’enthousiasme d’un classifieur face à de la prose. Corrélé à une identité et à une action, il devient un signal secondaire acceptable.
🐝 Ce qui arrive si on s’en passe
Section intitulée « 🐝 Ce qui arrive si on s’en passe »Sans enregistrement DMARC publié avec une politique de quarantaine ou de rejet, n’importe quel serveur peut émettre des messages portant exactement le domaine visible de l’organisation, et les serveurs destinataires n’ont aucune consigne pour les écarter. L’usurpation vise alors surtout l’extérieur : clients, partenaires et fournisseurs reçoivent des demandes de paiement ou de changement de coordonnées au nom du domaine, sans que ces messages transitent jamais par l’infrastructure de l’organisation. Aucun journal interne ne les enregistre ; seuls les rapports agrégés DMARC (adresse rua) révèlent ces envois, et leur absence prive donc de toute détection comme de toute estimation de l’ampleur de la campagne. Un détecteur de contenu installé en interne ne peut rien y changer : il n’analyse que le courrier reçu, pas celui envoyé ailleurs sous une identité empruntée.
🦫 Explication de la marmotte 🍫
Section intitulée « 🦫 Explication de la marmotte 🍫 »Les outils capables de rédiger du texte peuvent produire rapidement beaucoup de messages différents. Une personne malveillante peut récupérer des informations publiques sur une entreprise ou une personne, puis demander au logiciel de rédiger des messages qui mentionnent ces informations. Le message paraît alors plus crédible qu’un ancien courrier frauduleux copié des milliers de fois.
Certains logiciels essaient de deviner si un texte a été écrit par une machine. Ils cherchent des habitudes dans le choix des mots et dans la façon de construire les phrases. Cela échoue souvent parce qu’une personne peut écrire de façon très régulière et parce qu’un texte produit par machine peut être modifié. Une reformulation, une traduction ou quelques phrases ajoutées peuvent suffire à tromper le contrôle. Si le système bloque automatiquement les textes suspects, il risque aussi de bloquer des messages honnêtes.
La défense doit donc vérifier d’abord l’expéditeur et l’action demandée. Pour les courriels, des signatures permettent de vérifier qu’un domaine autorisé a envoyé le message. Si cette vérification échoue, le message peut être isolé. Si elle réussit, cela ne prouve pas que le message est honnête : le compte de l’expéditeur peut avoir été piraté.
Les demandes sensibles, comme changer un compte bancaire ou envoyer de l’argent, doivent être confirmées par un autre canal et par plusieurs personnes. Les détecteurs de texte peuvent aider à enquêter, mais ils ne doivent pas décider seuls.
À lire aussi
- Fraude au président par voix clonée et visio truquéeContre-mesures de processus contre la fraude au président et l'hameçonnage augmentés par l'IA générative publique (voix clonée, visio truquée, courriels sans fautes).
- Pourquoi le phishing fonctionne malgré la formationL’ingénierie sociale exploite les contraintes humaines et organisationnelles que la formation seule ne neutralise pas.
- Comment former contre le phishing sans culpabiliserFormer sans culpabiliser réduit le phishing quand la formation s'appuie sur des contrôles techniques, des signalements sans sanction et des exercices mesurables.
- Comment contrer le spear phishing et la fraude au présidentLe spear phishing, la fraude au président, le vishing et la fatigue MFA exploitent la confiance et l'urgence pour obtenir un accès initial ou déclencher une action sensible.
Pages voisines
La citent
Détecter le contenu IA malveillant : limites
Elle cite
: les deux pages se citent l’une l’autre.