
Comment organiser une astreinte cybersécurité durable
Comment organiser une astreinte cybersécurité durable
Section intitulée « Comment organiser une astreinte cybersécurité durable »Une astreinte cybersécurité n’est pas un centre de surveillance miniature tenu à bout de bras. C’est un dispositif de décision hors horaires ouvrés, réservé aux événements dont le délai de traitement modifie réellement l’impact métier, la compromission ou la capacité de reprise.
→ Lire l’explication complète de la marmotte
Le compromis de l’astreinte cybersécurité
Section intitulée « Le compromis de l’astreinte cybersécurité »Le compromis central est brutal : réduire le délai de réaction coûte du sommeil, de la concentration et de la disponibilité humaine. Une couverture permanente sans filtrage réduit peut-être quelques minutes de détection, mais augmente les faux positifs, les erreurs de manipulation et le départ des personnes qui connaissent réellement l’environnement. Une équipe épuisée est une surface d’attaque interne parfaitement légitime, avec badge, accès privilégiés et droit de déployer.
La recommandation est de limiter l’astreinte aux incidents dont l’absence d’action avant le prochain créneau ouvré produit un dommage irréversible ou fortement amplifié. Cela couvre typiquement une exfiltration active, un compte administrateur compromis, un chiffrement de masse, une indisponibilité d’un service de sécurité critique ou une fuite de secret encore exploitable. Une alerte de vulnérabilité critique sans exploitation observée n’entre pas automatiquement dans ce périmètre.
Le délai cible doit être séparé en trois mesures. Le délai de prise en compte mesure le temps entre le déclenchement et l’accusé de réception. Le délai de qualification mesure le temps nécessaire pour décider qu’il s’agit d’un incident. Le délai de confinement mesure le temps jusqu’à la première action qui réduit l’impact. Mélanger ces chiffres dans un indicateur de service unique permet surtout de fabriquer un tableau vert pendant qu’un attaquant se promène dans l’annuaire.
Une astreinte viable exige un propriétaire de décision, pas seulement un porteur de téléphone. La personne appelée doit pouvoir isoler un poste, désactiver un compte, bloquer un indicateur réseau ou déclencher une procédure de crise selon des règles préautorisées. Sans ce mandat, l’astreinte devient une chaîne téléphonique coûteuse où l’attaquant attend poliment qu’une réunion soit planifiée.
La conception doit s’appuyer sur l’architecture existante, notamment les dépendances d’identité, de réseau et de journalisation. Les choix de confinement doivent être cohérents avec les mécanismes décrits dans l’architecture cyber et avec la réalité des accès d’administration. Couper le réseau d’un bastion qui héberge les seuls outils de remédiation est une réponse rapide. Elle reste néanmoins embarrassante.
Seuils d’alerte, priorisation et rotation humaine
Section intitulée « Seuils d’alerte, priorisation et rotation humaine »Chaque règle d’alerte doit définir quatre éléments : la condition technique observée, l’impact redouté, l’action attendue hors heures ouvrées et le propriétaire de la décision. Si l’un manque, la règle ne doit pas pager. Elle peut alimenter une file de traitement ouvré, un rapport quotidien ou une détection corrélée, mais pas réveiller quelqu’un.
Une priorité haute ne se déduit pas d’un score fourni par un produit. Les scores des fournisseurs classent des signaux, pas le contexte local. Une authentification suspecte devient prioritaire si elle concerne un compte à privilèges, si elle contourne l’authentification multifacteur (MFA, Multi-Factor Authentication), ou si elle est suivie d’une action d’administration. La même alerte sur un compte désactivé relève généralement du bruit, ce carburant renouvelable de toute plateforme de supervision.
La rotation doit garantir une personne principale et une personne de relève, avec une escalade nominative après un délai fixé. La relève ne doit pas découvrir l’environnement au moment de l’appel : mêmes accès, mêmes procédures, mêmes canaux sécurisés et mêmes droits d’urgence. Une rotation sans relève réellement capable n’est pas une redondance, c’est une liste de numéros décorative.
Fixer une durée maximale de garde consécutive et un temps de récupération après intervention nocturne. La règle doit être contractuelle ou interne, écrite et appliquée, pas laissée à la bonne volonté. Une intervention longue à deux heures du matin ne se compense pas avec un emoji reconnaissant dans un canal de discussion. Le repos est un contrôle de sécurité : il réduit les décisions irréversibles prises avec un cerveau fonctionnant en mode économie d’énergie.
Mesurer mensuellement le volume de pages, le taux de pages actionnables, les escalades, les interventions nocturnes et les alertes supprimées après analyse. Une règle qui ne déclenche jamais mérite une revue. Une règle qui déclenche souvent sans action immédiate mérite d’être retirée de l’astreinte. La surveillance n’est pas une collection de Pokémon : accumuler les alertes ne donne aucun avantage.
Surface d’attaque de l’astreinte et accès d’urgence
Section intitulée « Surface d’attaque de l’astreinte et accès d’urgence »L’astreinte concentre des privilèges et des canaux de communication à un moment où l’attention est basse. C’est donc une cible. Le premier vecteur est le hameçonnage par alerte : un attaquant envoie une notification crédible contenant un lien vers un faux portail, puis collecte les identifiants de l’astreinte. Le second est l’usurpation de canal : appel vocal, messagerie ou ticket imitant une escalade légitime. Le troisième est l’abus du compte d’urgence, souvent peu surveillé parce qu’il est censé ne servir qu’en cas de catastrophe. Les catastrophes apprécient cette discrétion.
Les notifications doivent contenir un identifiant d’incident, un résumé non sensible et un lien vers un domaine connu, jamais un lien arbitraire issu de l’événement. L’ouverture du dossier doit imposer une authentification forte et résistante au hameçonnage lorsque la plateforme le permet. Un code reçu par message court reste préférable à rien, mais ne protège pas contre un relais en temps réel ou une fraude à la carte SIM.
Les comptes d’astreinte doivent être individuels. Les comptes partagés empêchent l’attribution, rendent la révocation imprécise et transforment chaque changement d’équipe en archéologie des mots de passe. Prévoir un compte de secours distinct, à privilèges minimaux, dont l’usage déclenche une alerte et une revue a posteriori. Les procédures d’accès privilégié doivent s’articuler avec les contrôles décrits dans la section identités.
Les actions de confinement à fort impact nécessitent des garde-fous techniques : double validation pour la révocation globale de certificats, périmètre limité pour les règles de blocage réseau, durée d’expiration automatique pour un isolement, journal d’audit immuable pour les actions administratives. Un jeton qui peut désactiver toute l’authentification fédérée à trois heures du matin est un scénario de reprise, pas un privilège quotidien.
L’astreinte ne garantit pas la détection d’une compromission silencieuse, l’intégrité des journaux déjà altérés ni la disponibilité des fournisseurs externes. Elle ne remplace ni la segmentation réseau, ni la gestion des vulnérabilités, ni la sauvegarde, ni les exercices de réponse à incident. Elle réduit le temps entre un signal qualifié et une décision. C’est déjà beaucoup. Ce n’est pas de la magie vendue sur fond violet.
Routage des alertes d’astreinte
Section intitulée « Routage des alertes d’astreinte »Le routage doit empêcher qu’une alerte critique sans contexte réveille l’astreinte, tout en évitant qu’un incident qualifié soit perdu dans une file générale. Le schéma suivant en montre le principe, tel qu’on le configure par exemple avec Alertmanager, le composant de routage d’alertes de Prometheus : les règles amont ajoutent aux alertes des libellés urgence, service et runbook, sur lesquels le routage s’appuie.
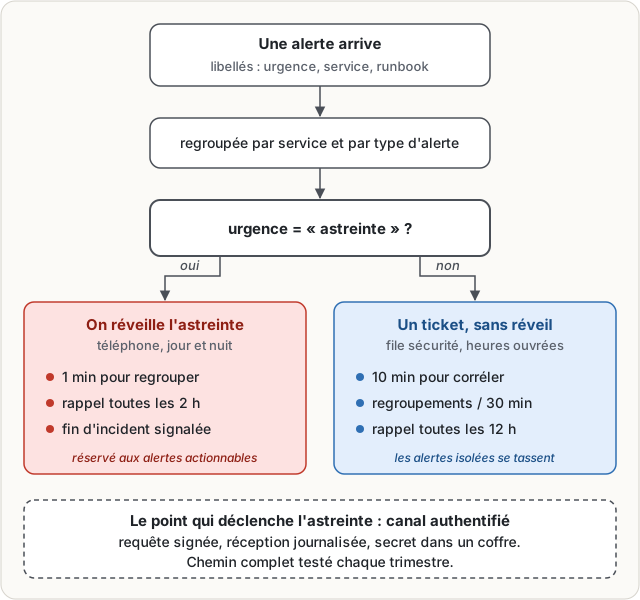
Le point de terminaison de pagination doit être accessible par un canal authentifié, journaliser la réception et rejeter les requêtes non signées. Ne pas exposer un webhook de déclenchement sur Internet avec un secret statique copié dans une variable d’environnement partagée. Cette variante finit tôt ou tard dans un historique, un export ou une capture d’écran. Les secrets de routage doivent être stockés dans un gestionnaire de secrets, limités au service émetteur et renouvelés après chaque suspicion de fuite.
Tester chaque trimestre le chemin complet : génération du signal, corrélation, réception, authentification, accès aux consoles, confinement et retour à la normale. Le test doit inclure une défaillance du fournisseur de pagination et une indisponibilité du système de gestion des identités. Une procédure qui exige l’accès au système indisponible pour rétablir ce système mérite une place au musée des dépendances circulaires.
Exploitation, secrets, sauvegarde et reprise
Section intitulée « Exploitation, secrets, sauvegarde et reprise »Une astreinte fonctionne seulement si les journaux nécessaires restent disponibles. Définir une rétention compatible avec le délai de découverte attendu, protéger les journaux contre l’effacement par un compte compromis et synchroniser les horloges. Un événement sans horodatage fiable est difficile à corréler, et un journal modifiable par l’attaquant est un récit dont l’auteur choisit la fin.
Les clés, jetons d’interface de programmation et certificats utilisés par les outils d’astreinte doivent avoir un inventaire, un propriétaire et une date de rotation. La rotation d’un secret de notification doit vérifier les consommateurs secondaires : outil de supervision, automatisation de crise, environnement de reprise et intégrations de ticketing. Révoquer le secret avant d’avoir migré ces dépendances fabrique une panne silencieuse, particulièrement élégante parce que plus aucune alerte ne le signale.
Sauvegarder les configurations de routage, les procédures, les listes d’escalade et les journaux d’audit dans un emplacement séparé de la plateforme supervisée. Restaurer une sauvegarde doit inclure les droits d’accès, les certificats de service et les dépendances de résolution de noms. Restaurer seulement le fichier de configuration revient à reconstruire un détecteur de fumée en oubliant les piles.
Les procédures doivent préciser le seuil de déclaration d’incident, les personnes habilitées à communiquer vers l’extérieur et les éléments à préserver. L’astreinte ne rend pas de conseil juridique et ne décide pas seule d’une notification réglementaire. Pour relier les décisions techniques à la gouvernance, les principes de gestion des risques et gouvernance servent de cadre, pas de script récité sous pression.
🐝 Ce qui arrive si on s’en passe
Section intitulée « 🐝 Ce qui arrive si on s’en passe »Sans dispositif d’astreinte structuré, les fenêtres non ouvrées deviennent prévisibles : un chiffrement lancé le vendredi soir dispose de soixante heures avant la première décision humaine, durée suffisante pour parcourir les partages et les sauvegardes accessibles en ligne. L’absence de mandat préautorisé reporte la désactivation d’un compte à privilèges compromis, laissant le temps d’installer une persistance qui survivra au confinement du lundi. Les journaux utiles peuvent expirer avant toute analyse lorsque la rétention est plus courte que le délai de découverte réel, ce qui supprime la possibilité de reconstituer le chemin d’intrusion. Les interventions improvisées menées de nuit sur des comptes partagés privent l’audit de toute attribution fiable. Enfin, les délais réglementaires de notification courent à partir de la connaissance des faits, indépendamment de la disponibilité des équipes.
🦫 Explication de la marmotte 🍫
Section intitulée « 🦫 Explication de la marmotte 🍫 »Une astreinte cybersécurité organise la réaction à des problèmes graves en dehors des horaires habituels. Elle ne doit pas traiter toutes les alertes. Avant de commencer, il faut choisir les situations qui exigent une action immédiate, par exemple le vol en cours de données, le contrôle d’un compte très puissant ou le blocage d’un service nécessaire à la sécurité.
Chaque alerte retenue doit dire ce qui a été détecté, pourquoi cela peut être grave, quelle première action est autorisée et qui décide. Une personne de garde reçoit l’alerte, vérifie qu’elle correspond à un vrai incident, puis applique une action prévue : couper un accès, bloquer une communication ou désactiver un compte. Une seconde personne doit pouvoir prendre le relais si la première ne répond pas.
Les accès utilisés pendant la garde doivent être personnels, protégés par plusieurs preuves d’identité et enregistrés. Les faux messages, les faux appels et le vol de mots de passe visent souvent ces accès. Les messages d’alerte ne doivent donc pas demander de saisir un mot de passe sur un lien inconnu.
Enfin, il faut vérifier régulièrement que les alertes arrivent, que les personnes peuvent se connecter et que les procédures fonctionnent même si un outil tombe en panne. Si les alertes réveillent souvent quelqu’un sans action nécessaire, elles doivent être modifiées ou retirées. Le repos fait partie du dispositif : une personne épuisée prend moins bien les décisions urgentes.
À lire aussi
- Pourquoi la dernière heure de garde échoueLa fatigue de vigilance rend la dernière heure de garde dangereuse et impose des contrôles d’exploitation qui ne reposent pas sur la mémoire humaine.
- Pourquoi un analyste SOC rate une alerte critiqueCharge cognitive en SOC : comprendre pourquoi une alerte critique échappe à l’analyste et comment concevoir une détection exploitable.
- Saturation d'une équipe de sécurité : une panne d'architectureUne équipe de sécurité saturée est le symptôme d'une organisation mal conçue : files sans limite, alertes non actionnables, décisions sans propriétaire.
- Réduire l’alert fatigue sans perdre la détectionL’alert fatigue survient lorsque le volume et le bruit des alertes rendent la détection des incidents moins fiable.
Pages voisines
La citent
- Pourquoi la dernière heure de garde échoue
- Saturation d'une équipe de sécurité : une panne d'architecture
- Monter un CSIRT interne, missions, services FIRST et rattachement
- SOC centre des opérations de sécurité : rôle, organisation, mesure
Comment organiser une astreinte cybersécurité durable
Elle cite