
Saturation d'une équipe de sécurité : une panne d'architecture
Saturation d’une équipe de sécurité : une panne d’architecture
Section intitulée « Saturation d’une équipe de sécurité : une panne d’architecture »Une équipe de cybersécurité sature quand l’organisation transforme l’incertitude, l’urgence et la dette technique en charge permanente. Le problème ne se corrige pas en demandant aux analystes de tenir plus longtemps : il se corrige en modifiant les flux d’alertes, les responsabilités, les accès et les décisions qui absorbent toute la capacité de l’équipe.
→ Lire l’explication complète de la marmotte
La saturation commence par une file d’attente sans limite
Section intitulée « La saturation commence par une file d’attente sans limite »Une équipe de cybersécurité ne sature pas parce que le métier serait intrinsèquement héroïque. Elle sature lorsqu’elle reçoit une demande infinie, avec une capacité finie, sans mécanisme explicite de rejet, de priorisation ou d’arrêt. Une boîte partagée où tout sujet est marqué « urgent » est une file d’attente non bornée déguisée en messagerie.
Le compromis central est brutal : accepter toute sollicitation donne une impression de réactivité immédiate, mais détruit la capacité à traiter les risques majeurs et à améliorer le système. Refuser, différer ou rediriger des demandes crée de la friction locale, mais protège la disponibilité cognitive nécessaire aux investigations, aux revues d’architecture et aux incidents réels. Il faut choisir la seconde option dès lors que l’équipe porte une responsabilité de sécurité opérationnelle.
Un centre opérationnel de sécurité, ou SOC (Security Operations Center), qui traite les alertes de production ne doit pas être le guichet général des demandes de conformité, des audits improvisés et des exceptions IAM (Identity and Access Management, gestion des identités et des accès). Mélanger ces flux casse la mesure de capacité. Une alerte de compromission, une demande d’ouverture de pare-feu et une relance de questionnaire fournisseur ne consomment ni les mêmes compétences ni le même délai de réponse.
La règle est donc de séparer au moins quatre files :
- les incidents avérés, avec une permanence et une procédure d’escalade ;
- les alertes à qualifier, avec un seuil de rejet documenté ;
- les changements planifiés, soumis à une capacité de livraison ;
- les demandes d’exception, portées par le propriétaire du risque et non par l’analyste qui les reçoit.
Sans propriétaire identifié, une exception est refusée par défaut. Ce n’est pas de la rigidité bureaucratique : c’est empêcher qu’un ticket sans décideur devienne une dette assignée au premier analyste encore connecté.
Vingt ans de métier apprennent que l’alerte « critique » reçue chaque matin n’est généralement pas critique. Elle est surtout très persistante, ce qui n’est pas une qualité morale.
Surface d’attaque organisationnelle et fatigue d’alerte
Section intitulée « Surface d’attaque organisationnelle et fatigue d’alerte »La fatigue d’alerte est une vulnérabilité exploitable. Un attaquant n’a pas besoin de contourner chaque contrôle si l’équipe qui surveille les contrôles reçoit plusieurs centaines de signaux non actionnables. La dilution du signal réduit la probabilité qu’une alerte réellement malveillante soit investiguée dans le délai utile.
Les attaques connues contre l’attention suivent des mécanismes prévisibles :
- le bruit de télémétrie : règles de détection trop larges, événements dupliqués, absence de déduplication ;
- l’escalade artificielle : sévérité maximale attribuée par défaut pour éviter de décider ;
- l’urgence permanente : changements de dernière minute, vulnérabilités annoncées sans exposition vérifiée ;
- la dépendance à une personne : connaissance de production non documentée, comptes d’administration nominatifs sans relais ;
- le contournement de processus : sollicitation directe d’un analyste pour éviter une validation ou une traçabilité.
La contre-mesure n’est pas de demander aux personnes de « mieux prioriser ». Le système doit fournir une décision exploitable. Chaque détection doit indiquer l’actif concerné, le scénario de menace, la sévérité attendue, le propriétaire de l’actif, la première action de qualification et les conditions de clôture. Une alerte sans action prescrite est une télémétrie, pas une détection.
Le taux de faux positifs doit être mesuré par règle, pas seulement au niveau global du SOC. Une règle générant 95 % de faux positifs peut rester justifiée si elle couvre une technique à fort impact et si sa qualification prend moins de deux minutes. La même règle devient nocive si elle impose une collecte manuelle, une consultation de cinq consoles et une escalade systématique. Le nombre d’alertes n’est pas une métrique de sécurité. C’est parfois une métrique de désespoir avec un tableau de bord.
La cartographie des menaces doit aussi guider l’effort humain. Une vulnérabilité publiée n’est pas automatiquement un incident. Avant d’ouvrir une cellule de crise, vérifier l’exposition réelle, la version déployée, la présence d’un chemin exploitable, les contrôles compensatoires et la valeur de l’actif. Cette qualification doit être industrialisée dans l’inventaire et la gestion de configuration, pas reconstruite à chaque panique collective.
Responsabilités, astreinte et droit au non
Section intitulée « Responsabilités, astreinte et droit au non »L’astreinte est une capacité de traitement d’incident hors horaires, pas une extension gratuite de la journée de travail. Sa conception doit préciser les services couverts, les événements déclencheurs, le délai de prise en compte, les moyens d’accès, l’escalade et la sortie de crise. Sans ces éléments, l’astreinte devient une disponibilité vague. La disponibilité vague finit toujours par sonner à 02:17 pour un certificat expirant sur un environnement de démonstration.
Une matrice RACI (Responsible, Accountable, Consulted, Informed) doit désigner qui exécute, qui décide, qui est consulté et qui est informé. Le piège classique consiste à rendre l’équipe sécurité responsable de la correction d’un défaut applicatif, alors qu’elle ne possède ni le code ni la fenêtre de changement. L’équipe sécurité doit pouvoir exiger, vérifier et escalader. Elle ne doit pas devenir l’équipe de réparation universelle.
Le droit au non découle de cette séparation. Refuser une demande non priorisée, une dérogation sans propriétaire ou une mise en production sans preuves de sécurité est une fonction de contrôle. Le refus doit être traçable, accompagné d’une condition de réexamen et remonté au niveau qui accepte le risque. L’analyste ne doit jamais absorber seul une décision de risque commerciale.
Cette discipline rejoint la gouvernance de la cybersécurité. Une gouvernance qui produit des comités mais n’arbitre pas les risques ne protège personne. Elle ajoute seulement des réunions aux alertes, forme particulièrement élaborée de sabotage.
Mesurer la charge sans surveiller les personnes
Section intitulée « Mesurer la charge sans surveiller les personnes »Mesurer la charge par des indicateurs individuels est une mauvaise idée : cela pousse au contournement, masque les difficultés et transforme un défaut de conception en score personnel. Mesurer le système est plus fiable. Les métriques doivent décrire le travail entrant, le travail interrompu et la capacité de résolution.
Suivre au minimum :
- le volume d’alertes par source et par règle ;
- le taux de clôture sans action et le taux de réouverture ;
- le délai entre détection et qualification ;
- le nombre d’interruptions hors astreinte ;
- la proportion de changements urgents ;
- le nombre de services sans propriétaire ou sans procédure de reprise ;
- la part du temps consacrée à la réduction de dette de détection.
Un objectif de niveau de service, ou SLO (Service Level Objective), peut encadrer les alertes actionnables : par exemple, qualifier 90 % des alertes de sévérité haute dans le délai défini par le scénario de menace. Il ne faut pas fixer un SLO sur « toutes les alertes ». Cela récompense la clôture rapide, pas l’investigation juste.
Ces indicateurs ne remplacent ni l’encadrement, ni l’arbitrage des priorités, ni le droit au repos. Ils rendent toutefois visible une cause organisationnelle que les discours sur l’effort individuel préfèrent souvent laisser sous le tapis. Le tapis est rarement homologué pour la gestion des incidents.
Exemple de supervision de la surcharge d’alertes
Section intitulée « Exemple de supervision de la surcharge d’alertes »Une règle d’alerte peut détecter une hausse durable des alertes ouvertes. Prometheus, un outil de collecte et d’évaluation de métriques, l’évalue à partir d’un compteur d’alertes ouvertes exposé par le SIEM (Security Information and Event Management, plateforme de centralisation et d’analyse des événements) ou par un exporteur interne.
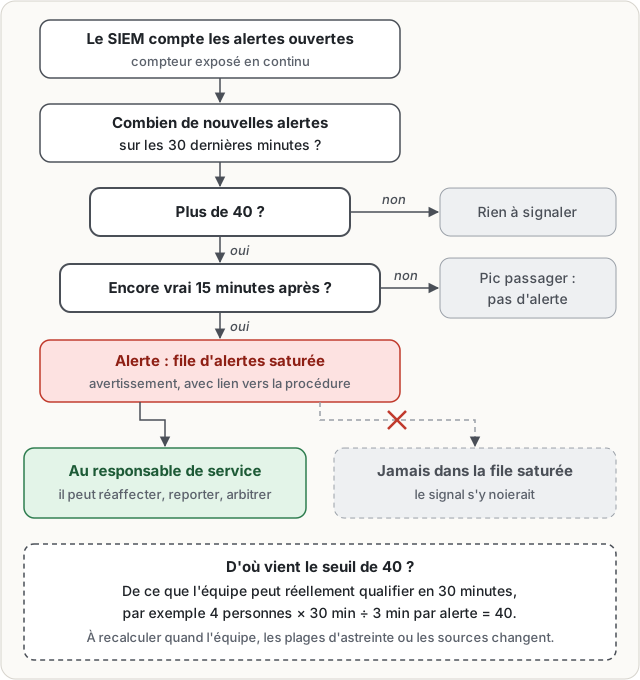
Le seuil de 40 n’est pas une constante magique tombée d’une slide de vendeur. Il doit être calculé à partir de la capacité de qualification, du temps médian par alerte et des plages d’astreinte. L’alerte de saturation doit être routée vers le responsable de service, pas vers la même file déjà saturée. Sinon, le système signale qu’il brûle en ajoutant du bois.
La supervision doit conserver l’historique des règles, des seuils et des changements de source. Une baisse apparente d’alertes peut venir d’une détection désactivée, d’un connecteur cassé ou d’une couverture réellement améliorée. Sans contrôle de fraîcheur des journaux et de volume attendu, un graphique vert peut simplement signifier que le thermomètre est débranché.
Exploitation, secrets et reprise de capacité
Section intitulée « Exploitation, secrets et reprise de capacité »Les secrets d’administration utilisés pendant une investigation doivent être gérés comme des actifs critiques. Un compte partagé, un jeton d’accès longue durée ou une clé privée copiée dans une procédure d’urgence réduit la friction immédiate, puis transforme l’incident suivant en problème d’attribution. Les accès de crise doivent être temporaires, journalisés, révocables et soumis à une revue a posteriori.
La rotation des secrets ne doit pas dépendre d’une mémoire individuelle. Définir un propriétaire, une échéance, une procédure de rotation testée et un mécanisme d’alerte avant expiration. Les procédures d’accès d’urgence doivent fonctionner lorsque le fournisseur d’identité est indisponible, mais elles ne doivent pas permettre un accès permanent hors de tout contrôle. Les architectures décrites dans identités et accès restent le socle de cette séparation.
La reprise ne concerne pas uniquement les systèmes. Elle concerne la capacité de décision. Maintenir des runbooks versionnés, des contacts de service, des chemins d’escalade et des procédures de délégation permet de retirer une personne du circuit sans immobiliser le traitement. Un runbook non testé est une fiction administrative. Une fiction administrative est très reposante, jusqu’à ce qu’elle doive ouvrir une session de secours.
🐝 Ce qui arrive si on s’en passe
Section intitulée « 🐝 Ce qui arrive si on s’en passe »Sans cette architecture, la porte de la ruche reste ouverte aux heures creuses : les intrusions lancées la nuit, le week-end ou en période de congés rencontrent une capacité de qualification réduite qu’aucun seuil ne rend visible. Le départ des analystes emporte la maintenance des règles de détection, qui vieillissent sans propriétaire : la couverture se dégrade sans qu’aucun indicateur ne le signale. Les clôtures massives d’alertes sans motif ni horodatage utile rendent la chronologie d’un incident irreconstituible a posteriori, ce qui fragilise l’analyse forensique, la notification réglementaire dans les délais imposés et la démonstration du contrôle lors d’un audit. Les exceptions acceptées sans décideur identifié ne laissent aucune trace du risque consenti, donc aucune possibilité de réexamen ni de révocation ultérieure.
🦫 Explication de la marmotte 🍫
Section intitulée « 🦫 Explication de la marmotte 🍫 »Une équipe de cybersécurité peut être saturée par un travail organisé pour ne jamais s’arrêter. Des alertes arrivent, des demandes urgentes s’ajoutent et les mêmes personnes doivent répondre, même quand elles ne possèdent pas les systèmes à corriger. Si aucune règle ne distingue une vraie urgence d’une demande ordinaire, tout devient prioritaire. Alors les personnes interrompent sans cesse leur travail, manquent des signaux graves et accumulent du retard.
Pour réduire ce risque, il faut d’abord séparer les types de demandes : incidents, alertes à vérifier, changements prévus et demandes d’exception. Chaque demande doit avoir un responsable qui décide et un responsable qui agit. Une personne chargée de sécurité peut signaler un danger et vérifier une correction, mais ne doit pas porter seule le risque accepté par une autre direction.
Les outils doivent mesurer le nombre d’alertes, leur qualité et le temps nécessaire pour les traiter. Quand trop d’alertes arrivent, l’organisation doit corriger les règles qui produisent du bruit ou ajouter de la capacité. Les accès d’urgence, les mots de passe sensibles et les procédures doivent aussi être préparés, testés et transmissibles. Si une seule personne détient les informations nécessaires, son absence peut bloquer toute réponse. Le but est de protéger les systèmes sans saturer l’équipe qui les défend.
À lire aussi
- Pourquoi un analyste SOC rate une alerte critiqueCharge cognitive en SOC : comprendre pourquoi une alerte critique échappe à l’analyste et comment concevoir une détection exploitable.
- Pourquoi la dernière heure de garde échoueLa fatigue de vigilance rend la dernière heure de garde dangereuse et impose des contrôles d’exploitation qui ne reposent pas sur la mémoire humaine.
- Comment calibrer les alertes d’un SIEM sans noyer le SOCLa théorie de la détection explique pourquoi un SIEM trop bavard épuise les analystes, tandis qu’un SIEM silencieux masque les menaces réelles.
- Réduire la fatigue d’alerte dans un SOCConcevoir la priorisation, la corrélation et le tiering d’un SOC pour réduire la fatigue d’alerte sans masquer les incidents réels.
Pages voisines
La citent
- Active Directory délégations et chemins d’attaque
- Comment calibrer les alertes d’un SIEM sans noyer le SOC
- Culture de sécurité dans une équipe produit
Saturation d'une équipe de sécurité : une panne d'architecture
Elle cite