
Communiquer un incident à une direction non technique
Communiquer un incident à une direction non technique
Section intitulée « Communiquer un incident à une direction non technique »Une direction ne finance pas une chronologie de journaux système. Elle doit décider d’une priorité, d’un niveau de risque accepté et des moyens à engager, alors que les faits évoluent encore. La communication d’incident sert à produire ces décisions sans transformer une hypothèse technique en certitude de comité.
→ Lire l’explication complète de la marmotte
Le contrat de communication avec la direction
Section intitulée « Le contrat de communication avec la direction »Le compromis central oppose précision technique et vitesse de décision. Attendre une certitude complète retarde les arbitrages coûteux, notamment l’arrêt d’un service, l’activation d’un plan de reprise ou la mobilisation d’un prestataire. Communiquer trop tôt avec des affirmations fragiles crée l’effet inverse : une direction apprend à ignorer les alertes, puis découvre que le risque était réel quand il est déjà trop tard.
La position à tenir est nette : communiquer tôt, mais séparer systématiquement les faits, les hypothèses et les décisions demandées. Un message exécutif ne doit jamais masquer l’incertitude derrière des formules de consultant sous caféine. « Exfiltration confirmée » et « accès non autorisé observé, exfiltration non confirmée » entraînent des obligations, des coûts et des actions radicalement différents.
Le premier message doit répondre à cinq questions :
- Quel actif métier est affecté, et quelle fonction devient indisponible ou risquée ?
- Quel impact est confirmé sur la disponibilité, l’intégrité ou la confidentialité ?
- Quelle est la portée connue, exprimée en services, populations et données, pas en noms de serveurs ?
- Quelles mesures de confinement sont déjà prises, et quel effet métier produisent-elles ?
- Quelle décision est attendue, de qui, et avant quelle heure ?
Une demande de décision sans propriétaire ni échéance produit une réunion. Une réunion sans décision produit un compte rendu. Les comptes rendus sont très résistants aux ransomwares, mais ne rétablissent aucun service.
L’exécutif n’a pas besoin du détail d’une règle de pare-feu ou d’un indicateur de compromission. En revanche, il doit savoir qu’isoler un environnement de production peut interrompre les flux de commande, que repousser cette isolation augmente la fenêtre d’exposition, et que l’équipe technique recommande une option. La recommandation doit être explicite. Une direction n’est pas là pour deviner laquelle des trois options en bas de slide est réellement défendue.
La communication d’incident doit rester raccordée à la gouvernance de la cybersécurité : registre des risques, propriétaires de services, seuils d’escalade et pouvoir de déclencher la continuité. Sans ces éléments définis avant l’incident, chaque message devient une négociation de périmètre. C’est un mauvais moment pour découvrir que personne ne possède officiellement l’application qui facture.
Le message exécutif et la qualification de l’impact
Section intitulée « Le message exécutif et la qualification de l’impact »L’impact doit être traduit dans le vocabulaire du métier, tout en conservant une trace technique vérifiable. Dire que « le cluster est dégradé » informe l’équipe plateforme. Dire que « la saisie des commandes est indisponible pour les canaux exposés » permet d’arbitrer. Les deux phrases peuvent coexister, mais pas dans le même niveau de lecture.
Utiliser trois états de preuve :
- Confirmé : observation horodatée, source identifiable, preuve conservée. Exemple : un compte de service a ouvert une session sur un système où il n’est pas autorisé.
- Probable : plusieurs signaux convergent, sans preuve suffisante pour conclure. Exemple : une archive inhabituelle a été créée avant une connexion sortante.
- Inconnu : investigation en cours ou télémétrie indisponible. Exemple : les journaux d’un composant ont été purgés ou ne couvrent pas la période étudiée.
Ces états ne sont pas des précautions de langage. Ils déterminent le niveau de réponse. Une fuite de données confirmée peut imposer des notifications réglementaires, notamment au titre du RGPD (Règlement général sur la protection des données). Une fuite seulement suspectée impose d’accélérer la qualification, pas de déclarer publiquement une violation. L’analyse juridique appartient aux fonctions compétentes ; l’architecture doit fournir les preuves, les limites de preuve et les délais techniques.
Éviter les métriques décoratives. Le nombre d’alertes, de machines examinées ou de règles ajoutées ne mesure pas le risque métier. Préférer une portée bornée : « le service d’identité externe est indisponible », « les sauvegardes de la base de données contiennent potentiellement l’artefact malveillant », « les données de facturation ne présentent pas de modification confirmée à cette étape ».
Une estimation financière peut être nécessaire, mais elle doit porter une méthode et une marge. Additionner le chiffre d’affaires journalier à chaque minute d’arrêt donne un tableau spectaculaire et faux : tous les processus ne s’arrêtent pas au même instant, les retards ne deviennent pas tous des pertes, et certaines charges se déplacent. La finance doit chiffrer les conséquences, la sécurité doit borner les scénarios techniques.
Cadence, canal et journal de décision
Section intitulée « Cadence, canal et journal de décision »La cadence ne doit pas suivre le rythme des alertes. Un système de détection peut générer vingt événements en une minute ; une direction ne peut pas arbitrer vingt fois en une minute sans finir par voter pour l’extincteur. Définir une fréquence initiale, puis ne la modifier qu’en cas de changement matériel : confirmation d’exfiltration, propagation observée, perte de sauvegarde, indisponibilité d’un service critique ou décision attendue.
Le premier point de situation doit contenir l’heure de référence, même si l’heure de début de compromission reste inconnue. Distinguer explicitement :
- heure de détection ;
- heure du premier comportement suspect identifié ;
- heure de confinement ;
- heure de la prochaine mise à jour.
Cette séparation évite un piège classique : annoncer une durée d’incident calculée depuis l’alerte alors que l’intrusion a peut-être commencé plus tôt. La durée connue n’est pas la durée réelle. Cette phrase mérite d’être écrite, pas laissée à l’interprétation.
Un canal de crise doit être préétabli, authentifié et accessible si l’annuaire d’entreprise ou la messagerie sont affectés. Prévoir une liste de contacts hors du système d’information, un moyen d’appel alternatif et un espace de partage dont les droits sont revus. Un canal créé pendant l’incident hérite souvent des comptes compromis, des redirections de messagerie et des membres ajoutés dans la panique. Le chaos apprécie les invitations ouvertes.
Le journal de décision est distinct du journal technique. Il enregistre la décision, le décideur, l’heure, l’option retenue, le risque accepté et la prochaine condition de réévaluation. Il protège autant l’exploitation que la gouvernance : restaurer une sauvegarde contaminée parce qu’une consigne orale a été mal comprise n’est pas une défaillance de restauration, c’est une défaillance de traçabilité.
Les mécanismes d’identité comptent particulièrement pendant une crise. Une compromission d’annuaire peut invalider les accès d’administration, les comptes de secours et les canaux de validation. Les dépendances doivent être connues avant l’incident, notamment celles décrites dans les sujets d’identités et fédération. Révoquer un compte ne met pas fin aux sessions déjà établies ni aux jetons émis avant la révocation ; la communication ne doit donc jamais annoncer « accès bloqué » sans préciser quel mécanisme a été vérifié.
Exemple de point de situation direction
Section intitulée « Exemple de point de situation direction »Le format suivant produit un message lisible et vérifiable. Il ne remplace pas l’outil de gestion de crise ; il force surtout la distinction entre preuve, impact et décision.
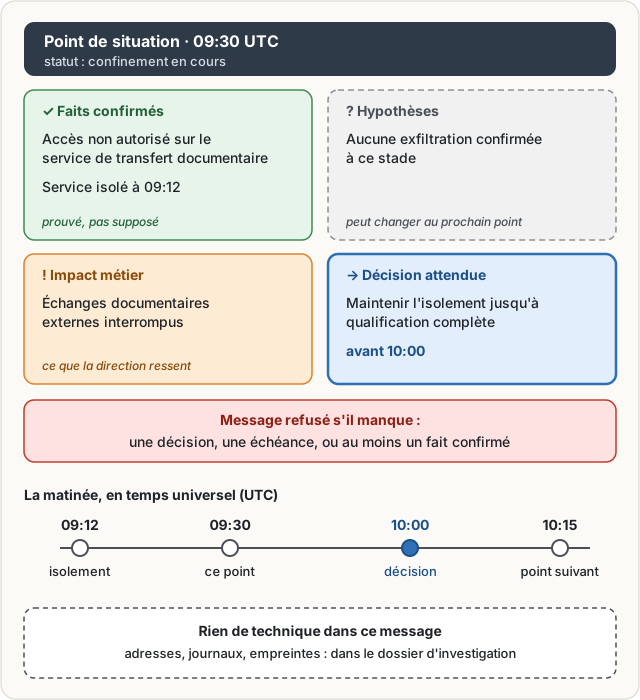
Le message transmis peut reprendre ce contenu en prose, sans modifier les faits. L’horodatage doit être en temps universel coordonné, noté UTC (Coordinated Universal Time), afin d’éviter les ambiguïtés entre équipes, prestataires et sites. Les pièces techniques, telles que les empreintes de fichiers, les adresses réseau et les extraits de journaux, restent dans le dossier d’investigation avec un contrôle d’accès restreint.
Surface d’attaque de la communication d’incident
Section intitulée « Surface d’attaque de la communication d’incident »La communication est elle-même une surface d’attaque. Un adversaire ayant accès à la messagerie peut observer les mesures de confinement, détourner une demande de validation ou diffuser une fausse instruction de reprise. La contre-mesure n’est pas de chiffrer compulsivement chaque phrase dans un format impraticable : c’est de disposer d’un canal alternatif, d’authentifier les décisions sensibles par un second moyen et de limiter la diffusion aux personnes ayant un rôle dans la crise.
Les détails techniques envoyés à une large liste aggravent aussi le risque. Une liste d’adresses internes, une vulnérabilité non corrigée, un secret, une copie de journal contenant un jeton d’accès ou le nom d’un compte d’administration n’ont aucune place dans un point de direction. Le principe est identique à celui de la gestion des secrets en développement et CI/CD : un canal de confiance ne transforme pas un secret en information publique.
Le risque inverse existe : un message trop aseptisé peut empêcher la direction de comprendre l’urgence. La parade consiste à exposer la conséquence métier et le scénario redouté, pas la recette d’exploitation. « Un acteur non autorisé peut modifier des coordonnées de paiement » est actionnable. « Vulnérabilité dans un composant version 4.2.1 » ne l’est pas, sauf pour l’équipe qui corrige.
La communication ne garantit ni l’absence d’exfiltration, ni l’éradication de l’attaquant, ni la validité d’une sauvegarde, ni la conformité réglementaire. Ces garanties viennent respectivement de l’investigation, de la remédiation, des tests de restauration et des fonctions juridiques. Un bon message décrit ce qui manque pour conclure. Il ne comble pas le vide avec de l’optimisme, cette forme de compression de données qui perd précisément les octets gênants.
Exploitation, conservation et retour contrôlé
Section intitulée « Exploitation, conservation et retour contrôlé »Le dispositif doit exister avant l’incident : modèle de point de situation, liste de décisionnaires, canal de secours, classification des services et propriétaire nommé pour chaque service critique. Tester ce dispositif lors d’exercices centrés sur une décision réelle, par exemple maintenir une isolation qui dégrade une fonction métier ou restaurer sous condition. Un exercice qui conclut toujours par « bonne coordination » n’évalue rien, à part la résistance des participants aux biscuits de salle de réunion.
Les messages, décisions et preuves associées doivent être conservés avec des horodatages cohérents et une rétention définie. L’accès doit être journalisé, car le dossier de crise contient souvent des éléments recherchés par un attaquant : topologie, faiblesses, comptes concernés et état des sauvegardes. Les sauvegardes du dossier doivent être séparées du système potentiellement compromis, sinon la chronologie disparaît exactement quand elle devient nécessaire.
La rotation des secrets intervient aussi dans la communication. Si un compte de messagerie, une clé d’accès à un espace documentaire ou un jeton d’interface de programmation est exposé, invalider le secret, vérifier les sessions persistantes et actualiser les accès du canal de crise. La rotation sans vérification des sessions laisse un accès actif derrière une porte dont la serrure vient seulement d’être changée.
🐝 Ce qui arrive si on s’en passe
Section intitulée « 🐝 Ce qui arrive si on s’en passe »Sans format de point de situation préétabli, l’écart entre ce qui est observé et ce qui est affirmé n’est plus mesurable : un même incident circule en plusieurs versions entre exploitation, prestataires et direction, et la version la plus rassurante finit par servir de référence. Les horloges divergentes (heure locale contre UTC) rendent la chronologie inutilisable pour une notification réglementaire soumise à délai, pour une déclaration d’assurance ou pour un retour d’expérience. Faute de journal de décision, un risque accepté oralement redevient un défaut d’exploitation quelques semaines plus tard, sans trace du décideur ni de la condition de réévaluation. Les arbitrages coûteux (isolement, reprise, mobilisation externe) sont alors rejoués à chaque réunion, ce qui allonge la fenêtre d’exposition sans produire de choix opposable. Un canal improvisé pendant la crise offre en prime à un attaquant présent dans la messagerie une vue directe sur les mesures de confinement.
🦫 Explication de la marmotte 🍫
Section intitulée « 🦫 Explication de la marmotte 🍫 »Quand un incident informatique est détecté, les équipes cherchent d’abord à savoir ce qui est réellement arrivé. Elles regardent les traces laissées par les connexions, les fichiers modifiés et les services arrêtés. Pendant ce temps, la direction doit parfois décider rapidement : couper un service, accepter une interruption, appeler une aide extérieure ou prévenir certaines personnes.
Le message envoyé à la direction doit distinguer trois choses. Les faits sont ce qui a été observé et vérifié. Les hypothèses sont ce qui semble possible mais n’est pas encore prouvé. Les décisions demandées sont les choix qui ne peuvent pas attendre la fin de l’enquête. Chaque message indique aussi l’heure des informations et l’heure prévue pour la prochaine mise à jour.
Les détails permettant d’attaquer les systèmes ne doivent pas circuler largement. Ils restent dans le dossier réservé aux personnes qui enquêtent. Les décisions, elles, sont notées avec le nom de la personne qui les prend et la raison du choix. Cela évite de relancer un système trop tôt ou de perdre la trace d’un risque accepté.
Si la messagerie ou les comptes d’accès sont touchés, un autre moyen de communication doit être disponible. Enfin, annoncer qu’un accès a été bloqué ne prouve pas que l’intrus est parti : une connexion déjà ouverte peut continuer. Les équipes doivent vérifier, corriger et surveiller avant d’affirmer que l’incident est terminé.
À lire aussi
- Communiquer pendant un incident et mener un retexCommuniquer une crise de sécurité sans masquer l'incertitude, puis conduire un retour d'expérience qui corrige les causes systémiques.
- Délais de notification d’incident NIS2 RGPD DORADélais réglementaires, qualification et obligations pratiques pour notifier un incident de cybersécurité.
- Gérer un désaccord technique sans bloquer un projetGérer un désaccord technique sans faire capoter un projet exige de transformer les opinions en décisions traçables, testables et exploitables.
- Biais cognitifs en investigation de sécuritéLes biais cognitifs qui faussent une investigation de sécurité, leurs contre-mesures et les conditions d'exploitation d'une analyse défendable.
Pages voisines
La citent
- Reconstruire une timeline d'attaque après incident
- Zero Trust marketing ou sécurité réellement vérifiée
Communiquer un incident à une direction non technique
Elle cite
: les deux pages se citent l’une l’autre.