
Spectre et Meltdown : exécution spéculative et fuite par cache
Spectre et Meltdown : exécution spéculative et fuite par cache
Section intitulée « Spectre et Meltdown : exécution spéculative et fuite par cache »En janvier 2018, Spectre (CVE-2017-5753, CVE-2017-5715) et Meltdown (CVE-2017-5754) ont montré qu’un processeur peut divulguer des données qu’aucune instruction n’a officiellement lues. Le calcul spéculatif est annulé, mais sa trace dans le cache survit, et une mesure de temps suffit à la relire. La leçon dépasse le correctif : la frontière d’isolation logicielle repose sur un matériel qui ne la respecte pas entièrement.
→ Lire l’explication complète de la marmotte
Exécution spéculative et cache : le mécanisme commun
Section intitulée « Exécution spéculative et cache : le mécanisme commun »Un CPU (Central Processing Unit) moderne n’attend pas de connaître le résultat d’un test pour avancer. Face à un branchement conditionnel, il parie sur la branche probable et exécute la suite par anticipation ; face à un accès mémoire soumis à vérification de droits, il peut lancer le chargement avant que la vérification aboutisse. Si le pari est perdu, les registres sont restaurés et le programme ne voit rien. Sur le plan architectural, rien ne s’est passé.
Sur le plan microarchitectural, en revanche, beaucoup de choses se sont passées. Les lignes de cache chargées pendant l’exécution annulée restent dans le cache. Le CPU nettoie ses registres, pas son cache : il range la vaisselle et laisse la nappe tachée.
Or l’état du cache se mesure. Une donnée présente en cache L1 se lit en quelques cycles, une donnée en mémoire centrale en plusieurs centaines. La technique Flush+Reload exploite cet écart : on vide une zone de mémoire partagée du cache, on laisse le code spéculatif s’exécuter, puis on chronomètre l’accès à chaque ligne. La ligne rapide révèle l’indice qui a été touché, donc la valeur secrète qui servait d’indice. La fuite ne passe par aucun appel système, aucun fichier, aucun journal.
Le schéma suivant montre l’ordre des opérations : l’accès interdit et l’annulation se produisent, mais la trace en cache traverse l’annulation.
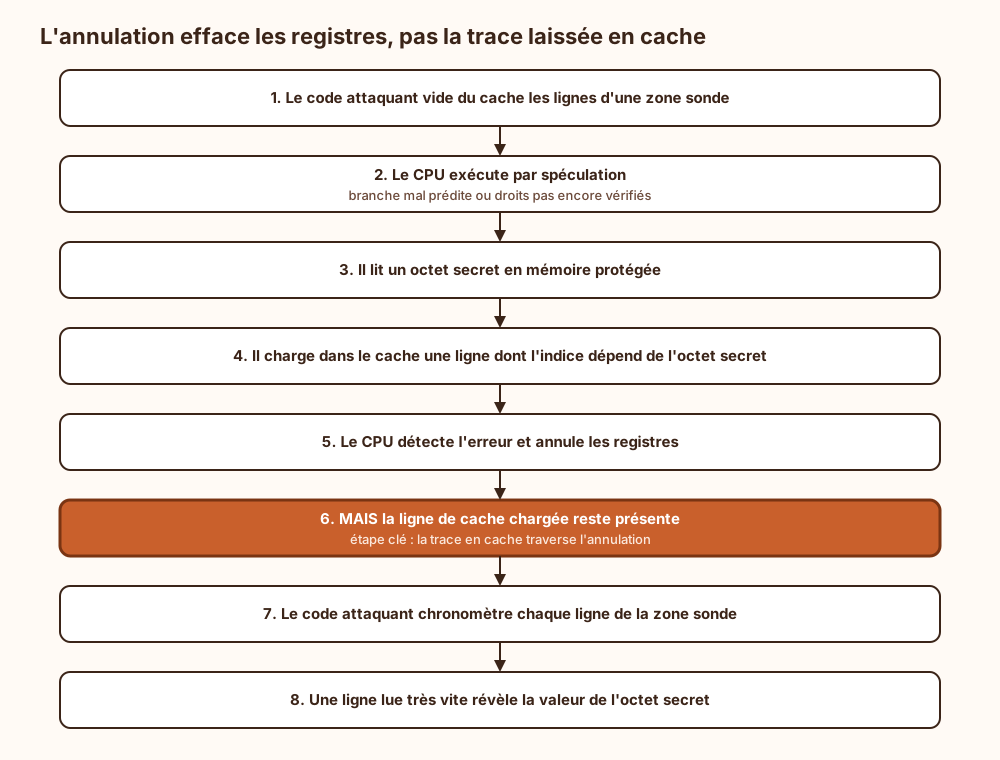
Ce mécanisme est un canal auxiliaire temporel, la même famille que les fuites de temps d’exécution en cryptographie décrites dans Quand l’implémentation parle. La différence tient à l’échelle : ici, la fuite ne vient pas d’un code crypto mal écrit, mais de l’optimisation centrale de tous les processeurs haute performance des vingt dernières années.
Meltdown, Spectre v1 et Spectre v2 : trois variantes, trois frontières franchies
Section intitulée « Meltdown, Spectre v1 et Spectre v2 : trois variantes, trois frontières franchies »Les trois CVE (Common Vulnerabilities and Exposures) partagent le canal de lecture mais diffèrent par ce qui est contourné.
Meltdown (variante 3, CVE-2017-5754, « rogue data cache load »). Sur les processeurs touchés, la vérification de privilège d’une lecture mémoire arrive après que la donnée a été transmise aux instructions suivantes. Un processus ordinaire peut donc lire spéculativement une adresse noyau, à condition qu’elle soit mappée dans son espace d’adressage, ce qui était le cas sur tous les systèmes d’exploitation courants, pour des raisons de performance. Résultat : lecture de la mémoire du noyau, et par extension de toute la mémoire physique que le noyau mappe. Les processeurs Intel de l’époque étaient touchés, ainsi que certains cœurs ARM et IBM POWER ; les processeurs AMD ne l’étaient pas. Meltdown est une faille du matériel au sens strict, et sa correction logicielle ne fait que retirer au processeur l’occasion de la commettre.
Spectre v1 (CVE-2017-5753, « bounds check bypass »). Le code victime contient un test de bornes du type « si l’indice est inférieur à la taille, lire le tableau ». L’attaquant entraîne le prédicteur à prévoir « vrai », puis fournit un indice hors bornes : le CPU lit spéculativement au-delà du tableau avant que le test ne le rattrape. Ce n’est pas un défaut d’une gamme de processeurs, c’est la conséquence logique de toute prédiction de branchement. Intel, AMD et ARM sont concernés.
Spectre v2 (CVE-2017-5715, « branch target injection »). L’attaquant empoisonne le BTB (Branch Target Buffer), la table qui prédit la destination des sauts indirects. Comme ce prédicteur est partagé entre contextes (processus, noyau, machines virtuelles sur un même cœur), un contexte peut orienter la spéculation d’un autre vers un fragment de code choisi, appelé gadget, qui fait fuir des données de la victime.
La conséquence d’architecture se résume en une ligne par variante :
| Variante | Frontière franchie | Correction principale |
|---|---|---|
| Meltdown | utilisateur vers noyau | KPTI, puis matériel corrigé |
| Spectre v1 | intérieur d’un même espace d’adressage (sandbox, JIT, noyau) | barrières et masquage d’indices, au cas par cas |
| Spectre v2 | entre processus, entre machines virtuelles, vers le noyau | retpoline, microcode IBRS/IBPB/STIBP, eIBRS |
Spectre v1 est le plus insidieux : il ne demande aucun privilège particulier, uniquement du code attaquant qui s’exécute dans le même processus que la cible. Un navigateur qui exécute du JavaScript tiers coche cette case par définition.
KPTI, retpoline et microcode : ce que coûte chaque contre-mesure
Section intitulée « KPTI, retpoline et microcode : ce que coûte chaque contre-mesure »Le compromis central du sujet tient en une phrase : chaque contre-mesure rachète de l’isolation en rendant au processeur une partie de la performance que la spéculation lui donnait. Le coût n’est pas uniforme, il dépend de la charge, et c’est précisément pour cela que les chiffres publiés en 2018 allaient de négligeable à plusieurs dizaines de pour cent selon les tests.
KPTI (Kernel Page-Table Isolation). Issu du projet de recherche KAISER (Kernel Address Isolation to have Side-channels Efficiently Removed), KPTI sépare les tables de pages : en mode utilisateur, le noyau n’est presque plus mappé. Meltdown n’a plus rien à lire. Le prix se paie à chaque transition utilisateur/noyau (appel système, interruption) par un changement de tables de pages et, sans précaution, une invalidation du TLB (Translation Lookaside Buffer), le cache des traductions d’adresses. Le support de PCID (Process-Context Identifier) sur les processeurs récents évite l’essentiel de ces invalidations. Les charges qui font beaucoup d’appels système (bases de données, serveurs de fichiers, proxys à fort débit de petites requêtes) paient le plus ; le calcul pur ne sent presque rien.
Retpoline (« return trampoline »). Technique de compilation qui remplace chaque saut indirect par une séquence fondée sur une instruction de retour, dont la spéculation est piégée dans une boucle inoffensive. Le BTB n’est plus consulté, Spectre v2 perd son levier. Avec GCC, l’option est -mindirect-branch=thunk ; le noyau Linux et les hyperviseurs ont été recompilés ainsi. Limite à connaître : sur certaines microarchitectures, quand la pile de prédiction des retours (RSB, Return Stack Buffer) se vide, le processeur se rabat sur le BTB, ce qui rouvre la porte. La famille d’attaques Retbleed, publiée en 2022, a exploité précisément ce point. Retpoline n’est donc pas une protection universelle, c’est une protection valide sur une liste de microarchitectures.
Microcode : IBRS, IBPB, STIBP. Les mises à jour de microcode ont ajouté trois commandes de contrôle : IBRS (Indirect Branch Restricted Speculation) limite l’influence des prédictions faites à un niveau de privilège moindre, IBPB (Indirect Branch Predictor Barrier) purge les prédicteurs lors d’un changement de contexte, STIBP (Single Thread Indirect Branch Predictors) empêche le partage de prédictions entre les deux fils matériels d’un même cœur. Les premières versions de ce microcode ont été retirées pour cause de redémarrages intempestifs, rappel utile que « corriger en urgence » et « corriger » sont deux verbes distincts. Les générations suivantes ont intégré eIBRS (enhanced IBRS), activé en permanence pour un coût bien moindre.
Spectre v1 : pas de correctif global. Aucun interrupteur ne ferme v1. On traite chaque gadget : barrière de sérialisation lfence après un test de bornes sensible, ou masquage arithmétique de l’indice (la macro array_index_nospec du noyau Linux). Les compilateurs JIT (Just-In-Time) des navigateurs appliquent le même masquage au code JavaScript qu’ils génèrent. C’est un travail d’audit permanent, pas une case cochée.
Navigateurs. Comme on ne peut pas éliminer la spéculation dans un JIT, les éditeurs ont attaqué le chronomètre et la cohabitation : précision de performance.now() réduite, SharedArrayBuffer (qui permet de fabriquer un minuteur précis) désactivé puis réservé aux pages en isolement inter-origines via les en-têtes COOP (Cross-Origin-Opener-Policy) et COEP (Cross-Origin-Embedder-Policy), et surtout isolation des sites dans des processus distincts. Ce dernier point est le seul qui tienne vraiment : réduire la précision d’une horloge ralentit l’attaque, séparer les processus la prive de cible.
Ce que KPTI, retpoline et le microcode ne garantissent pas
Section intitulée « Ce que KPTI, retpoline et le microcode ne garantissent pas »Les correctifs de 2018 ferment trois variantes nommées. Ils ne ferment pas la classe d’attaques. Les années suivantes ont vu L1TF (L1 Terminal Fault, 2018), puis MDS (Microarchitectural Data Sampling, 2019) et plusieurs autres familles, chacune exploitant un tampon interne différent avec le même principe de spéculation et de trace mesurable. Croire qu’un système « patché Spectre » est immunisé contre les attaques microarchitecturales, c’est croire qu’un antivirus à jour de 2018 protège en 2026.
Plusieurs garanties restent absentes :
- Le SMT (Simultaneous Multithreading) partage toujours des structures internes. Deux fils matériels d’un même cœur partagent caches L1, tampons et prédicteurs. Pour L1TF et MDS, la seule mitigation complète entre locataires non fiables est de ne jamais placer deux contextes de confiance différente sur un même cœur physique (désactivation du SMT ou ordonnancement par cœur). Le coût en débit est réel, et c’est bien pour cela qu’on préfère souvent ne pas le mesurer.
- Un conteneur n’est pas une frontière contre ces attaques. Les conteneurs partagent le noyau ; un code Spectre v1 dans un conteneur cible le même noyau que celui de l’hôte. L’isolation pertinente pour un locataire hostile est la machine virtuelle à cœurs dédiés, ou la machine physique. Le sujet rejoint les choix d’hébergement traités dans Cloud.
- Les secrets en mémoire restent lisibles par principe. Une clé privée chargée en mémoire d’un processus est, par construction, à portée de toute fuite microarchitecturale qui atteint ce processus. Le seul endroit où elle n’est pas, c’est un module qui ne la laisse jamais sortir : voir le module cryptographique matériel et PKCS#11. Un HSM (Hardware Security Module) ne rend pas le processeur hôte plus sûr ; il retire la clé de la table.
- Le code constant-time ne suffit plus. Un code cryptographique sans branchement dépendant du secret reste vulnérable si un gadget Spectre ailleurs dans le processus peut lire la zone mémoire où réside la clé.
La position à retenir : les mitigations logicielles sont obligatoires mais transitoires, et la vraie contre-mesure de long terme est architecturale. Tout code non fiable (JavaScript tiers, greffons, charges de clients, pipelines CI/CD exécutant des contributions externes) doit tourner dans un domaine d’isolation qui ne partage ni espace d’adressage ni cœur physique avec les secrets qui comptent.
Mitigations désactivées : un arbre de décision qui tient en production
Section intitulée « Mitigations désactivées : un arbre de décision qui tient en production »Le paramètre noyau mitigations=off revient régulièrement dans les guides de performance, présenté comme un gain gratuit. Il est gratuit au sens où une porte sans serrure est gratuite. La décision dépend d’une seule question : un code dont on ne contrôle pas l’origine peut-il s’exécuter sur cette machine, à n’importe quel niveau ?
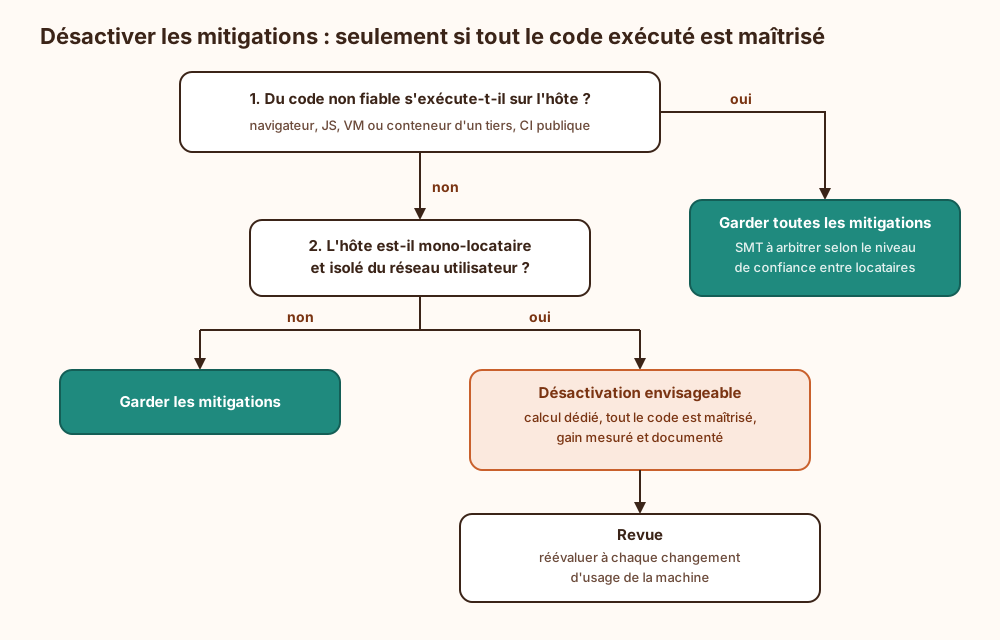
Le schéma se lit de haut en bas : la désactivation n’est défendable qu’au bout de la branche la plus étroite. Vingt ans de métier enseignent que le « cluster de calcul fermé » d’aujourd’hui accueille l’an prochain un service de notebooks partagés, et que personne ne repense aux paramètres de démarrage du noyau à ce moment-là. Une désactivation sans réévaluation programmée est une vulnérabilité en sursis.
Conditions d’exploitation : microcode, noyau, images et supervision
Section intitulée « Conditions d’exploitation : microcode, noyau, images et supervision »Une contre-mesure Spectre ou Meltdown repose sur trois couches qui évoluent indépendamment, et l’oubli d’une seule annule les autres.
Microcode. Il se charge soit par le micrologiciel BIOS/UEFI (Unified Extensible Firmware Interface), soit très tôt au démarrage par le système d’exploitation (paquet intel-microcode ou amd64-microcode, chargé depuis l’initramfs). Une mise à jour du paquet sans redémarrage ne change rien au processeur en cours. Le suivi passe par la version de microcode rapportée dans /proc/cpuinfo, à comparer à la version publiée par le fabricant.
Noyau et hyperviseur. La plupart des mitigations demandent un noyau récent et un redémarrage. Sur un hyperviseur, l’invité ne voit les capacités IBRS, IBPB ou STIBP que si l’hyperviseur expose les drapeaux CPU correspondants ; un modèle de CPU virtuel trop générique, choisi pour faciliter la migration à chaud, peut masquer ces capacités et laisser l’invité sans mitigation matérielle tout en se croyant à jour.
Images et restaurations. Restaurer un instantané de machine virtuelle ou redéployer une image de base ancienne réintroduit le noyau d’origine et ses lacunes. Le contrôle des mitigations doit donc s’exécuter au démarrage de chaque instance, pas une fois par trimestre sur l’inventaire.
Supervision. Ces attaques ne laissent aucune trace dans les journaux : pas d’appel système anormal, pas de fichier ouvert. La détection directe est donc irréaliste, et la supervision porte sur l’état de conformité (mitigations actives, microcode à jour) plutôt que sur l’événement. Une alerte se déclenche quand un hôte affiche « Vulnerable » dans sa sortie sysfs, au même titre qu’un certificat expiré.
Exemple : vérifier l’état des mitigations Spectre et Meltdown sous Linux
Section intitulée « Exemple : vérifier l’état des mitigations Spectre et Meltdown sous Linux »Depuis Linux 4.15, le noyau publie l’état de chaque vulnérabilité microarchitecturale dans sysfs. La commande suivante est en lecture seule, ne demande aucun privilège et se prête à une intégration dans un agent d’inventaire.
# Affiche, pour chaque vulnérabilité connue du noyau, l'état de la mitigation.# Chaque fichier contient "Not affected", "Mitigation: ..." ou "Vulnerable".grep . /sys/devices/system/cpu/vulnerabilities/*
# Vérifie les paramètres de démarrage : un "mitigations=off", "nopti"# ou "spectre_v2=off" ici signale une désactivation volontaire.cat /proc/cmdline
# Version du microcode actuellement chargé par le processeur.grep -m1 microcode /proc/cpuinfo
Sur un hôte correctement protégé, la ligne meltdown indique Mitigation: PTI (ou Not affected sur un processeur corrigé matériellement), la ligne spectre_v1 mentionne le masquage de pointeurs, et la ligne spectre_v2 décrit la combinaison retenue (par exemple eIBRS ou retpoline, avec l’état d’IBPB et de STIBP). La règle d’exploitation est directe : toute ligne commençant par Vulnerable sur un hôte qui exécute du code tiers est un incident de conformité, pas une note pour plus tard. Sous Windows, le module PowerShell SpeculationControl fournit l’équivalent avec la commande Get-SpeculationControlSettings.
Pour le reste des vulnérabilités historiques et de leurs leçons, l’index des failles rassemble notamment Dirty COW, autre cas où une optimisation du noyau ouvrait un franchissement de privilège, et Cloudbleed, où la mémoire d’un locataire fuyait vers un autre par une voie bien moins exotique.
Spectre est-il toujours exploitable aujourd’hui ?
Section intitulée « Spectre est-il toujours exploitable aujourd’hui ? »Spectre v1 n’a pas de correctif global : sa protection dépend de l’absence de gadgets exploitables dans le code cible, et de nouvelles variantes de la même classe continuent d’être publiées. Les processeurs récents corrigent Meltdown en matériel et réduisent fortement le coût des mitigations v2, mais la classe d’attaques reste ouverte. Le niveau de risque dépend surtout de la présence de code non fiable à proximité des secrets.
Les pertes de performance de 2018 sont-elles encore d’actualité ?
Section intitulée « Les pertes de performance de 2018 sont-elles encore d’actualité ? »En grande partie non, sur matériel récent : PCID, eIBRS et la correction matérielle de Meltdown ont absorbé l’essentiel du surcoût. Les charges riches en appels système sur processeurs anciens restent les plus pénalisées, et la désactivation du SMT, quand elle s’impose, reste la mitigation la plus coûteuse.
Faut-il désactiver l’hyperthreading partout ?
Section intitulée « Faut-il désactiver l’hyperthreading partout ? »Non. Elle se justifie quand deux contextes de confiance différente peuvent partager un cœur physique : hôtes multi-locataires, machines exécutant des charges de clients distincts. Sur un hôte où tout le code relève du même niveau de confiance, l’ordonnancement par cœur ou le maintien du SMT avec les autres mitigations actives se défend.
- CVE-2017-5753, MITRE.
- CVE-2017-5715, MITRE.
- CVE-2017-5754, MITRE.
🐝 Ce qui arrive si on s’en passe
Section intitulée « 🐝 Ce qui arrive si on s’en passe »Sans KPTI sur un processeur touché par Meltdown, n’importe quel processus non privilégié lit la mémoire du noyau, donc les tampons réseau, les clés de chiffrement de disque et les données des autres processus que le noyau manipule. Sans retpoline ni microcode à jour, une machine virtuelle peut orienter la spéculation de l’hyperviseur ou d’une machine voisine sur le même cœur. Sans isolation des sites dans le navigateur, un script publicitaire partage l’espace d’adressage d’une page bancaire ouverte dans un autre onglet. Dans tous ces cas, aucune ligne de journal ne permet ensuite de savoir si la lecture a eu lieu, ni ce qui est sorti : l’enquête après coup n’a rien sur quoi s’appuyer.
🦫 Explication de la marmotte 🍫
Section intitulée « 🦫 Explication de la marmotte 🍫 »Un processeur exécute des instructions très vite, mais attendre la mémoire ou le résultat d’un test le ralentit. Alors il devine : il calcule à l’avance la suite la plus probable. S’il s’est trompé, il efface les résultats et recommence correctement. Le problème, c’est qu’il n’efface pas tout. Pendant ce calcul anticipé, il a rangé des données dans le cache, une petite mémoire très rapide placée près de lui, et ce cache n’est pas vidé. Un programme malveillant mesure alors le temps qu’il faut pour lire différentes cases : une case lue très vite était dans le cache, donc elle a été touchée pendant le calcul effacé. De là, il déduit la donnée secrète qui avait servi à choisir cette case. Avec Meltdown, un programme ordinaire lisait ainsi la mémoire du système lui-même, que normalement personne d’autre ne doit voir. Avec Spectre, un programme pousse un autre programme à deviner de travers et lui fait révéler ses propres données. Les réparations ont consisté à cacher la mémoire du système quand un programme ordinaire tourne, à modifier la façon dont les programmes sont compilés, et à mettre à jour le petit logiciel interne du processeur. Ces réparations ralentissent un peu l’ordinateur, surtout les anciens modèles. Elles ne règlent pas tout : la meilleure protection reste de ne pas faire tourner un programme inconnu sur la même machine que des secrets précieux.
À lire aussi
- Rowhammer, Spectre et Meltdown, mécanismes et contre-mesuresRowhammer, Spectre, Meltdown et leur descendance, ce que ces attaques matérielles cassent dans l'isolation logicielle, ce que les correctifs coûtent et ce qui reste ouvert.
- SGX et TrustZone pour isoler du code sensibleMettre en œuvre des enclaves sécurisées SGX et TrustZone pour exécuter du code sensible malgré un système d’exploitation compromis.
- Isolation multi-locataire face à un locataire hostileQuelle frontière poser à chaque couche d'une plateforme mutualisée quand l'un des locataires est hostile, du noyau partagé à l'hôte dédié, et ce que chaque palier laisse passer.
- Hyperviseur Type 1 ou Type 2 : lequel choisirComparer les hyperviseurs Type 1 et Type 2 par leur architecture, leur surface d'attaque, leurs limites et leurs conditions d'exploitation.
Pages voisines
La citent
- Isolation multi-locataire face à un locataire hostile
- Non-interférence et contrôle de flux d'information en pratique
- Rowhammer, Spectre et Meltdown, mécanismes et contre-mesures
Spectre et Meltdown : exécution spéculative et fuite par cache
Elle cite