
Fuite Samsung ChatGPT : code source collé dans un assistant IA
Fuite Samsung ChatGPT : code source collé dans un assistant IA
Section intitulée « Fuite Samsung ChatGPT : code source collé dans un assistant IA »Au printemps 2023, quelques semaines après avoir autorisé ChatGPT dans sa division semi-conducteurs, Samsung a constaté que des ingénieurs y avaient collé du code source, des routines de détection de défauts et la transcription d’une réunion interne. Aucune faille n’a été exploitée : l’outil a fonctionné exactement comme prévu, ce qui pose un problème plus sérieux qu’une vulnérabilité. Restent à démêler le mécanisme exact de cette fuite, les contrôles qui la ferment réellement et ceux qui se contentent d’en donner l’impression.
→ Lire l’explication complète de la marmotte
Le mécanisme de la fuite : un prompt est un envoi de données
Section intitulée « Le mécanisme de la fuite : un prompt est un envoi de données »D’après la presse coréenne qui a révélé l’affaire, les trois cas rapportés suivent le même schéma. Un ingénieur colle le code d’un programme de mesure qui plante et demande la correction. Un deuxième soumet un code d’identification d’équipements défectueux pour l’optimiser. Un troisième transcrit l’enregistrement d’une réunion et demande un compte rendu. Ce sont trois gestes de productivité ordinaires. Ce sont aussi trois transferts de données classées vers un tiers, sans contrat, sans classification ni journal côté émetteur.
Le point technique à retenir : un prompt envoyé à un LLM (Large Language Model) hébergé est une requête HTTPS sortante dont le corps contient la donnée en clair pour le fournisseur. Le TLS (Transport Layer Security) protège le transit, pas la destination. Une fois reçue, la donnée suit la politique du service grand public de l’époque : conservation de l’historique, réutilisation possible pour l’entraînement sauf désactivation explicite par l’utilisateur, et conservation de durée limitée pour la détection d’abus, même après désactivation.
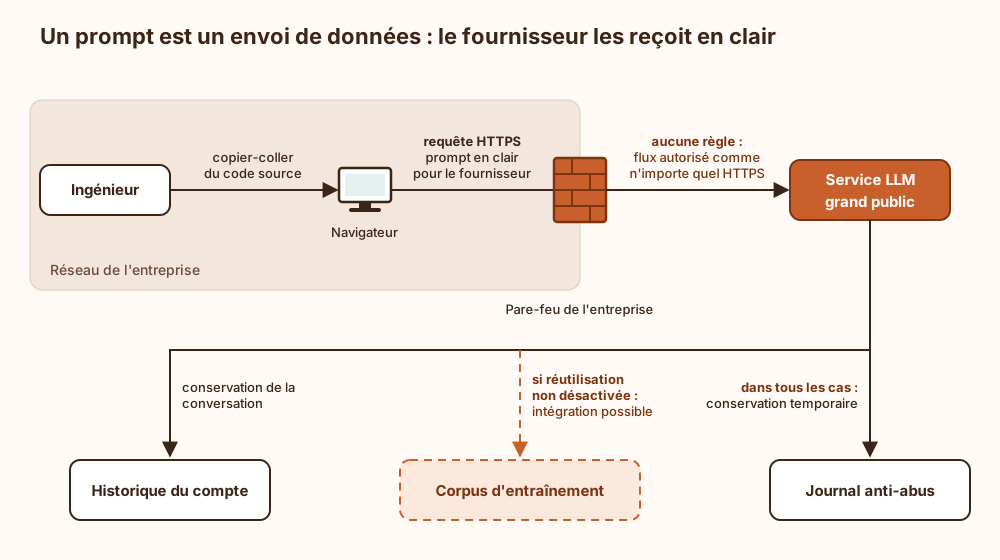
Ce schéma montre trois destinations de stockage côté fournisseur, dont une seule est maîtrisable par l’utilisateur. Côté entreprise, la seule trace est une ligne de journal proxy indiquant un nom de domaine et un volume, quand le proxy existe.
Le risque d’entraînement est réel mais secondaire. La page sur l’extraction des données d’entraînement de ChatGPT montre qu’un modèle peut restituer des fragments mémorisés mot pour mot. Cependant, la réutilisation d’un extrait de code par le modèle reste peu probable. Le risque immédiat est plus banal : la donnée existe désormais en dehors de l’entreprise, dans un historique protégé par le mot de passe d’un compte personnel.
Interdire ChatGPT ou canaliser l’usage : le compromis central
Section intitulée « Interdire ChatGPT ou canaliser l’usage : le compromis central »La réponse de Samsung a été en deux temps : limiter la taille des prompts, puis interdire les assistants génératifs sur les terminaux de l’entreprise. C’est la réponse réflexe du secteur, et elle échoue presque toujours de la même manière : l’usage ne disparaît pas, il passe sur le téléphone personnel. L’entreprise conserve le risque et perd la visibilité. Vingt ans de filtrage web apprennent qu’une catégorie bloquée ne disparaît pas : elle part sur la 4G.
Le compromis se résume ainsi. Interdire supprime le flux observable mais pas le besoin, et donc pas le flux réel. Canaliser l’usage vers un service sous contrat coûte un abonnement, une passerelle et une politique de classification. En échange, le flux devient visible, filtrable et contractuellement borné.
La position de cette page est nette : ouvrir un canal sanctionné, bloquer les accès grand public, et réserver l’auto-hébergement aux données les plus sensibles. L’interdiction pure n’a de sens que pour un périmètre déjà physiquement isolé (réseau de production industrielle, poste sans accès Internet), où le téléphone personnel est de toute façon exclu.
Le choix entre un service sous contrat et un modèle auto-hébergé dépend d’une seule question : la donnée la plus sensible qui sera soumise peut-elle légalement et contractuellement sortir du périmètre ? Si la réponse est oui, avec un sous-traitant engagé à ne pas entraîner sur les données et à borner la conservation, le service sous contrat suffit. Si la réponse est non (secret industriel sur lequel repose le chiffre d’affaires, données soumises au contrôle des exportations, code d’un produit certifié), il faut un modèle hébergé en interne. Il sera moins performant, et c’est un prix connu d’avance.
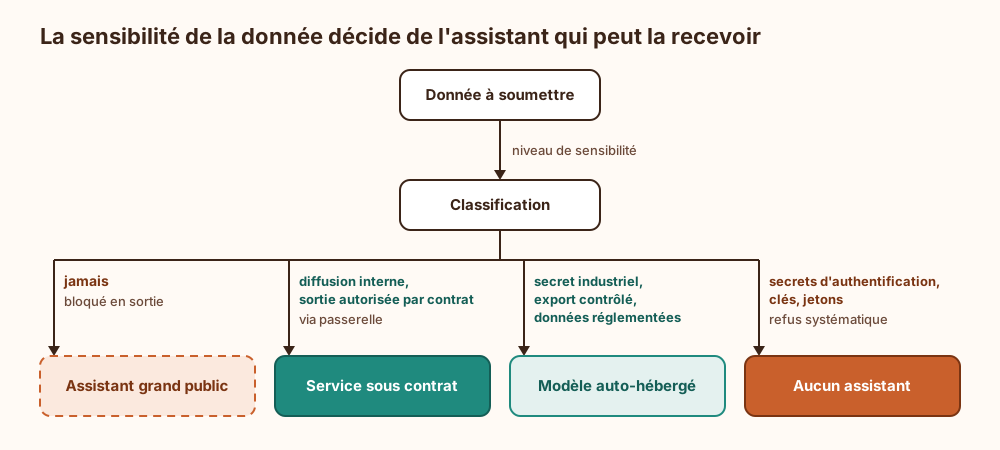
Cet arbre de décision montre que la branche « aucun assistant » n’est pas négociable. Une clé d’API ou un mot de passe n’a aucune raison de figurer dans un prompt, quel que soit le niveau de confiance accordé au service.
Prérequis : ce qui doit exister avant d’ouvrir le canal
Section intitulée « Prérequis : ce qui doit exister avant d’ouvrir le canal »Une passerelle d’IA générative sans les éléments suivants ne protège pas grand-chose. Elle donne surtout une raison de plus de dire « c’est encadré ».
- Une classification des données réellement appliquée. Sans niveau de sensibilité associé aux dépôts de code, aux partages et aux documents, la passerelle ne peut appliquer aucune règle. Une classification qui n’existe que dans une politique PDF n’est pas une classification.
- Un proxy de sortie obligatoire. Tous les flux HTTPS sortants doivent passer par un proxy. Un poste qui dispose d’une route directe vers Internet contourne tout le reste.
- Une inspection TLS sur les catégories concernées. Sans déchiffrement, on voit un nom de domaine (via le SNI, Server Name Indication) mais pas le prompt. On peut alors bloquer le domaine, mais pas filtrer le contenu.
- Un SSO (Single Sign-On) et un annuaire. La passerelle doit savoir qui envoie quoi pour journaliser, attribuer et révoquer. Un compte partagé « équipe-ia » annule cette exigence.
- Un contrat avec le fournisseur. Il doit préciser l’absence d’entraînement sur les données, une durée de conservation bornée, la localisation de l’hébergement, et un engagement de sous-traitant au sens de l’article 28 du RGPD (règlement général sur la protection des données) dès qu’un prompt peut contenir des données personnelles. Une transcription de réunion en contient toujours.
- Une liste des domaines d’IA tenue à jour. Les catégories des éditeurs de filtrage ont un retard de plusieurs semaines sur les nouveaux services. Il faut compléter cette liste manuellement.
Côté poste, l’interdiction des extensions de navigateur non approuvées fait partie des prérequis. Une extension « assistant IA » peut lire le contenu de chaque page ouverte, dépôt de code interne compris, et l’envoyer sans aucun copier-coller.
Pour l’emplacement du proxy et la segmentation des flux sortants, voir les pages réseaux. Pour la gouvernance des usages d’IA, voir la section IA.
Architecture de sortie : passerelle LLM, proxy et DLP
Section intitulée « Architecture de sortie : passerelle LLM, proxy et DLP »L’architecture cible comprend trois composants. Le proxy de sortie bloque les assistants grand public. Une passerelle LLM interne reçoit tous les prompts autorisés. Un moteur DLP (Data Loss Prevention), placé dans la passerelle, inspecte le contenu avant envoi vers le fournisseur sous contrat. Dans la topologie ci-dessous, il faut surtout remarquer que le poste n’a aucun chemin direct vers un fournisseur de LLM : tout passe par la passerelle, qui est la seule à détenir la clé d’API.
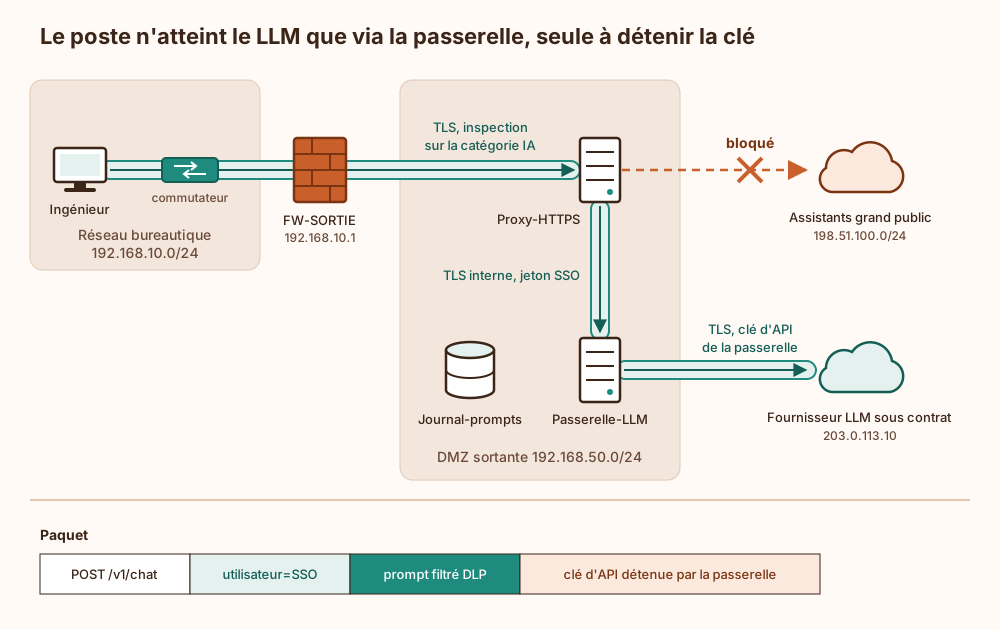
La DLP dans la passerelle détecte efficacement ce qui a une forme reconnaissable : clés d’API (préfixes connus, entropie élevée), clés privées PEM, numéros de carte, adresses électroniques, marqueurs de classification présents dans les en-têtes de fichiers. Elle est presque aveugle à ce qui fait la valeur d’un code propriétaire : un algorithme de rendement de fabrication ressemble à n’importe quelle boucle en Python. Une règle « bloquer tout ce qui ressemble à du code » rend l’outil inutilisable pour les développeurs, qui sont précisément ceux qui en veulent. Un projet de DLP qui promet de reconnaître le savoir-faire métier par expression régulière promet quelque chose qu’aucune expression régulière n’a jamais tenu.
Pour le code, l’approche qui fonctionne consiste à marquer les dépôts sensibles. On calcule des empreintes de fragments, en découpant le code en blocs normalisés puis en les hachant. La passerelle compare ensuite les prompts à ces empreintes. On détecte ainsi le copier-coller littéral, pas la paraphrase. C’est une limite à documenter dans l’analyse de risque, pas à cacher.
La limitation de taille des prompts, première mesure prise par Samsung, retarde la fuite sans l’empêcher : un fichier de dix mille lignes passe en vingt envois. Elle a un seul intérêt mesurable, celui de faire apparaître dans les journaux une rafale de requêtes qui mérite une alerte.
Exemple : règles de proxy et décision de la passerelle
Section intitulée « Exemple : règles de proxy et décision de la passerelle »Le blocage des assistants grand public se fait au niveau du proxy. Voici un extrait de configuration Squid qui refuse les domaines d’assistants publics et n’autorise que la passerelle interne. La liste de domaines est volontairement courte : en production, elle se maintient dans un fichier séparé.
# Fichier listant les domaines d'assistants grand public, un par ligne (.chatgpt.com, .openai.com, ...)acl ia_grand_public dstdomain "/etc/squid/listes/ia-grand-public.txt"
# Passerelle LLM interne, seule destination IA autoriséeacl passerelle_llm dstdomain llm.interne.example
# L'ordre compte : la première règle qui correspond s'appliquehttp_access allow passerelle_llmhttp_access deny ia_grand_public
# Vérification après rechargement : un CONNECT vers un domaine bloqué doit renvoyer 403# squid -k parse && squid -k reconfigure# curl -x http://proxy:3128 -sI https://chatgpt.com | head -1
Le blocage par dstdomain fonctionne sur le nom demandé dans la requête CONNECT, sans inspection TLS. Il ne bloque donc que les noms connus : un service apparu la semaine dernière passe. La logique de décision dans la passerelle, appliquée à chaque prompt, est décrite ci-dessous.
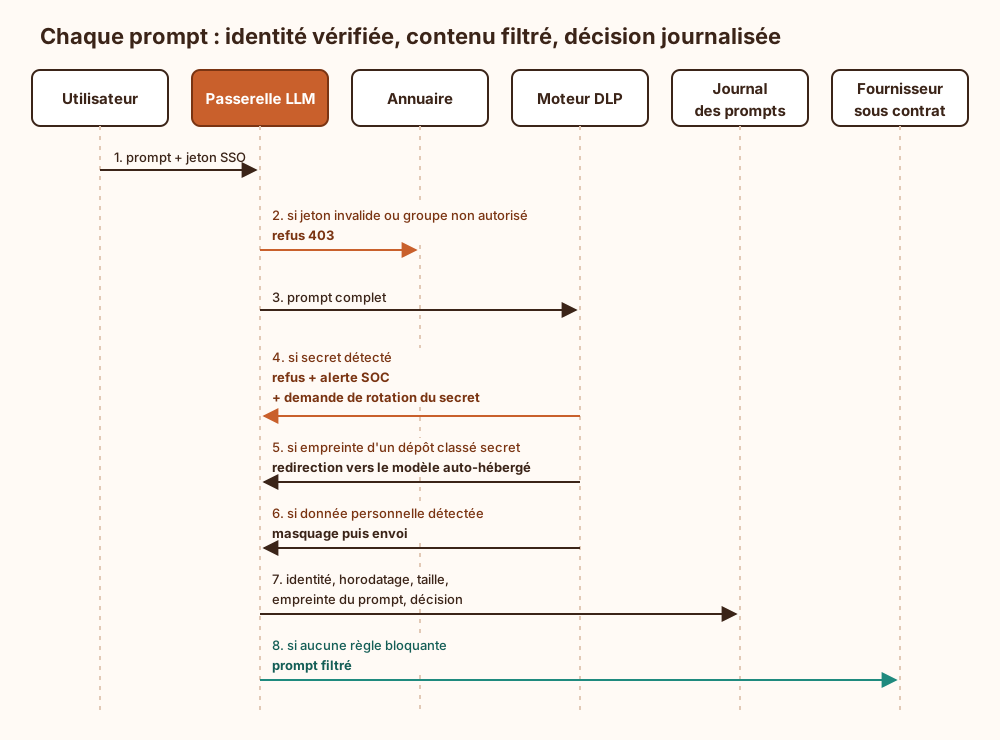
Dans ce flux, le secret détecté déclenche une alerte et une demande de rotation, et pas seulement un refus. En effet, un utilisateur qui colle une clé dans un prompt l’a déjà copiée hors de son coffre, et peut tout aussi bien l’avoir collée ailleurs auparavant. Par ailleurs, le journal enregistre une empreinte du prompt et non son contenu complet, pour des raisons détaillées dans la section suivante.
Surface d’attaque de la passerelle et ce qu’elle ne garantit pas
Section intitulée « Surface d’attaque de la passerelle et ce qu’elle ne garantit pas »La passerelle déplace le risque, elle ne le supprime pas. On remplace un flux incontrôlé par un composant qui concentre les prompts de toute l’entreprise. C’est un progrès, à condition de le traiter comme une cible.
Le journal des prompts devient la base la plus sensible du SI (système d’information). Il contient, par construction, tout ce que les utilisateurs ont jugé utile de soumettre : code, extraits contractuels, comptes rendus. Le journaliser en clair, c’est reconstituer chez soi la fuite qu’on voulait éviter chez le fournisseur. La règle : conserver les métadonnées et une empreinte, garder le contenu complet seulement en cas de refus DLP, sur une durée courte, chiffré, avec un accès restreint et lui-même journalisé.
La clé d’API du fournisseur est un secret de haute valeur. Quiconque la détient consomme le quota et, selon l’offre, peut lire l’historique d’utilisation. Elle doit être stockée dans un coffre et jamais dans une variable d’environnement d’image de conteneur (voir la pollution de variables d’environnement). Sa rotation doit pouvoir se faire sans interruption.
L’injection de prompt dans la passerelle. Dès qu’elle enrichit les prompts avec des documents internes (recherche augmentée), un document piégé peut détourner le modèle vers l’exfiltration du contexte. La page sur le chatbot Chevrolet montre à quel point un modèle obéit à la dernière instruction reçue. Il faut traiter tout contenu injecté dans le contexte comme une entrée non fiable.
Les comptes grand public déjà existants. Bloquer le domaine au bureau n’efface pas les historiques déjà accumulés sur des comptes personnels. Les identifiants de ces comptes circulent dans les journaux des logiciels voleurs d’informations comme n’importe quels autres identifiants. Pour récupérer ou faire supprimer ces historiques, il n’existe aucun moyen technique, seulement une démarche individuelle de l’utilisateur.
Ce que l’architecture ne garantit pas :
- Elle n’empêche ni la paraphrase, ni la photo d’écran, ni la saisie depuis un téléphone personnel. Ces canaux relèvent de la sensibilisation et du contrat de travail, pas du proxy.
- L’engagement contractuel de non-entraînement n’implique pas l’absence de conservation. Les offres professionnelles conservent généralement les données un temps limité pour la détection d’abus, et restent soumises aux réquisitions judiciaires du pays d’hébergement. La confidentialité vis-à-vis d’une autorité étrangère se règle par la localisation et le droit applicable, pas par une case cochée.
- Elle ne garantit pas que les réponses du modèle sont exemptes de code sous licence incompatible ou de vulnérabilités. C’est un autre sujet, qui relève de la revue de code et de l’analyse de composition logicielle.
- Elle ne détecte pas les services d’IA intégrés à des outils déjà autorisés : traitement de texte, outil de visioconférence avec résumé automatique, environnement de développement avec complétion. Ces flux passent par des domaines légitimes et échappent à la liste de blocage. Pour les couvrir, il faut un inventaire des fonctions d’IA de chaque outil SaaS (Software as a Service) et une désactivation dans la console d’administration.
Le référentiel OWASP Top 10 for LLM Applications classe ce risque sous LLM02 « Sensitive Information Disclosure ». Le guide de l’ANSSI sur la sécurité des systèmes d’IA générative recommande explicitement de proscrire les services grand public pour les données sensibles.
Exploitation : secrets, rotation, supervision et reprise
Section intitulée « Exploitation : secrets, rotation, supervision et reprise »Secrets. La passerelle détient une clé d’API par fournisseur, stockée dans un coffre, avec une rotation planifiée et un mécanisme de double clé (l’ancienne reste valide le temps du basculement). Un secret détecté dans un prompt est considéré comme compromis : on le révoque, on le remplace, puis on cherche où il a été copié. Le refus du prompt n’annule rien, il prouve seulement que le secret circulait hors du coffre.
Supervision. Quatre signaux sont à transmettre au SIEM (Security Information and Event Management) :
- le volume de requêtes bloquées vers les assistants grand public par utilisateur, qui révèle un besoin non couvert plutôt qu’un attaquant ;
- les rafales de prompts successifs de taille maximale, qui signalent un découpage de fichier ;
- les refus DLP répétés pour un même utilisateur ;
- l’apparition de nouveaux domaines d’IA dans les journaux du proxy, à comparer à la liste de blocage.
Un tableau de bord qui ne montre que le nombre total de prompts sert à justifier la facture, pas à détecter une fuite.
Reprise. Une passerelle indisponible ne doit pas basculer en accès direct au fournisseur : ce mode dégradé ouvert annule tout le dispositif. Elle ne doit pas non plus rester indisponible longtemps, sinon les utilisateurs retournent sur les services grand public par le réseau mobile. Cela impose un dimensionnement en haute disponibilité, au même titre que la messagerie, et une sauvegarde de la configuration DLP et des empreintes de dépôts. Reconstruire ces empreintes à partir des sources prend des heures.
Revue. La liste des fournisseurs autorisés, les conditions contractuelles et les fonctions d’IA activées dans les outils SaaS changent plus vite que les politiques internes. Une revue trimestrielle est un minimum. Les conditions d’utilisation des offres d’IA ont été réécrites plusieurs fois par an depuis 2023, souvent sans que personne ne relise le contrat signé l’année précédente.
Pour les volets données et gouvernance, voir les sections données et gouvernance. D’autres incidents liés aux assistants conversationnels sont recensés dans le catalogue des failles.
- Règlement (UE) 2016/679, Parlement européen et Conseil.
- OWASP Top 10 for LLM Applications 2025, OWASP Foundation.
- Recommandations de sécurité pour un système d’IA générative, ANSSI.
🐝 Ce qui arrive si on s’en passe
Section intitulée « 🐝 Ce qui arrive si on s’en passe »Sans proxy de sortie ni passerelle, chaque prompt envoyé à un service grand public quitte le périmètre sans aucune trace exploitable : l’entreprise ne sait ni qui a transmis quoi, ni vers quel service, ni sous quelles conditions de conservation. Une clé d’API collée dans une conversation reste valide, faute de détection qui déclencherait sa rotation. L’historique de chaque compte personnel accumule du code et des comptes rendus internes, accessibles à quiconque obtient ses identifiants. En cas de litige sur un secret industriel, il devient impossible de prouver des mesures raisonnables de protection. Les fonctions d’IA intégrées aux outils SaaS restent actives par défaut et transmettent des documents sans qu’aucune action volontaire de l’utilisateur ne soit nécessaire.
🦫 Explication de la marmotte 🍫
Section intitulée « 🦫 Explication de la marmotte 🍫 »Quand tu écris une question à un assistant de discussion sur Internet, ton texte part par le réseau jusqu’aux ordinateurs de l’entreprise qui fait fonctionner cet assistant. Il y est lu, traité, et souvent gardé : dans ton historique, parfois pour améliorer le programme, et quelque temps pour repérer les abus. En 2023, des ingénieurs de Samsung ont collé dans un tel assistant le code de leurs programmes et le texte d’une réunion secrète pour se faire aider. Personne n’a piraté quoi que ce soit : ces informations sont simplement sorties de l’entreprise. Interdire l’assistant ne règle rien, car les gens l’utilisent alors sur leur téléphone personnel, sans aucun contrôle. La bonne méthode tient en trois étapes. D’abord, un filtre sur la sortie Internet de l’entreprise bloque les assistants publics. Ensuite, toutes les questions passent par un serveur interne qui vérifie l’identité de la personne, cherche dans le texte des mots de passe ou du code classé secret, et refuse ou réoriente la demande si besoin. Enfin, ce serveur transmet les questions autorisées à un fournisseur qui s’est engagé par contrat à ne pas s’en servir pour entraîner son programme. Pour les informations les plus précieuses, on utilise un assistant installé dans l’entreprise elle-même. Ce système a ses limites : il ne voit pas une photo d’écran ni un texte reformulé, et ses propres journaux deviennent une cible à protéger soigneusement.
À lire aussi
- Fuite du prompt système de Bing Chat Sydney par injectionComment une injection de prompt a extrait en février 2023 les consignes internes de Bing Chat (nom de code Sydney), et pourquoi un prompt système ne doit contenir rien qui ne puisse être publié.
- Shadow AI, détecter les assistants IA publics non déclarésRepérer l'usage non déclaré d'assistants d'IA générative publics par les salariés dans les journaux réseau, puis l'encadrer par une offre autorisée plutôt que par un blocage aveugle.
- Rédiger une politique d'usage de l'IA générative publiquePolitique d'usage de l'IA générative publique qui croise la classification des données et les outils autorisés, et qui se fait appliquer sans devenir inapplicable.
- Fuite de secrets dans les prompts d'un assistant IA publicPrévenir, filtrer et traiter la fuite de mots de passe, de clés et de données clients collés dans un assistant d'intelligence artificielle public.
Pages voisines
La citent
- Fuite de secrets dans les prompts d'un assistant IA public
- Rédiger une politique d'usage de l'IA générative publique
- Shadow AI, détecter les assistants IA publics non déclarés
Fuite Samsung ChatGPT : code source collé dans un assistant IA
Elle cite