
cgroups : control groups
Infrastructure
cgroups : control groups. « Groupes de contrôle », par analogie avec une enveloppe budgétaire allouée à un service entier plutôt qu'à chaque employé. Le noyau Linux range les processus dans des groupes hiérarchiques et applique à chaque groupe des limites et une comptabilité de processeur, de mémoire, d'entrées-sorties et de nombre de processus.
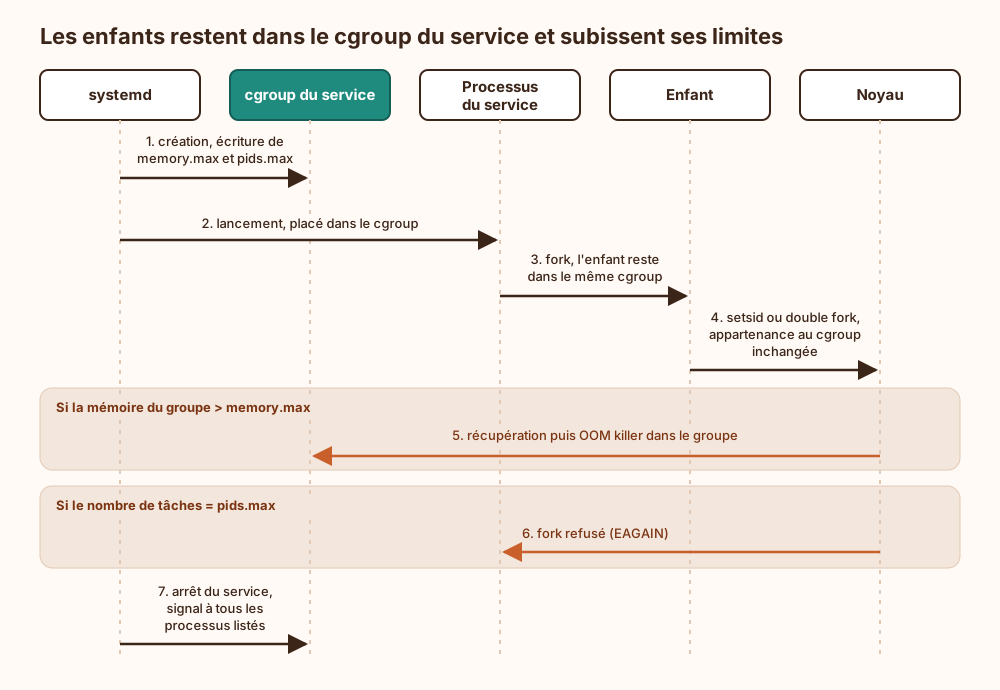
Appartenance héritée : Les groupes forment une arborescence exposée sous /sys/fs/cgroup, et un enfant créé par fork reste dans le cgroup de son parent. Ni setsid ni double fork ne font sortir un processus de son groupe : c'est ainsi que systemd retrouve et arrête tous les descendants d'un service ou d'une session.
Contrôleurs : Chaque ressource a son contrôleur : cpu (pondération et plafond), memory (memory.max déclenche l'OOM killer à l'intérieur du groupe), io, pids (pids.max refuse le fork suivant et neutralise une fork bomb). La limite porte sur le groupe entier, alors que les rlimits ne bornent qu'un processus à la fois.
v1 contre v2 : La version 1 juxtaposait une hiérarchie par contrôleur, ce qui produisait des combinaisons incohérentes. La version 2 impose une hiérarchie unifiée, et c'est elle que les distributions récentes montent par défaut.
Limiter n'est pas cacher : Un cgroup restreint ce qu'un processus consomme, pas ce qu'il voit : cette partie revient aux namespaces. Un conteneur est un processus ordinaire doté de namespaces pour ne pas voir et de cgroups pour ne pas trop manger ; le reste relève de la plaquette commerciale.
Ce qui arrive si on s'en passe
Sans cgroups actifs, aucun plafond ne sépare les processus d'une même machine : un seul service ou conteneur peut occuper toute la mémoire, et c'est alors le OOM killer global du noyau qui choisit une victime, parfois un processus sans rapport avec la cause. Une fork bomb (boucle de création de processus) épuise la table des PID et peut empêcher d'ouvrir un shell d'administration. Une charge intensive en processeur ou en entrées-sorties prive les voisins de leur part, ce qui suffit à provoquer un déni de service local depuis un compte non privilégié. La comptabilité disparaît aussi : il devient impossible d'attribuer une consommation à un service précis, donc de repérer un groupe dont l'usage dérive. Un gestionnaire comme systemd perd en outre le moyen fiable de suivre puis d'arrêter tous les processus d'un service, y compris ceux qui se sont détachés par double fork.
Explication de la marmotte
Sur un ordinateur, des dizaines de programmes tournent en même temps et se partagent la mémoire et la puissance de calcul. Imagine une colocation où chaque chambre reçoit un budget fixe d'électricité : si une chambre dépasse, on coupe le courant chez elle, pas chez les voisins. Le système fait pareil : il range les programmes par équipes et donne à chaque équipe sa part. Un programme qui en lance d'autres les garde dans son équipe, impossible de filer en douce. Ainsi, un programme qui s'emballe ne fait pas planter toute la machine, et on peut arrêter une équipe entière d'un seul coup.
Où ce terme est utilisé
- Isolation des conteneurs Docker : namespaces, cgroups et évasions (7 occurrences)
- EBPF pour observer et bloquer dans le noyau Linux (3 occurrences)
- Dirty COW CVE-2016-5195 : course dans le copy-on-write Linux (2 occurrences)
- Isolation multi-locataire face à un locataire hostile (2 occurrences)
- Linux shell, permissions et processus, le modèle de contrôle d'accès (2 occurrences)
- Docker ou Podman en auto-hébergement : root, rootless, isolation (1 occurrence)
- Écrire un Dockerfile durci avec condensé, multi-étapes et non root (1 occurrence)
- Linux : définition, origine et rôle du noyau (1 occurrence)
- Rowhammer, Spectre et Meltdown, mécanismes et contre-mesures (1 occurrence)
- TA0004 Élévation de privilèges : passer d'un compte ordinaire à l'administration (1 occurrence)