
Réplication
Infrastructure
Copie continue des données d'un nœud source vers un ou plusieurs autres nœuds, pour survivre à la panne d'une machine ou répartir la charge de lecture. Chaque copie (le réplica) suit la source avec un délai et des garanties de cohérence fixés à l'avance.
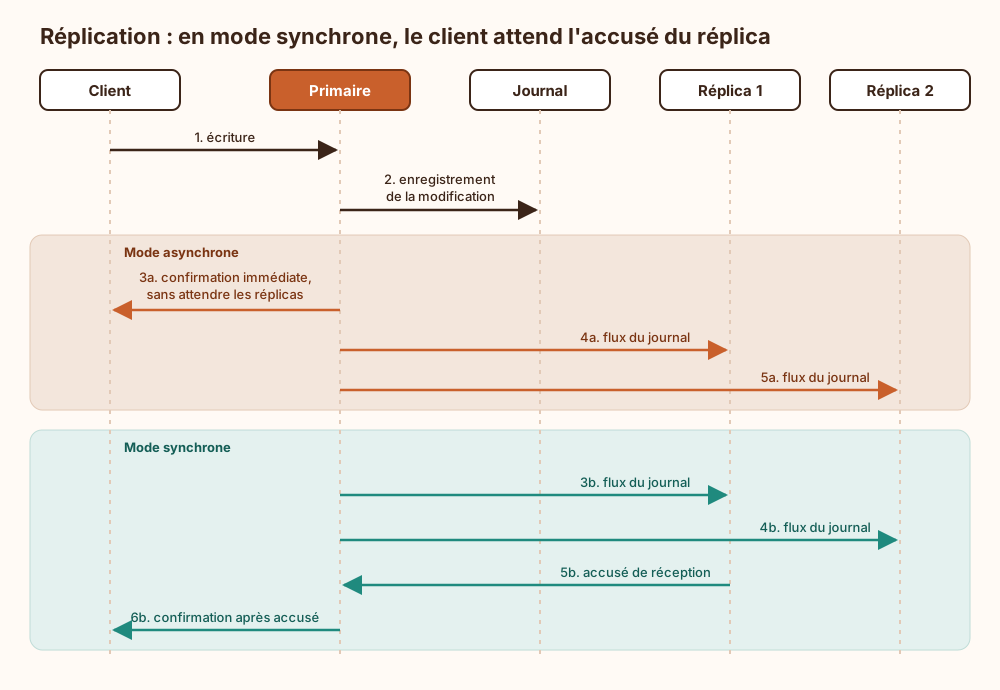
Synchrone ou asynchrone : En synchrone, l'écriture n'est confirmée qu'après l'accusé de réception des réplicas : aucune écriture confirmée ne se perd, mais de la latence en plus. En asynchrone, la confirmation part tout de suite et la copie suit, au prix d'un retard et de quelques écritures perdues si la source tombe au mauvais moment.
Topologies : Un primaire unique qui écrit et des réplicas qui lisent, du multi-primaire où chacun écrit et où il faut arbitrer les conflits, ou un quorum où une majorité de nœuds doit valider chaque écriture. Les algorithmes de consensus comme Raft ou Paxos gèrent ce dernier cas.
Pas que les bases de données : Les annuaires répliquent entre contrôleurs de domaine, les modules cryptographiques d'un même groupe se partagent leurs clés sous forme chiffrée, les systèmes de fichiers et les caches distribués ont le leur. Le vocabulaire change à chaque étage, le compromis entre délai et cohérence ne change jamais.
Retard et lectures périmées : Un réplica asynchrone peut renvoyer une valeur déjà remplacée sur la source. On parle alors de cohérence à terme : la donnée finit par être juste, sans garantie sur le moment.
Pas une sauvegarde : La réplication copie tout, y compris les erreurs : une suppression malencontreuse part sur tous les nœuds en quelques millisecondes, avec un zèle exemplaire. Vingt ans de métier apprennent que la différence entre réplica et sauvegarde se découvre toujours le jour où on aurait eu besoin de la seconde.
Ce qui arrive si on s'en passe
Sans réplication, chaque donnée n'existe que sur un seul nœud. La panne de son disque ou de sa machine rend le service indisponible jusqu'à la reconstruction complète, et tout ce qui a été écrit depuis la dernière sauvegarde est perdu sans recours. La reprise passe alors obligatoirement par une restauration, dont la durée augmente avec le volume de données. Toute la charge de lecture repose sur ce même nœud : un pic de trafic, une requête coûteuse ou un afflux volontaire de requêtes suffit à le saturer, et les écritures tombent avec les lectures. Chaque mise à jour du système ou du moteur impose une interruption planifiée, faute de nœud vers lequel basculer. Mettre la réplication en service ne remplace pas la sauvegarde pour autant : une suppression ou une corruption se propage aux réplicas en quelques instants, et trois copies d'une donnée perdue font toujours une donnée perdue.
Explication de la marmotte
Imagine que tu tiens le carnet de notes de ta classe. Si tu le perds, tout disparaît. Alors, à chaque note ajoutée, tu demandes à deux copains de la recopier dans leur propre carnet. Si ton carnet tombe dans une flaque, un copain prend le relais et rien n'est perdu. Parfois tu attends qu'ils aient fini de recopier avant de continuer : c'est plus lent, mais plus sûr. Parfois tu continues sans attendre : c'est plus rapide, mais si tu perds ton carnet juste avant qu'ils aient recopié, la dernière note s'envole. Attention quand même : si tu écris une bêtise, elle est recopiée partout.
Où ce terme est utilisé
- Résidence des données et souveraineté cloud (9 occurrences)
- Services applicatifs, partage et protocoles hérités (7 occurrences)
- Continuité, sauvegardes, PRA/PCA et haute disponibilité (5 occurrences)
- Registre Windows, GPO et services, fonctionnement et attaques (5 occurrences)
- Architecture de journalisation d’audit immuable centralisée (4 occurrences)
- Comment structurer Active Directory et déléguer sans escalade (4 occurrences)
- CRL ou OCSP pour révoquer un certificat (4 occurrences)
- MUSCULAR 2013 : interception des liaisons entre data centers (4 occurrences)
- Chiffrer les flux est-ouest dans un data center (3 occurrences)
- Comment sécuriser Redis et Memcached distribués (3 occurrences)