
OWASP Top 10 for Agentic Applications 2026 : les dix risques
OWASP Top 10 for Agentic Applications 2026 : les dix risques
Section intitulée « OWASP Top 10 for Agentic Applications 2026 : les dix risques »En décembre 2025, l’Agentic Security Initiative du projet OWASP GenAI Security a publié son OWASP Top 10 for Agentic Applications, millésimé 2026, qui numérote dix classes de défaillance des applications agentiques sous les codes ASI01 à ASI10. Ce n’est pas un Top 10 LLM augmenté de quelques entrées : le changement d’objet est franc. Le Top 10 LLM décrit un modèle qui répond ; celui-ci décrit un agent qui agit, c’est-à-dire un programme qui choisit des outils, garde une mémoire, parle à d’autres agents et enchaîne des décisions sans repasser par un humain à chaque pas.
→ Lire l’explication complète de la marmotte
Qui publie, quand, et avec quelle autorité
Section intitulée « Qui publie, quand, et avec quelle autorité »L’OWASP, dont le mandat et le périmètre réel sont décrits par ailleurs, est une fondation à but non lucratif : elle ne publie ni loi, ni certification, ni doctrine nationale. Le projet GenAI Security y abrite l’Agentic Security Initiative (ASI), qui s’occupe spécifiquement des systèmes agentiques. Le document est piloté par John Sotiropoulos, Keren Katz et Ron F. Del Rosario, chaque entrée étant portée par un ou deux responsables nommés, puis relue par un comité d’experts et par les organisations qui soutiennent le projet. Il est diffusé sous licence Creative Commons CC BY-SA 4.0.
L’autorité du texte est donc exactement celle d’un consensus communautaire : large, documenté, révisable, et sans aucune portée contraignante. Personne n’est en conformité ni en infraction avec un ASI. L’acronyme, du reste, est équivoque dans le document lui-même, où il désigne tantôt l’initiative, tantôt l’item : Agentic Security Initiative et Agentic Security Item. On s’y habitue, comme on s’habitue au fait que le mot « agent » désigne aussi bien un script de cent lignes qu’une flottille de modèles en conversation.
Le référentiel ne vit pas seul. Il renvoie à la taxonomie détaillée du projet, Agentic AI — Threats & Mitigations, dont les codes T01 à T17 décrivent des chemins d’attaque plus fins ; au Top 10 LLM, dont il prolonge plusieurs entrées ; au Top 10 des identités non humaines ; au système de notation AIVSS ; et aux nomenclatures CycloneDX et AIBOM, qui répondent à la question « quels composants tournent chez moi » là où les ASI répondent à « comment ces composants peuvent-ils se comporter de travers ». Chaque page de risque indique ces correspondances, qui sont le seul moyen sérieux de passer d’un code à une mesure.
Pourquoi un Top 10 de plus
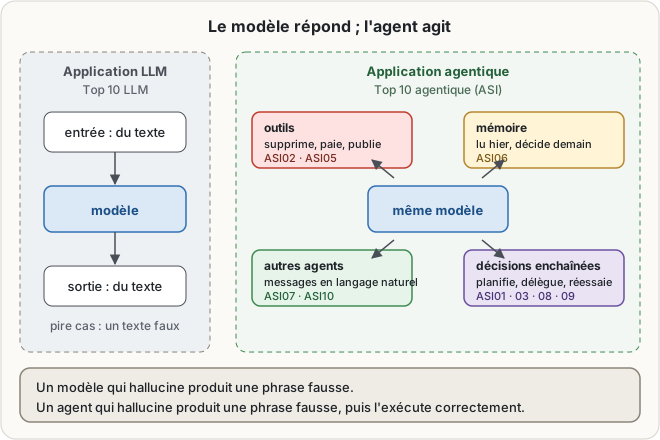
Section intitulée « Pourquoi un Top 10 de plus »La question est légitime : on ne manquait pas de listes. La réponse tient en une distinction que tout le reste suppose. Dans une application fondée sur un modèle de langage classique, la surface d’attaque est un entonnoir : du texte entre, du texte sort, et le pire qui puisse arriver est que le texte sortant soit faux, fuité ou toxique. L’injection de prompt y est déjà une plaie, mais une plaie à un seul débouché.
Un agent ajoute quatre choses, et chacune ouvre une famille de défaillances que le Top 10 LLM ne nomme pas :
- des outils : le modèle ne produit plus seulement du texte, il émet des appels de fonctions qui suppriment, paient, publient ou déploient — d’où ASI02 et ASI05 ;
- une mémoire : ce que l’agent a lu hier influence ce qu’il décidera demain, et une donnée empoisonnée devient une donnée persistante — d’où ASI06 ;
- d’autres agents : les messages entre pairs sont du langage naturel transporté sur un canal, avec les problèmes d’authentification et d’intégrité que cela suppose — d’où ASI07 et ASI10 ;
- des décisions enchaînées : l’agent planifie, délègue, réessaie, et personne ne relit chaque étape — d’où ASI01, ASI03, ASI08 et ASI09.
Ce n’est pas une différence de degré mais de nature. Un modèle qui hallucine produit une phrase fausse ; un agent qui hallucine produit une phrase fausse, puis l’exécute correctement. Le site traite ce basculement en détail dans la page sur les actions irréversibles des agents LLM, et la définition même du mot est discutée dans ce qu’agentique veut dire chez OpenAI et chez Anthropic.
Les dix risques, et où les lire
Section intitulée « Les dix risques, et où les lire »Chaque ligne renvoie à une page qui décrit le mécanisme, ce qui distingue le risque de ses voisins, ce qu’on regarde pour le détecter et ce qui le réduit.
| Code | Titre officiel | Le risque en une ligne |
|---|---|---|
| ASI01 | Agent Goal Hijack | Détournement d’objectif de l’agent : un contenu lu devient une instruction suivie, et l’agent change de but. |
| ASI02 | Tool Misuse and Exploitation | Détournement et exploitation des outils : l’agent reste dans ses droits mais emploie un outil légitime de travers. |
| ASI03 | Identity and Privilege Abuse | Abus d’identité et de privilèges : la délégation transporte plus de droits qu’elle ne devrait, et personne ne sait au nom de qui l’action est faite. |
| ASI04 | Agentic Supply Chain Vulnerabilities | Vulnérabilités de la chaîne d’approvisionnement agentique : outils, personas et descripteurs chargés à l’exécution depuis des tiers. |
| ASI05 | Unexpected Code Execution | Exécution de code inattendue : du texte devient du code exécuté sur l’hôte, hors de toute revue. |
| ASI06 | Memory & Context Poisoning | Empoisonnement de la mémoire et du contexte : une fausseté entre dans ce que l’agent retient et ressort en décision. |
| ASI07 | Insecure Inter-Agent Communication | Communication inter-agents non sécurisée : les messages entre pairs sont interceptés, rejoués ou forgés. |
| ASI08 | Cascading Failures | Défaillances en cascade : un défaut unique se propage et s’amplifie à travers les agents. |
| ASI09 | Human-Agent Trust Exploitation | Exploitation de la confiance humain-agent : l’humain approuve parce que l’explication est belle. |
| ASI10 | Rogue Agents | Agents voyous : l’agent dérive de sa fonction sans qu’un attaquant tienne encore le volant. |
L’ordre n’est pas un classement de gravité et ne prétend pas en être un. C’est une numérotation, utile pour se comprendre en réunion, inutile pour décider quoi corriger en premier dans un système donné.
Les deux principes transversaux
Section intitulée « Les deux principes transversaux »Le document pose deux principes qui traversent les dix entrées, et c’est sans doute son apport le plus durable.
Le premier est la moindre agentivité — least agency dans le texte original. Le moindre privilège limite ce que l’agent a le droit de toucher ; la moindre agentivité limite son droit d’agir tout court. La formulation du document est sèche : déployer un comportement agentique là où il n’est pas nécessaire étend la surface d’attaque sans rien apporter. Autrement dit, la question préalable n’est pas « quels droits donner à cet agent » mais « faut-il un agent ». Une tâche déterministe confiée à un modèle qui improvise ne gagne ni en fiabilité ni en vitesse, et perd l’essentiel : on ne peut plus prédire ce qu’elle fera. Le sujet est développé dans le moindre privilège pour une machine qui improvise, qui montre pourquoi le calcul classique du privilège minimal échoue sur un programme dont le comportement se décide à l’exécution.
Le second est l’observabilité, que le document déclare non négociable. Sans visibilité sur ce que font les agents, pourquoi ils le font et quels outils ils appellent, une autonomie inutile élargit silencieusement la surface d’attaque et transforme des incidents mineurs en pannes systémiques. Concrètement : journaliser l’objectif actif, la séquence d’appels d’outils, les décisions de politique et les identités en jeu, et savoir établir une ligne de base pour que l’anormal se voie. La mise en œuvre côté modèle est traitée dans comment observer un LLM en production ; côté garde-fous, dans l’architecture des guardrails programmatiques.
Ces deux principes expliquent la structure des pages qui suivent : la plupart des mitigations du référentiel sont des variantes de « donne-lui moins de pouvoir » et de « regarde ce qu’il fait ». Ce n’est pas une pauvreté de l’analyse, c’est l’état de l’art. Les contrôles spécifiques — validation des appels d’outils, bac à sable d’exécution, attestation d’identité — se déduisent de ces deux-là appliqués à une surface précise.
Ce que le référentiel ne fait pas
Section intitulée « Ce que le référentiel ne fait pas »Il énumère des classes de défaillance. Il ne dit pas quoi faire d’un système donné, et il serait malhonnête de le lui reprocher : aucune liste de dix entrées ne remplace un modèle de menace sur une architecture réelle. Trois limites méritent d’être dites avant de s’en servir.
D’abord, ce n’est pas une norme opposable. Aucun auditeur ne peut exiger la « conformité ASI », aucun régulateur ne s’y réfère. Les obligations, en Europe, viennent d’ailleurs — du règlement sur l’intelligence artificielle et de ses exigences de gestion des risques, de journalisation et de contrôle humain, qui, elles, s’imposent. Les ASI sont un vocabulaire et une liste de courses, pas un référentiel de certification.
Ensuite, les catégories se chevauchent, et le document l’assume en consacrant à chaque entrée un paragraphe de délimitation. Un même incident réel se code presque toujours sur trois ou quatre ASI : l’injection indirecte qui détourne un agent (ASI01) passe souvent par un outil (ASI02), s’installe dans la mémoire (ASI06) et se propage aux pairs (ASI08). Le classement sert à nommer le mécanisme dominant, pas à ranger l’incident dans une seule case. Les dix pages de ce dossier reprennent systématiquement ces délimitations, parce qu’elles sont la partie la plus utile du texte.
Enfin, la liste décrit l’état d’un domaine qui bouge vite. Elle s’appuie sur des incidents publics recensés sur quelques mois, ce qui est à la fois sa force — ce ne sont pas des hypothèses de laboratoire — et sa fragilité. La version 2026 parle beaucoup de MCP, de registres d’agents et de descripteurs de capacités, parce que c’est ce qui se déployait en 2025. Une partie de ce vocabulaire aura changé avant la prochaine édition, les mécanismes beaucoup moins.
Reste l’usage raisonnable : prendre les dix entrées comme une grille de relecture d’architecture, vérifier pour chacune si le système concerné l’expose, et noter ce qu’on fait des quatre ou cinq qui s’appliquent. C’est modeste, c’est utile, et c’est très exactement ce que l’OWASP annonce — le document se présente lui-même comme une boussole, pas comme une carte.
🐝 Ce qui arrive si on s’en passe
Section intitulée « 🐝 Ce qui arrive si on s’en passe »Sans vocabulaire commun, chaque incident agentique se raconte deux fois : une fois par l’équipe qui exploite, en termes de symptômes — l’agent a supprimé des données, la facture a triplé, un pair a reçu des instructions qu’on ne lui a pas envoyées — et une fois par l’équipe qui développe, en termes de composants. Les deux récits ne se recoupent pas, et la revue d’incident se termine sur une liste d’actions dont personne ne sait si elle couvre la cause. Le coût concret se voit au moment de la conception : faute de liste des défaillances connues, la revue d’architecture n’examine que les risques auxquels quelqu’un dans la pièce a déjà été confronté, c’est-à-dire l’injection de prompt et les secrets en clair, et laisse sans examen la délégation de droits, la persistance en mémoire et la propagation entre agents — les trois qui coûtent le plus cher à rattraper après la mise en production.
🦫 Explication de la marmotte 🍫
Section intitulée « 🦫 Explication de la marmotte 🍫 »Un assistant informatique classique répond à une question. On lui écrit quelque chose, il écrit quelque chose en retour, et c’est tout : s’il se trompe, le dégât est un texte faux. Un « agent » est le même genre de programme, mais autorisé à agir : il peut envoyer un courriel, modifier un fichier, lancer un paiement, demander à un autre programme de faire quelque chose. S’il se trompe, le dégât n’est plus un texte, c’est un acte.
L’OWASP est une association internationale qui recense les défauts de sécurité des logiciels et publie des listes des dix plus graves, pour que les équipes informatiques aient un langage commun. En décembre 2025, elle a publié une telle liste pour ces assistants qui agissent seuls. Les dix entrées sont numérotées ASI01 à ASI10 : chacune nomme une façon dont les choses tournent mal, par exemple le fait qu’un document piégé puisse changer l’objectif de l’assistant, ou qu’un assistant garde en mémoire une information fausse et la réutilise pendant des mois.
Deux idées reviennent dans les dix entrées. La première est qu’il faut donner à ces programmes le moins de pouvoir d’agir possible, et se demander d’abord si l’on a vraiment besoin d’un programme qui décide tout seul. La seconde est qu’il faut pouvoir regarder ce qu’ils font : conserver la trace de chaque action, de chaque outil employé, de chaque décision, afin de repérer ce qui sort de l’ordinaire.
Cette liste n’est pas une loi et n’oblige personne. Elle ne dit pas non plus quoi faire d’une installation précise : elle donne les noms des pannes possibles, à charge pour chacun de vérifier lesquelles le concernent. C’est déjà beaucoup : la plupart des accidents informatiques ne viennent pas d’un défaut inconnu, mais d’un défaut connu auquel personne n’avait pensé à donner un nom.
À lire aussi
- OWASP MCP Top 10 2025 : les dix risques du protocole de contexteLe Top 10 OWASP pour le Model Context Protocol, édition 2025 en version bêta : les dix entrées MCP01 à MCP10, l'empoisonnement d'outils, les serveurs fantômes, et l'état réel du document.
- OWASP Top 10 LLM 2026 : la grille qui relie les risques des modèlesL'édition 2026 du Top 10 OWASP pour les applications à base de modèles de langage : les dix entrées LLM01 à LLM10, ce qui a changé depuis 2025, et la méthode qui croise un vote de praticiens avec 6 639 incidents réels.
- Les Top 10 de l'OWASP : une trentaine de listes, un seul nomPourquoi l'OWASP publie une trentaine de Top 10 et pas un seul, quelle surface couvre chacun, quelle est leur édition courante, et ce qu'un Top 10 n'est pas.
- OWASP Machine Learning Security Top 10 : viser le modèle, pas l'applicationLe Top 10 OWASP de la sécurité de l'apprentissage automatique, édition 2023 en brouillon : les dix entrées ML01 à ML10, et ce qui les distingue du Top 10 LLM — ce référentiel vise le modèle lui-même.
Pages voisines
La citent
- Les Top 10 de l'OWASP : une trentaine de listes, un seul nom
- OWASP MCP Top 10 2025 : les dix risques du protocole de contexte
OWASP Top 10 for Agentic Applications 2026 : les dix risques
Elle cite
- Lien dans les deux sens :ASI01 : détournement d'objectif d'un agent IA
- Lien dans les deux sens :ASI02 : détournement et exploitation des outils d'un agent
- Lien dans les deux sens :ASI03 : abus d'identité et de privilèges par un agent
- Lien dans les deux sens :ASI04 : chaîne d'approvisionnement agentique
- Lien dans les deux sens :ASI05 : exécution de code inattendue par un agent
- Lien dans les deux sens :ASI06 : empoisonnement de la mémoire et du contexte d'un agent
- Lien dans les deux sens :ASI07 : communication inter-agents non sécurisée
- Lien dans les deux sens :ASI08 : défaillances en cascade dans un système d'agents
- Lien dans les deux sens :ASI09 : exploitation de la confiance entre humain et agent
- Lien dans les deux sens :ASI10 : agents voyous, dérive comportementale et confinement
: les deux pages se citent l’une l’autre.