
Les secrets dans les dépôts Git
Éditorial
Des clés d'API, des mots de passe et des jetons continuent de se retrouver dans les dépôts Git, dans l'historique, les forks, les fichiers d'exemple et les journaux d'intégration continue. Un secret poussé est un secret compromis : le supprimer ne répare rien, seule la rotation répare, et la seule prévention durable est de ne plus avoir de secret à fuir.
→ Lire l’explication complète de la marmotte
Une chaîne de quarante caractères
Section intitulée « Une chaîne de quarante caractères »Il y a des vulnérabilités qui demandent du génie. Il faut comprendre un protocole mieux que ses auteurs, trouver l’octet de trop dans un analyseur, enchaîner trois comportements anodins en une exploitation. Et puis il y a le secret dans le dépôt, qui ne demande que de savoir lire, compétence dont on m’assure qu’elle reste assez répandue.
C’est la plus ancienne, la plus connue et la plus documentée des fautes d’hygiène du développement. Tout le monde la connaît. Tout le monde a entendu la consigne. Des outils gratuits la détectent depuis des années, et les plateformes d’hébergement bloquent désormais une partie des cas au moment même de la poussée. Et pourtant on en trouve encore, régulièrement, partout : dans des dépôts publics, dans des dépôts privés, dans des historiques vieux de dix ans, dans des journaux d’intégration continue, dans des images de conteneurs. La persistance d’une faute aussi connue devrait nous intriguer davantage qu’elle ne nous agace. Quand une erreur survit à toutes les campagnes de sensibilisation, c’est rarement que les gens sont bêtes ; c’est plus souvent que le système les y pousse, et qu’on s’obstine à corriger les gens.
Cet éditorial soutient deux thèses. La première : un secret qui a été poussé est un secret compromis, et aucune manipulation de l’historique ne le rend à l’état de secret ; seule la rotation le fait. La seconde, qui en découle : la prévention durable ne consiste pas à mieux cacher les secrets, mais à en avoir moins, et surtout moins qui vivent longtemps.
Pourquoi on en trouve encore partout
Section intitulée « Pourquoi on en trouve encore partout »Il serait confortable de croire que les secrets arrivent dans les dépôts par étourderie pure, et qu’un peu de rigueur suffirait. La réalité est plus instructive : ils y arrivent par des chemins que la structure même de Git et de nos outils rend naturels.
L’historique ne pardonne rien
Section intitulée « L’historique ne pardonne rien »Git a été conçu pour ne rien oublier. C’est sa raison d’être, sa gloire et, pour notre sujet, son drame. Un fichier de configuration contenant un mot de passe, commité par erreur puis supprimé dans le commit suivant, n’a pas disparu : il est dans l’historique, intact, accessible à quiconque possède une copie du dépôt et sait taper git log -p. La suppression est un nouvel événement qui s’ajoute à l’histoire ; elle n’efface pas l’événement précédent. Git est en cela plus honnête que la plupart des institutions humaines.
Le développeur qui supprime le fichier et pousse le correctif a donc l’impression d’avoir réparé. Il a en réalité publié deux commits : l’un qui expose le secret, l’autre qui signale à tout lecteur attentif l’endroit exact où le chercher. On n’aurait pas mieux fait avec un panneau indicateur.
Les copies qu’on ne maîtrise pas
Section intitulée « Les copies qu’on ne maîtrise pas »Chaque clone est une copie complète de l’historique. Le poste de chaque développeur, chaque exécuteur d’intégration continue, chaque sauvegarde, chaque miroir, chaque outil d’analyse qui a un jour récupéré le dépôt en détient un exemplaire. Sur les plateformes d’hébergement, les forks d’un dépôt partagent souvent leur stockage d’objets avec l’original, et des références que l’utilisateur ne contrôle pas, comme celles qui correspondent aux demandes de fusion, peuvent maintenir un commit accessible par son identifiant alors même qu’aucune branche ne le désigne plus. Le détail exact de ces mécanismes dépend de la plateforme ; le principe, lui, est constant : on ne sait pas combien de copies existent, et on ne peut en détruire aucune qu’on ne possède pas.
Les fichiers d’exemple qui n’en sont pas
Section intitulée « Les fichiers d’exemple qui n’en sont pas »Beaucoup de projets fournissent un fichier .env.example ou config.sample.yaml pour montrer la forme de la configuration attendue. L’intention est excellente. La pratique consiste souvent à copier le vrai fichier, à le renommer, et à oublier de remplacer une valeur sur douze. Le même phénomène touche les données de test (« une vraie clé de l’environnement de recette, ce n’est pas grave »), les exemples de documentation, les captures d’écran, les notebooks dont les cellules de sortie ont gardé l’affichage d’une variable, et les fichiers d’état des outils d’infrastructure déclarative, qui contiennent parfois des valeurs sensibles en clair et qu’on commite par commodité.
Le point commun est que ces fichiers ne sont pas perçus comme des fichiers de secrets. Le .gitignore protège avec vigilance le fichier .env, et laisse passer son jumeau .env.example avec la sérénité d’un portier qui ne contrôle que les gens qui s’appellent Dupont.
Le provisoire qui s’installe
Section intitulée « Le provisoire qui s’installe »Reste le chemin le plus humain, et le plus difficile à combattre parce qu’il part d’une bonne intention : le test rapide. Un développeur veut vérifier qu’une intégration fonctionne. Plutôt que de câbler la lecture de la configuration, il colle la clé directement dans le code, « juste pour voir ». Ça marche. Il passe à autre chose. Trois semaines plus tard, le fichier fait partie d’un commit plus large, relu en diagonale par un collègue dont l’attention portait, fort légitimement, sur la logique métier.
Personne n’a fauté au sens strict. Le développeur comptait nettoyer ; le relecteur regardait ce qu’on lui demandait de regarder ; l’outil a enregistré ce qu’on lui a donné. La fuite est la somme de trois comportements raisonnables, ce qui est la définition même d’un problème de système et la raison pour laquelle les campagnes de sensibilisation n’en viennent pas à bout. On peut exhorter chacun à la vigilance ; on ne peut pas exhorter une probabilité.
La seule réponse structurelle est que la manière correcte soit aussi la plus rapide : un gabarit de projet où la lecture des secrets depuis l’environnement ou le gestionnaire est déjà câblée, un environnement de développement qui fournit des identifiants de test à courte durée sans qu’on ait à les copier nulle part. Quand le bon chemin coûte zéro seconde de plus que le mauvais, le mauvais perd l’essentiel de son attrait.
L’intégration continue, grande bavarde
Section intitulée « L’intégration continue, grande bavarde »Les plateformes d’intégration continue ont appris à masquer les secrets dans leurs journaux : quand une valeur déclarée comme secrète apparaît dans la sortie, elle est remplacée par des astérisques. C’est utile, et c’est plus fragile qu’on ne le croit. Le masquage repose sur la reconnaissance de la chaîne exacte. Qu’un script l’encode en base64, la découpe, l’affiche avec un préfixe ou en change la casse, et elle apparaît en clair. Un mode de trace activé pour déboguer, un outil qui affiche sa configuration complète au démarrage, un message d’erreur qui cite la requête HTTP entière suffisent.
S’y ajoutent les artefacts et les caches, qui conservent parfois des fichiers générés contenant des identifiants, et les images de conteneurs. Un secret copié dans une couche puis supprimé dans une couche suivante reste présent dans la première : l’image finale ne le montre pas, mais quiconque récupère l’image peut en extraire les couches. On a donc, encore une fois, publié le secret et l’acte de sa suppression, ce qui a au moins le mérite de la cohérence.
Supprimer le commit ne suffit pas
Section intitulée « Supprimer le commit ne suffit pas »Supposons la fuite constatée. Un secret a été poussé dans un dépôt. La réaction instinctive, et celle que décrivent encore beaucoup de guides pressés, est de réécrire l’historique pour l’en retirer.
On peut le faire. Des outils comme git filter-repo réécrivent l’historique en retirant un fichier ou en remplaçant une chaîne dans tous les commits. Il faut ensuite forcer la poussée, ce qui change l’identifiant de chaque commit réécrit, et demander à chaque personne qui possède un clone de le jeter et d’en refaire un. C’est une opération lourde, perturbante, et parfaitement légitime comme mesure d’hygiène.
Mais il faut être clair sur ce qu’elle accomplit : rien, du point de vue de la sécurité du secret. Toutes les copies évoquées plus haut existent toujours. Les clones des collaborateurs, les caches des plateformes, les forks, les miroirs, les sauvegardes, les journaux, et surtout la copie qu’a pu en faire quiconque avait accès au dépôt pendant l’exposition. Sur un dépôt public, il faut ajouter les robots qui parcourent en continu les nouvelles publications à la recherche de motifs d’identifiants, et dont la diligence ferait honte à bien des équipes d’exploitation. Plusieurs expériences publiques ont montré que des clés délibérément exposées pouvaient être essayées très peu de temps après la poussée.
D’où la règle, qui ne souffre pas d’exception : un secret qui a été poussé est compromis, et la seule réparation est la rotation. Le révoquer, en émettre un nouveau, déployer le nouveau, vérifier que l’ancien ne fonctionne plus. La réécriture de l’historique vient après, si elle vient, pour éviter que le prochain lecteur ne tombe sur une clé morte et ne perde son temps à l’essayer, ce qui est une forme de courtoisie envers l’attaquant.
L’ordre des opérations compte :
- Révoquer ou tourner le secret, immédiatement, avant toute autre chose.
- Examiner les journaux du service concerné pour savoir si le secret a été utilisé pendant l’exposition, et par qui. C’est une question à laquelle on ne peut répondre que si ces journaux existent, et le moment de le découvrir est mal choisi.
- Rechercher les autres secrets exposés au même endroit ou de la même manière : un secret rarement voyage seul.
- Nettoyer l’historique, éventuellement, et corriger ce qui a permis la fuite.
Pourquoi la rotation fait si peur
Section intitulée « Pourquoi la rotation fait si peur »Si la réponse est si simple, pourquoi ne la pratique-t-on pas spontanément ? Parce que, dans beaucoup de systèmes, tourner un secret est une opération risquée, et c’est là que la fuite révèle une maladie plus profonde qu’elle-même.
Le secret fuité est souvent partagé par plusieurs services. Personne ne sait exactement lesquels. Il a été créé il y a des années par quelqu’un qui est parti. Il est copié dans trois fichiers de configuration, deux coffres, une variable d’intégration continue et un tableur dont chacun nie l’existence. Le changer, c’est risquer de casser la production sans savoir où. Alors on hésite, on remet à plus tard, on se persuade que « le dépôt est privé », et le secret compromis reste valide. C’est l’incident qui ne se produit pas encore, soigneusement entretenu.
Un secret qu’on n’ose pas tourner est déjà un incident, simplement différé. La fuite dans le dépôt ne fait que le rendre visible. Le vrai chantier n’est donc pas la détection, c’est la capacité à tourner n’importe quel secret sans trembler : un propriétaire identifié, une liste de consommateurs, une procédure éprouvée, idéalement automatisée. C’est l’objet d’une page entière sur l’exploitation des clés et leur rotation, et ce n’est pas un hasard si cette page parle plus d’organisation que de cryptographie.
Chercher ce qui est déjà là
Section intitulée « Chercher ce qui est déjà là »Avant de prévenir, il faut savoir ce qui dort déjà dans les historiques. Les outils spécialisés (gitleaks, TruffleHog et d’autres) font ce travail bien mieux qu’un humain, avec des centaines de motifs de jetons connus et, pour certains, la vérification active de la validité des identifiants trouvés auprès du fournisseur. Leurs options changent d’une version à l’autre ; la documentation de la version installée fait foi.
Git permet déjà, sans rien installer, quelques recherches instructives en lecture seule :
# Tous les commits, toutes branches, dont le diff ajoute ou retire un motif# (ici le préfixe des identifiants de clé d'accès AWS, à titre d'exemple)git log --all -p -G 'AKIA[0-9A-Z]{16}'
# Fichiers d'environnement ou de clés ayant existé à un moment de l'histoiregit log --all --full-history --name-only --format='%h %ad %an' -- \  '*.env' '*.pem' '*id_rsa*' '*.tfstate'
# Fichiers supprimés au fil de l'histoire : les suppressions sont des indicesgit log --all --diff-filter=D --name-only --format='%h %s'
Ces commandes n’écrivent rien et ne réécrivent rien. Elles donnent un ordre de grandeur, et l’ordre de grandeur est souvent éloquent. Quand elles trouvent quelque chose, l’ordre des opérations est celui de la section précédente : la rotation d’abord, la curiosité ensuite.
Les motifs à haute entropie posent un problème à part. Une clé aléatoire se reconnaît à son désordre statistique, mais un condensé de fichier, un identifiant de commit ou une donnée encodée aussi. Les détecteurs qui s’appuient sur l’entropie produisent donc des faux positifs en quantité, et une équipe noyée sous les faux positifs finit par ignorer les alertes, vrais positifs compris. Les formats de jetons modernes qui portent un préfixe identifiable facilitent grandement la détection fiable ; c’est l’une des rares améliorations de sécurité qui soit venue d’une décision de format, et elle mérite d’être saluée.
Détecter avant le commit
Section intitulée « Détecter avant le commit »La meilleure fuite est celle qui n’a pas lieu. Il y a trois moments pour l’intercepter, et chacun a ses faiblesses.
Sur le poste, avant le commit. Un hook de pré-commit analyse les modifications et refuse celles qui contiennent un secret. C’est le moment idéal : rien n’a quitté la machine, la correction coûte quelques secondes. Le cadre pre-commit rend l’installation assez simple :
repos: - repo: https://github.com/gitleaks/gitleaks rev: v8.0.0 # remplacer par une version précise et récente, épinglée hooks: - id: gitleaksDeux limites, cependant. Les hooks Git ne sont pas versionnés avec le dépôt au sens où ils s’installeraient seuls : chaque développeur doit les activer sur son clone, et un nouveau venu qui ne l’a pas fait n’est protégé par rien. Et un hook se contourne en une option (--no-verify), que tout développeur pressé connaît, et que tout développeur pressé utilise précisément le jour où il ne faudrait pas.
Sur la plateforme, à la poussée. Plusieurs plateformes d’hébergement proposent une protection qui refuse une poussée contenant un secret reconnu. L’avantage est décisif : elle s’applique à tout le monde, sans installation, et ne se contourne pas par une option locale. La limite est qu’elle ne reconnaît que les formats qu’elle connaît, et que la politique de contournement (un bouton « c’est un faux positif ») doit être surveillée, sans quoi on a simplement déplacé le --no-verify vers une interface web.
Dans l’intégration continue, après coup. Une analyse systématique des dépôts, de leurs historiques et des artefacts produits. C’est un filet, pas une barrière : quand il attrape quelque chose, le secret est déjà poussé, donc déjà à tourner. Son rôle est de réduire la durée d’exposition, et de mesurer si les deux premiers niveaux fonctionnent.
La combinaison des trois est raisonnable. Aucun ne dispense de la rotation, et aucun n’attaque la cause.
Des secrets qui n’ont rien à faire dans le code
Section intitulée « Des secrets qui n’ont rien à faire dans le code »La cause est simple à énoncer : le code et ses secrets vivent au même endroit. Tant que l’application lit son mot de passe de base de données dans un fichier qui se trouve à côté de son code source, il y aura des jours où ce fichier finira dans le dépôt. Aucune vigilance ne tient face à une probabilité non nulle répétée des milliers de fois.
Le gestionnaire de secrets
Section intitulée « Le gestionnaire de secrets »La première réponse consiste à sortir les secrets du code et de ses environs pour les placer dans un gestionnaire de secrets : Vault et ses équivalents, ou les services de secrets des fournisseurs de cloud, souvent adossés à un KMS. L’application récupère ses secrets à l’exécution, en s’authentifiant auprès du gestionnaire ; le code ne contient qu’une référence (« le secret nommé tel »), jamais la valeur. Les accès sont journalisés, les droits sont définis par secret, la rotation est centralisée.
Les gestionnaires les plus avancés vont plus loin avec les secrets dynamiques : au lieu de stocker un mot de passe de base de données valable des années, ils créent à la demande un compte temporaire avec une durée de validité courte, et le suppriment à l’expiration. Un secret qui n’existe que le temps d’une tâche est un secret qu’on ne peut pas fuir longtemps. La fuite reste possible, mais elle se périme d’elle-même, comme ces yaourts qu’on découvre au fond du réfrigérateur et dont on se dit, avec soulagement, qu’ils ne font plus de mal à personne.
Une voie intermédiaire, adaptée aux petites équipes, consiste à chiffrer les valeurs dans le dépôt avec un outil comme SOPS, les clés de déchiffrement restant dans un KMS ou détenues par les personnes autorisées. Le dépôt contient alors des secrets, mais chiffrés, et leur exposition ne vaut que ce que vaut la protection des clés. C’est la logique du chiffrement par enveloppe, appliquée à des fichiers de configuration.
Le problème du secret zéro
Section intitulée « Le problème du secret zéro »Le gestionnaire de secrets déplace le problème d’un cran, et il faut le dire franchement : pour obtenir ses secrets, l’application doit s’authentifier auprès du gestionnaire. Avec quoi ? Avec un secret. Ce secret-là, où est-il stocké ? On pourrait continuer longtemps, dans une régression dont les philosophes grecs auraient fait un traité et les administrateurs systèmes un ticket.
La régression s’arrête quand l’identité ne repose plus sur un secret stocké, mais sur un fait vérifiable de l’environnement : l’application tourne sur telle machine virtuelle, dans tel compte de cloud, sous tel compte de service d’un cluster, et la plateforme qui l’héberge est capable d’en attester cryptographiquement. C’est le principe des identités de charge de travail, et c’est ce qui permet, pour la première fois, d’envisager des systèmes où aucun humain ne manipule jamais de secret à longue durée de vie.
La CI sans secret : les identités fédérées
Section intitulée « La CI sans secret : les identités fédérées »L’intégration continue est l’endroit où ce principe a le plus changé la pratique, parce que c’est là que les secrets à longue durée de vie étaient les plus nombreux et les plus exposés. Pendant des années, déployer depuis un pipeline consistait à créer une clé d’accès permanente chez le fournisseur de cloud, à la coller dans les variables secrètes du pipeline, et à ne plus jamais y penser. Ces clés dormantes, jamais tournées, aux droits souvent trop larges, sont exactement ce qu’un attaquant recherche en priorité pour s’installer durablement, comme le décrit la page sur la persistance IAM.
La fédération d’identité par OIDC remplace ce schéma. À chaque exécution, la plateforme d’intégration continue émet un jeton signé (JWT) qui décrit le contexte : quel dépôt, quelle branche, quel environnement, quel flux. Le fournisseur de cloud a été configuré pour faire confiance à cet émetteur, sous conditions portant sur ces attributs. Le pipeline échange ce jeton contre des identifiants temporaires, valables quelques minutes à quelques heures. Il n’y a plus aucun secret stocké dans le pipeline. Il n’y a plus rien à fuir dans un journal qui survive à l’exécution.
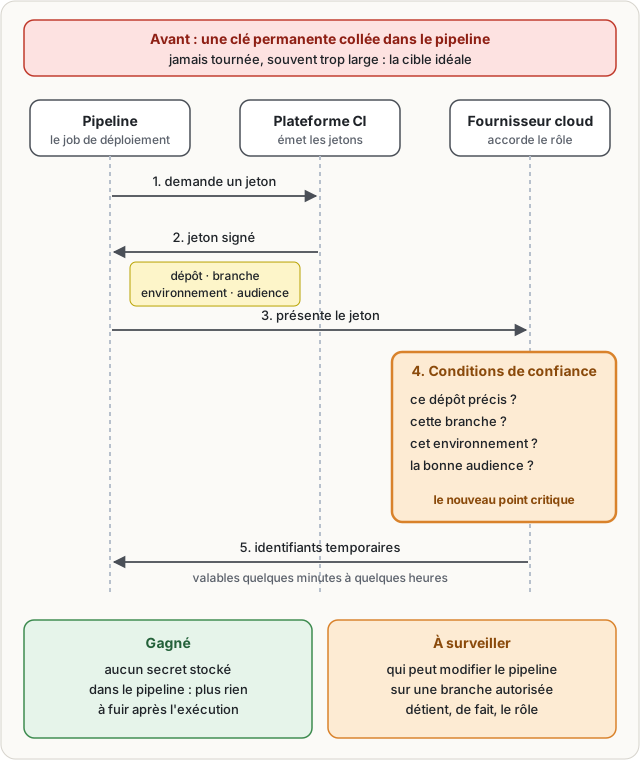
Côté pipeline, la déclaration est souvent modeste. Sur une plateforme courante, elle se réduit à autoriser l’émission du jeton :
permissions: id-token: write # autorise le job à demander un jeton OIDC contents: readLa difficulté est ailleurs, et elle est considérable : toute la sécurité repose désormais sur les conditions de confiance côté fournisseur. Une politique qui accepte les jetons de « n’importe quel dépôt de l’organisation », ou de « n’importe quelle branche », ou qui ne vérifie pas l’audience du jeton, ouvre le rôle à bien plus de monde que prévu. Si une demande de fusion ouverte par un contributeur externe peut déclencher un flux qui obtient le jeton, le contributeur externe obtient le rôle. On a supprimé le secret et donné la clé à quiconque sait ouvrir une demande de fusion, ce qui est une manière originale de résoudre le problème.
La confiance se déplace donc vers deux endroits qu’il faut traiter avec le sérieux qu’on accordait autrefois aux clés : les conditions de la relation de confiance, qui doivent désigner un dépôt précis, une branche ou un environnement précis ; et la protection de ce qui peut s’exécuter sous ces conditions, c’est-à-dire les règles de protection de branche et d’environnement, et la liste de ceux qui peuvent modifier la définition du flux. Quiconque peut modifier le fichier du pipeline sur une branche autorisée détient, de fait, le rôle. Ce n’est plus un secret, c’est un droit d’écriture, et c’est beaucoup mieux, à condition de s’en souvenir.
Le meilleur argument contraire
Section intitulée « Le meilleur argument contraire »L’objection la plus solide ne défend pas la négligence. Elle attaque la proportion.
Elle dit ceci. Un dépôt privé n’est pas un lieu public, et traiter chaque secret commité dans un dépôt interne comme une compromission est disproportionné. Les personnes qui ont accès au dépôt ont souvent accès aux mêmes systèmes par d’autres moyens ; le secret ne leur apprend rien. La rotation systématique coûte cher, casse des choses, mobilise des équipes, pour un risque théorique. Quant aux gestionnaires de secrets et aux identités fédérées, ils ajoutent une infrastructure complexe, un point de défaillance central et une courbe d’apprentissage à des équipes qui n’en ont pas les moyens. Pour une petite structure, un fichier de configuration chiffré dans le dépôt, ou même un fichier non versionné bien tenu, est un compromis raisonnable. La perfection, dit l’objection, est l’ennemie de ce qui fonctionne.
Il y a beaucoup de vrai. Le chiffrement dans le dépôt est une solution honorable, et je l’ai présenté comme telle. La complexité d’un gestionnaire de secrets n’est pas gratuite, et un gestionnaire mal exploité, avec un jeton racine qui traîne dans un fichier, est un pire endroit pour ses secrets qu’un fichier chiffré bien protégé. Et il est exact que la proportion doit guider l’effort.
Mais l’argument du dépôt privé repose sur une hypothèse que je ne peux pas accepter : que la confidentialité d’un dépôt est un état stable. Elle ne l’est pas. Un dépôt privé est cloné sur des postes portables, dans des exécuteurs d’intégration continue, dans des outils d’analyse tiers, chez des prestataires, et désormais dans le contexte des agents qui lisent tout ce qu’on leur ouvre et le recopient volontiers dans leurs journaux. Il peut devenir public par erreur de configuration, par décision de publier le code en libre, par rachat, par fuite du compte d’un collaborateur. Le secret, lui, ne sait pas que le dépôt a changé de statut. Un secret dans un dépôt privé est un secret dont la confidentialité dépend de tous les accès futurs à ce dépôt, pour toute la durée de vie du secret, qui est souvent illimitée.
D’où ma réponse à l’objection : la proportion doit porter sur les moyens, pas sur le principe. Une petite équipe n’a pas besoin d’un gestionnaire de secrets distribué. Elle a besoin que ses secrets ne soient pas en clair dans son historique, qu’elle sache les tourner, et que son pipeline n’en stocke pas de permanents quand la plateforme permet de s’en passer. Ces trois choses sont à sa portée.
Ce que je ne sais pas
Section intitulée « Ce que je ne sais pas »Je ne sais pas quelle part des secrets exposés est effectivement exploitée. Les études publiées par les éditeurs d’outils de détection donnent des ordres de grandeur sur les secrets trouvés, rarement sur les secrets utilisés, et elles sont produites par des acteurs qui ont intérêt à ce que le problème paraisse grand. Je ne dis pas qu’elles sont fausses. Je dis que je ne saurais pas en tirer un chiffre auquel je me fierais.
Je ne sais pas mesurer l’efficacité de la protection à la poussée. Elle bloque ce qu’elle reconnaît. Ce qu’elle ne reconnaît pas, par définition, ne laisse pas de trace dans ses statistiques. Qu’elle ait réduit le problème est probable ; de combien, je l’ignore.
Je ne sais pas ce que les agents de programmation feront à ce problème. Ils peuvent l’aggraver, en lisant des fichiers d’environnement, en recopiant des valeurs dans des exemples ou des journaux, en générant des configurations avec des valeurs réelles. Ils peuvent aussi l’atténuer, en appliquant plus systématiquement qu’un humain les bonnes pratiques de référence. Les deux effets existent sans doute ; leur solde m’est inconnu.
Je ne sais pas si les identités fédérées tiendront leurs promesses à grande échelle. Elles suppriment une classe entière de secrets, ce qui est considérable. Elles concentrent aussi la confiance dans des configurations de relation de confiance que peu de gens relisent, et dont les erreurs ne se voient pas avant d’être exploitées. Il est possible que la prochaine génération d’incidents vienne de là.
Ce qui reste
Section intitulée « Ce qui reste »Le secret dans le dépôt n’est pas une faute d’inattention qu’on éradiquerait par la sensibilisation. C’est le symptôme d’une architecture où le code et ses identifiants vivent au même endroit, et où les identifiants vivent trop longtemps.
Trois choses me paraissent acquises. Un secret poussé est compromis : la réécriture de l’historique est une mesure d’hygiène, jamais une réparation, et la seule réparation est la rotation. Un secret qu’on n’ose pas tourner est un incident différé : le vrai chantier est la capacité à tourner sans trembler, avec un propriétaire, des consommateurs connus et une procédure éprouvée. Et la meilleure prévention est l’absence : chaque secret à longue durée de vie remplacé par une identité fédérée ou un secret dynamique est une fuite qui ne pourra plus avoir lieu.
On passe beaucoup de temps, dans ce métier, à chercher de meilleures cachettes pour les choses qu’il faudrait cesser de posséder. Le secret le mieux gardé reste celui qui n’existe pas, maxime que je livre sans garantie aux services de renseignement, mais que je recommande sans réserve aux équipes d’exploitation.
🐝 Ce qui arrive si on s’en passe
Section intitulée « 🐝 Ce qui arrive si on s’en passe »Sans rotation, le secret poussé reste valide pour tous ceux qui en détiennent une copie, et la durée de l’exposition devient celle de la vie du secret. Même tournée, une clé exposée peut avoir servi à créer d’autres accès (une nouvelle clé, un compte de service, une relation de confiance) qui survivent à sa révocation : la rotation ferme la porte par laquelle l’attaquant est entré, pas celles qu’il a eu le temps d’ouvrir. Sans journaux couvrant toute la période d’exposition, ces portes secondaires restent invisibles, et l’intrus demeure confortablement installé au grenier pendant qu’on change la serrure de l’entrée.
🦫 Explication de la marmotte 🍫
Section intitulée « 🦫 Explication de la marmotte 🍫 »Git, l’outil qui enregistre l’historique du code, conserve chaque version de chaque fichier. Quand un mot de passe, une clé d’accès ou un jeton est enregistré par erreur puis supprimé, il reste lisible dans l’historique. Chaque copie du dépôt, sur les postes des développeurs, sur les serveurs d’intégration continue qui compilent et testent le code, dans les sauvegardes ou les copies dérivées, contient cet historique. Les secrets y arrivent par des chemins ordinaires : un fichier d’exemple copié depuis le vrai, un test rapide où la clé est écrite dans le code, un journal de compilation qui l’affiche, une image de conteneur qui la garde dans une couche intermédiaire. Des robots parcourent en permanence les dépôts publics pour les trouver. Un secret publié est donc considéré comme compromis. Réécrire l’historique ne supprime pas les copies existantes : la seule réparation est la rotation, c’est-à-dire révoquer le secret, en créer un nouveau et le déployer, puis vérifier dans les journaux s’il a été utilisé. Pour prévenir, on analyse les modifications avant l’enregistrement, au moment de l’envoi vers la plateforme, puis régulièrement. Mais la vraie solution consiste à sortir les secrets du code : un gestionnaire de secrets les fournit au programme au moment de l’exécution, parfois pour une durée courte. Mieux encore, l’identité fédérée permet au serveur d’intégration de prouver ce qu’il est et d’obtenir des accès temporaires, sans aucun secret stocké.
À lire aussi
- Prévenir les secrets codés en dur dans GitPrévenir, détecter et traiter les secrets exposés dans le code source et les environnements de développement.
- Les comptes de service oubliésLes identités non humaines (comptes de service, jetons d'API, clés de déploiement, identités de charge de travail) sont plus nombreuses que les personnes et n'ont souvent aucun propriétaire. Tant qu'on les gère comme des mots de passe qu'on aurait prêtés à une machine, on accumule des accès éternels ; il faut leur donner un cycle de vie, et préférer des identités fédérées de courte durée à des secrets qui ne meurent jamais.
- Sécuriser les identifiants CI/CD avec OIDCGuide pas-à-pas pour remplacer les secrets statiques d’un pipeline CI/CD par une authentification fédérée OIDC, isoler les jobs et limiter les droits par environnement.
- Sécuriser les secrets et permissions CI/CDSécuriser une pipeline CI/CD impose des secrets éphémères, des permissions minimales et une revue à quatre yeux réellement bloquante.
Pages voisines
La citent
- Pourquoi les CTF créent des compétences offensives réutilisables
- Certificats SSH et risques de l’agent forwarding
- Comment gouverner les coûts cloud contre un compte compromis
- Comment structurer un mentorat technique sans dogme
- Créer, vérifier et utiliser les clés dès le départ
- Déployer Vault ou OpenBao pour supprimer les secrets en clair
- Durcir les postes de développeurs contre le vol de code et secrets
Les secrets dans les dépôts Git
Elle cite