
Principes et architecture de l'événementiel
Principes et architecture de l’événementiel
Section intitulée « Principes et architecture de l’événementiel »L’architecture événementielle organise la circulation de faits métiers entre applications : une commande validée, un compte créé, un paiement refusé, une mesure reçue. Son compromis central est net : gagner du découplage, de la capacité de rejeu et de nouveaux consommateurs sans modifier le producteur, en échange d’une cohérence différée et d’une exploitation plus exigeante. Il faut l’adopter pour propager des faits stables à plusieurs domaines, pas pour déguiser chaque appel distant en message.
→ Lire l’explication complète de la marmotte
Événements, commandes et frontières de responsabilité
Section intitulée « Événements, commandes et frontières de responsabilité »Un événement décrit un fait déjà survenu et ne doit pas porter d’impératif. OrderConfirmed affirme qu’une commande est confirmée. ConfirmOrder demande de la confirmer. La différence semble grammaticale, elle est architecturale : une commande a un destinataire propriétaire de la décision ; un événement peut avoir zéro, un ou plusieurs consommateurs. Publier des commandes sur un bus partagé transforme vite les consommateurs en copropriétaires d’un processus qu’ils ne maîtrisent pas.
Un événement utile est immuable, daté, identifié et rattaché à un agrégat métier. L’agrégat est l’unité qui porte les règles de cohérence locales, par exemple une commande ou un compte. Un événement doit donc contenir au minimum un identifiant unique, le type, la date de production, la version du contrat et la clé métier permettant de conserver l’ordre lorsque celui-ci compte. Ajouter un instant de traitement par le broker ne remplace pas la date du fait métier : les deux répondent à des questions différentes.
Le broker est le composant qui accepte, conserve et distribue les messages. Apache Kafka convient aux flux persistants, aux relectures et à un débit élevé réparti par partitions. RabbitMQ convient mieux aux files de travail, aux routages souples et aux accusés de réception par message. Le choix ne se fait pas sur la popularité de l’outil. Lorsqu’un consommateur doit pouvoir rejouer plusieurs jours de données ou lorsqu’un même flux alimente des systèmes indépendants, Kafka est le choix naturel. Lorsqu’une tâche doit être confiée une fois à un worker et confirmée après exécution, une file de messages est plus simple.
L’événementiel ne supprime pas les interfaces de programmation applicative, ou API. Une API synchrone reste préférable pour une décision immédiate, une lecture nécessitant une réponse fraîche, ou une action dont l’échec doit être connu avant de poursuivre. Faire attendre une interface utilisateur derrière trois messages asynchrones est une façon sophistiquée de perdre le contrôle des erreurs. La règle pratique est simple : décider localement et publier le fait ; ne pas demander à un autre domaine de décider par événement si une API explicite est requise.
Cette séparation rejoint un principe simple : automatiser un couplage flou ne produit pas une architecture distribuée, seulement un incident plus difficile à lire.
Livraison, ordre et cohérence : les garanties réelles
Section intitulée « Livraison, ordre et cohérence : les garanties réelles »Un broker ne livre pas magiquement « exactement une fois » de bout en bout. Kafka peut fournir des garanties fortes dans certaines séquences de production et de consommation, mais une écriture dans une base de données, l’envoi d’un courriel ou l’appel d’une API externe sortent de ce périmètre. Dès qu’un effet de bord quitte le broker, un crash entre l’effet et l’accusé de réception rend la duplication possible.
La garantie opérationnelle réaliste est donc « au moins une fois ». Un consommateur doit être idempotent : traiter deux fois le même événement doit produire le même résultat observable qu’un seul traitement. Cela impose un identifiant d’événement stable, stocké avec l’effet produit dans la même transaction locale. Dédupliquer en mémoire ne vaut rien après un redémarrage ; dédupliquer avec une durée de vie arbitraire revient à accepter les doublons tardifs sans l’écrire.
L’ordre n’est généralement garanti qu’à l’intérieur d’une partition, pas entre toutes les partitions d’un sujet. Pour Kafka, utiliser la même clé de partitionnement pour tous les événements d’une même commande garantit leur ordre relatif dans cette commande. Utiliser un identifiant aléatoire répartit mieux la charge, mais autorise OrderShipped à arriver avant OrderConfirmed. Ce compromis doit être formulé dans le contrat. Si l’ordre global est exigé, le débit parallélisable s’effondre : une seule partition devient le goulot d’étranglement. Dans la plupart des cas, l’ordre par agrégat suffit.
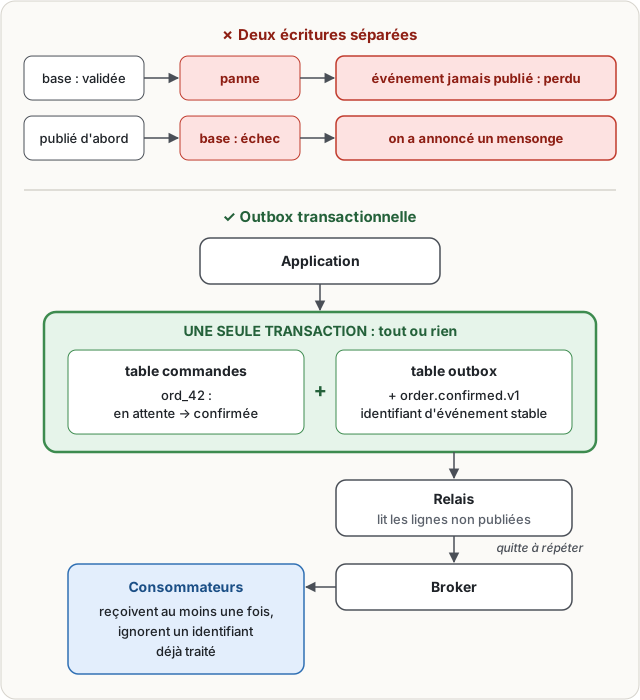
Le pattern transactional outbox résout le trou classique entre la base métier et la publication. L’application écrit la modification métier et une ligne d’outbox dans une seule transaction. Un relais publie ensuite cette ligne, avec possibilité de répétition. Sans outbox, deux écritures indépendantes créent une fenêtre impossible à sécuriser : valider la commande puis tomber avant publication perd l’événement ; publier puis échouer à valider publie un mensonge.
La rétention du broker n’est pas une sauvegarde. Elle autorise le rejeu tant que les données sont conservées, mais elle ne protège ni contre une suppression administrative, ni contre un chiffrement mal géré, ni contre une corruption logique propagée à tous les consommateurs. La stratégie de sauvegarde et de restauration du cluster doit être documentée séparément, avec tests de restauration.
Contrats de message et évolution sans casse
Section intitulée « Contrats de message et évolution sans casse »Un sujet, ou topic, est une frontière de compatibilité. Son nom doit exprimer un domaine et un fait, pas une table interne ni un détail d’implémentation. billing.invoice-issued.v1 est lisible ; db.public.invoice_update annonce une fuite de modèle de données. Publier une ligne de base brute lie chaque consommateur au schéma de stockage du producteur, ce qui rend toute migration coûteuse.
JavaScript Object Notation, ou JSON, reste pratique pour l’inspection et l’intégration. Apache Avro apporte un schéma compact et une compatibilité contrôlable, à condition d’utiliser un registre de schémas et de faire respecter les règles au pipeline de déploiement. JSON Schema remplit un rôle voisin quand JSON doit rester le format transporté. Le format compte moins que le contrôle : un contrat sans validation automatisée est une convention orale avec des accolades.
L’évolution sûre consiste à ajouter des champs facultatifs, à conserver les champs existants et à versionner explicitement les changements incompatibles. Renommer un champ n’est pas un changement mineur, même si le nom paraît absurde. Supprimer une valeur d’énumération non plus. Un consommateur ancien peut être arrêté pendant une maintenance, puis reprendre la lecture d’événements produits selon le nouveau contrat. La compatibilité doit donc couvrir les producteurs et consommateurs qui coexistent réellement.
Les données personnelles et secrets ne doivent pas être transportés par commodité. Un événement persistant est souvent lu par davantage de composants qu’anticipé lors de sa création, parfois des mois plus tard pendant un rejeu. Publier un identifiant de référence est préférable à publier un dossier complet. Si une donnée sensible est indispensable, définir sa classification, sa durée de conservation, les groupes autorisés et le mécanisme d’effacement. Un topic n’est pas une zone franche parce qu’il porte le mot « interne ».
Rejeu, erreurs et exploitation du flux
Section intitulée « Rejeu, erreurs et exploitation du flux »Un consommateur ne doit accuser réception qu’après le traitement durable de l’événement. Accuser avant l’écriture locale perd le message lors d’une panne. Accuser après une écriture non idempotente crée un doublon lors d’une panne. Il n’existe pas de troisième option magique : la transaction locale et la déduplication sont la réponse robuste.
Les erreurs transitoires justifient quelques tentatives avec temporisation croissante. Une indisponibilité de base de données ou une limite de débit externe peut se résorber. Une erreur de validation, un schéma inconnu ou une référence métier définitivement absente ne se résout pas par cinquante tentatives. Après un nombre borné d’échecs, envoyer l’événement dans une file de quarantaine, souvent appelée dead-letter queue, ou DLQ. Conserver le contenu original, les en-têtes, l’erreur, le nombre de tentatives et la date. Une DLQ sans procédure de tri et de rejeu est une décharge numérique soigneusement étiquetée.
Le rejeu doit être considéré comme une opération de production risquée. Rejouer payment.captured peut redéclencher un effet externe si l’idempotence est incomplète. Rejouer un événement obsolète peut aussi écraser un état plus récent. Avant le rejeu, définir la plage concernée, l’identité d’exécution, les protections contre les appels externes et le critère d’arrêt. Un environnement de test qui ne reproduit pas les événements dupliqués, désordonnés et retardés ne teste que le chemin agréable.
L’observabilité doit mesurer l’âge du plus ancien événement non traité, le retard de consommation, le taux d’échec, la taille de la DLQ et la durée de bout en bout entre production et effet métier. Le nombre de messages par seconde est utile, mais il ne dit pas si une facture attend depuis six heures. Corréler les journaux avec event_id, aggregate_id et un identifiant de trace permet de suivre un fait sans exposer sa charge sensible. Cette discipline est celle d’une architecture durable : les métriques doivent révéler une décision à prendre, pas décorer un tableau de bord.
Sécuriser et documenter les échanges
Section intitulée « Sécuriser et documenter les échanges »Transport Layer Security, ou TLS, protège le transport entre producteurs, broker et consommateurs. Il ne remplace ni l’authentification ni les autorisations. Chaque identité de service doit recevoir le droit minimal : publier sur un sujet précis, lire un groupe précis, administrer uniquement si nécessaire. Autoriser * sur tous les sujets pour débloquer une recette est une dette de sécurité qui survit étonnamment bien aux recettes.
Le chiffrement au repos protège les supports, mais ne limite pas un consommateur autorisé à lire un événement. La vraie barrière est la séparation des sujets, des identités et des droits. Les journaux applicatifs doivent également filtrer les champs sensibles : chiffrer un flux puis copier sa charge dans des logs centralisés annule le bénéfice avec une efficacité presque artistique.
La documentation d’un flux doit tenir dans un contrat exploitable : propriétaire du sujet, finalité métier, producteurs, consommateurs connus, clé de partitionnement, garantie de livraison, rétention, schéma, politique de compatibilité, données sensibles, stratégie de reprise et alertes. Documenter également les dépendances externes déclenchées par les consommateurs. Une cartographie qui s’arrête au broker masque précisément les effets les plus dangereux.
Faut-il un broker pour chaque échange asynchrone ?
Section intitulée « Faut-il un broker pour chaque échange asynchrone ? »Non. Une tâche locale peut être exécutée par un ordonnanceur ou une file interne. Introduire un broker distribué devient pertinent lorsqu’il faut isoler producteurs et consommateurs, répartir la charge, conserver les messages ou alimenter plusieurs systèmes indépendants.
Peut-on supprimer les API avec l’événementiel ?
Section intitulée « Peut-on supprimer les API avec l’événementiel ? »Non. Les API restent nécessaires pour les commandes nécessitant une réponse immédiate, les consultations et les opérations d’administration. L’événementiel propage des faits ; il ne remplace pas une décision synchrone quand cette décision conditionne la suite.
Combien de temps conserver les événements ?
Section intitulée « Combien de temps conserver les événements ? »La durée dépend du besoin de rejeu, des obligations de conservation, du volume et de la sensibilité des données. Une durée arbitraire de sept jours n’est pas une politique. Définir le délai maximal de reprise d’un consommateur, puis vérifier que stockage, sauvegarde et coûts suivent réellement.
🐝 Ce que ça change côté sécurité
Section intitulée « 🐝 Ce que ça change côté sécurité »Un bus d’événements se protège en couches. À l’entrée, la garde : TLS mutuel ou authentification forte par service, puis des autorisations nominatives par sujet et par groupe de consommation, jamais de joker sur l’ensemble des topics. Au centre, la sélection de ce qui circule : un événement persistant ne transporte que des identifiants de référence lorsque la donnée est sensible, avec classification, durée de conservation et mécanisme d’effacement définis. En surveillance, l’alerte collective : suivre l’âge du plus ancien événement non traité, la croissance de la file de quarantaine, les refus d’autorisation et les publications sur des sujets inattendus. En réponse, l’essaim : révocation d’identité, isolement du sujet concerné, et rejeu contrôlé avec plage bornée et effets externes neutralisés. Les journaux applicatifs filtrent les champs sensibles, sans quoi le chiffrement du transport devient décoratif.
🪵 Comment le vérifier
Section intitulée « 🪵 Comment le vérifier »Pour vérifier que l’idempotence tient réellement, monter un labo minimal : un broker local (Kafka ou RabbitMQ en conteneur), un producteur qui publie dix événements portant chacun un event_id stable, et un consommateur qui écrit en base puis accuse réception. Tuer le consommateur juste après l’écriture, avant l’accusé, puis le redémarrer. Compter les lignes produites. Si la table de déduplication n’est pas écrite dans la même transaction que l’effet métier, des doublons apparaissent. Répéter en supprimant la clé de partitionnement par agrégat : observer un événement d’expédition traité avant l’événement de confirmation. Ces deux essais prouvent que « au moins une fois » et l’ordre partiel sont des propriétés du code consommateur, pas du broker.
🦫 Explication de la marmotte 🍫
Section intitulée « 🦫 Explication de la marmotte 🍫 »Une architecture événementielle sert à transmettre des faits entre plusieurs programmes. Lorsqu’une action est terminée, le programme responsable crée un message qui indique ce qui s’est passé. Ce message contient un identifiant unique, une date, un type et les informations nécessaires aux autres programmes.
Le message est envoyé à un service chargé de le conserver et de le distribuer. Les programmes intéressés le lisent ensuite. Certains peuvent le lire immédiatement, d’autres plus tard. Un même message peut servir à mettre à jour une base de données, préparer une facture et envoyer une notification.
Le système ne garantit pas toujours qu’un message arrive une seule fois. Un programme doit donc mémoriser les identifiants déjà traités pour éviter de refaire une action. Il faut aussi choisir une clé commune pour les messages concernant le même objet, afin de conserver leur ordre de traitement.
Quand le programme qui produit le message modifie aussi ses propres données, les deux opérations doivent être enregistrées ensemble. Sinon, une panne peut laisser une modification sans message, ou un message annonçant une modification inexistante.
Les messages suivent une structure définie à l’avance. Cette structure peut évoluer, mais supprimer ou renommer une information peut empêcher un ancien programme de fonctionner. En cas d’erreur durable, le message est isolé pour analyse. Enfin, les accès sont limités : chaque programme ne doit lire et écrire que les messages nécessaires.
À lire aussi
- Sécuriser event sourcing et CQRS à grande échelleSécurité, audit, intégrité et exploitation des architectures event-driven fondées sur l’event sourcing et CQRS.
- Monolithe ou microservices : choisir sans se mentirComparaison technique des architectures monolithique et microservices, avec le coût réel du découpage, ses effets sur la sécurité, l'observabilité et l'exploitation.
- Comment sécuriser les webhooks entrantsAuthentifier un webhook par signature HMAC, bloquer les rejouements et rendre son traitement idempotent.
- Sécuriser un contrat API-first dès la conceptionConcevoir un contrat d’API comme une frontière de confiance, avec authentification, autorisation, validation et exploitation sécurisées.
Pages voisines
La citent
- Monolithe ou microservices : choisir sans se mentir
- Sécuriser event sourcing et CQRS à grande échelle
- Comment sécuriser les webhooks entrants
- Sécuriser les systèmes de recommandation contre l’empoisonnement
Principes et architecture de l'événementiel
Elle cite