
La politique de même origine : ce que le navigateur cloisonne vraiment
La politique de même origine : ce que le navigateur cloisonne vraiment
Section intitulée « La politique de même origine : ce que le navigateur cloisonne vraiment »Tout ce qu’un navigateur protège repose sur une notion que presque personne ne sait énoncer exactement. On parle de XSS, de CSRF, de cookies, de CORS, sans jamais revenir au socle : qu’est-ce qu’une origine, qu’est-ce qu’elle sépare, et surtout qu’est-ce qu’elle ne sépare pas. La RFC 6454, publiée en décembre 2011 et rédigée par Adam Barth, est le document qui a mis cette notion par écrit après qu’elle avait, dit-elle, « évolué largement de manière organique ». Elle mérite une lecture, parce qu’elle est brève et qu’elle dit franchement là où le modèle est bancal.
→ Lire l’explication complète de la marmotte
Le triplet : schéma, hôte, port
Section intitulée « Le triplet : schéma, hôte, port »Le navigateur pourrait traiter chaque adresse comme un domaine de protection distinct. La RFC écarte cette option d’une phrase : ce serait « encombrant pour les développeurs, parce que les applications web consistent souvent en un ensemble de ressources agissant de concert ». Il groupe donc les adresses en domaines de protection appelés origines, et la règle est que, pour l’essentiel, deux adresses appartiennent à la même origine si elles ont le même schéma, le même hôte et le même port.
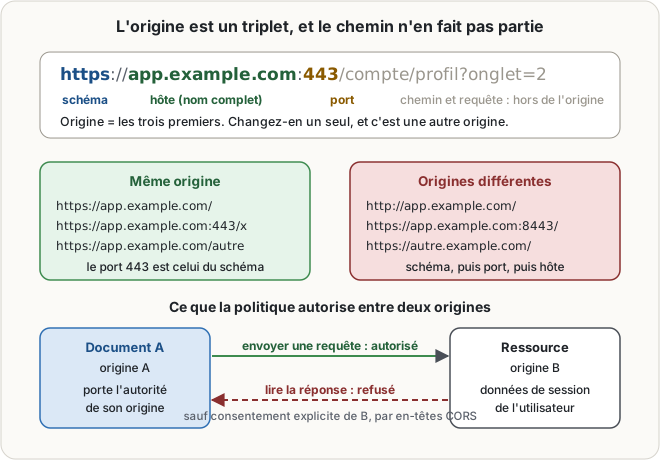
La RFC prend la peine de justifier les deux choix qui surprennent, sous forme de questions et réponses. Pourquoi inclure le schéma ? Parce que « sans cette isolation, un attaquant actif du réseau pourrait corrompre un contenu récupéré depuis http://example.com et faire en sorte que ce contenu instruise le navigateur de compromettre la confidentialité et l’intégrité du contenu récupéré depuis https://example.com, contournant les protections offertes par TLS ». La séparation http et https n’est pas un détail d’hygiène : c’est ce qui empêche la version non chiffrée d’un site de piloter sa version chiffrée. Cela vaut d’être rappelé à qui laisse encore un virtuel hôte en clair « juste pour la redirection », et la mécanique du canal protégé est détaillée dans sécuriser un canal avec TLS.
Pourquoi le nom d’hôte complet, et non le domaine de premier niveau ? Parce que les relations de confiance entre noms d’hôtes « varient selon les déploiements ». La RFC donne un exemple scolaire au sens propre : dans beaucoup d’établissements d’enseignement, les étudiants publient sous https://example.edu/~etudiant/, et il n’y a aucune raison qu’un document rédigé par un étudiant habite le même domaine de protection que l’application de gestion des notes hébergée sur https://notes.example.edu/. Elle reconnaît aussitôt la limite : dans ce déploiement, tous les sites étudiants partagent la même origine, « ce qui n’est peut-être pas souhaitable », et conclut que « la granularité de l’origine est, en un sens, un artefact historique de la manière dont le modèle de sécurité a évolué ». Un standard qui admet que son unité d’isolation est un accident de l’histoire mérite qu’on l’écoute.
Ce que l’origine cloisonne : les objets
Section intitulée « Ce que l’origine cloisonne : les objets »La plupart des objets exposés par le navigateur ne sont accessibles qu’à l’intérieur d’une même origine. La RFC le formule avec un si et seulement si : un contenu récupéré depuis une adresse peut accéder aux objets associés à un contenu récupéré depuis une autre adresse « si, et seulement si, les deux adresses appartiennent à la même origine ». C’est ce qui fait qu’un script chargé dans une page ne peut pas lire l’arbre du document d’un cadre pointant ailleurs, ni le stockage local d’un autre site.
Les exceptions sont rares et délibérées. Certaines parties de l’interface de navigation sont accessibles entre origines, pour permettre de naviguer ; l’interface de messagerie entre fenêtres l’est explicitement, pour permettre une communication contrôlée. La RFC les accompagne d’un avertissement qui vaut pour toute conception : « exposer des objets à des origines étrangères est dangereux et ne devrait être fait qu’avec grand soin, parce que cela expose ces objets à des attaquants potentiels ». Autrement dit, chaque passerelle inter-origine ouverte sciemment est une surface d’attaque assumée, pas un service gratuit.
Ce qu’elle ne cloisonne pas : l’envoi
Section intitulée « Ce qu’elle ne cloisonne pas : l’envoi »Voici le point que la plupart des développeurs comprennent de travers, et il explique à lui seul une classe entière de vulnérabilités. La RFC distingue deux directions. « Généralement, lire une information depuis une autre origine est interdit. » Mais : « Envoyer une information vers une autre origine est permis. »
La conséquence est écrite noir sur blanc dans la section consacrée aux pièges : « la capacité d’envoyer des requêtes réseau vers une autre origine donne naissance aux vulnérabilités de falsification de requête inter-sites ». Un document hostile ne peut pas lire la réponse de votre application, mais il peut lui faire parvenir une requête, et le navigateur y joindra les cookies de l’utilisateur comme il le fait d’habitude. Toute la protection contre cette classe d’attaques repose donc ailleurs que sur l’origine : sur les attributs du cookie de session, traités dans les attributs du cookie de session, et sur des jetons que l’attaquant ne peut pas deviner.
La RFC explique aussi pourquoi les navigateurs n’ont pas simplement interdit l’envoi, et la réponse est désarmante de bon sens : « un navigateur HTML qui bloquerait les requêtes réseau inter-origines empêcherait ses utilisateurs de suivre des hyperliens, une fonctionnalité centrale du web ». Les implémenteurs mettent donc en balance ces risques et les bénéfices de l’interaction inter-origine, et c’est la raison pour laquelle le modèle reste un compromis plutôt qu’une forteresse. Autres fuites assumées du même ordre : « la capacité d’afficher des images depuis une autre origine divulgue leur hauteur et leur largeur », ce qui suffit à inférer des choses qu’on préférerait garder.
Une origine peut évidemment consentir à se laisser lire, et c’est l’objet du partage de ressources entre origines, le mécanisme désigné par l’acronyme CORS : des en-têtes de réponse par lesquels la ressource déclare quelles origines ont le droit de lire ce qu’elle renvoie. Deux idées à retenir : l’autorisation est accordée par origine, et c’est la ressource visée qui l’accorde, jamais l’appelant. Un Access-Control-Allow-Origin reflétant l’origine de la requête sans vérification revient donc à autoriser tout le monde, avec en prime la conviction d’avoir configuré quelque chose. Et comme cette réponse varie selon l’origine demandeuse, elle doit être déclarée au cache, sujet de la clé de cache HTTP.
L’autorité n’est pas l’origine : contenu actif, contenu passif
Section intitulée « L’autorité n’est pas l’origine : contenu actif, contenu passif »Toutes les ressources d’une origine ne portent pas la même autorité, et cette distinction est la plus utile de la RFC pour qui héberge du contenu déposé par des utilisateurs. « Une image est un contenu passif et ne porte donc aucune autorité, ce qui signifie que l’image n’a aucun accès aux objets et aux ressources disponibles pour son origine. À l’inverse, un document HTML porte l’autorité complète de son origine. »
C’est le type de média annoncé par le serveur qui détermine l’autorité accordée. D’où la recommandation, qui vaut mieux que bien des articles : « lorsqu’elles hébergent du contenu non fiable, comme du contenu produit par les utilisateurs, les applications web peuvent limiter l’autorité de ce contenu en restreignant son type de média. Par exemple, servir du contenu produit par les utilisateurs en image/png est moins risqué que de le servir en text/html ». Et la RFC nomme la conséquence du contraire : une application qui incorpore du contenu non fiable dans ses documents HTML risque, si elle le fait sans soin, « de fuiter l’autorité de son origine vers le contenu non fiable, une vulnérabilité communément appelée cross-site scripting », mécanisme détaillé dans la page sur le XSS.
Il reste une faille dans ce raisonnement, et la RFC la signale : certains navigateurs, pour rester compatibles avec des serveurs qui annoncent des types incorrects, pratiquent le reniflement de contenu et traitent une ressource comme si elle avait un autre type. « Si cela n’est pas fait avec soin, le reniflement de contenu peut conduire à des vulnérabilités de sécurité, parce que les navigateurs pourraient accorder à des types de média de faible autorité, comme les images, les privilèges de types de média de forte autorité, comme les documents HTML. » C’est exactement l’attaque décrite dans le reniflement MIME par fichier téléversé, et l’en-tête qui la désactive est la contre-mesure la moins chère du web.
Dernière conséquence pratique, souvent ignorée des concepteurs : il est inutile d’accorder un privilège à une ressource et de le refuser à une autre ressource de la même origine. La RFC est catégorique : « refuser des privilèges de cette manière est inefficace, parce que la ressource qui ne les a pas peut généralement les obtenir de toute façon, les navigateurs n’isolant pas les ressources à l’intérieur d’une origine ». Les privilèges s’accordent ou se refusent à des origines entières. Un chemin n’est pas une frontière de sécurité, ce qui condamne au passage l’idée de ranger une administration sensible sous /admin/ du même hôte.
Les trois faiblesses systémiques, telles que la RFC les reconnaît
Section intitulée « Les trois faiblesses systémiques, telles que la RFC les reconnaît »La RFC consacre une section à ses propres limites, et elle en nomme trois. La dépendance au DNS d’abord : « en pratique, la politique de même origine repose sur le DNS pour la sécurité, car beaucoup de schémas d’URI couramment utilisés, comme http, emploient des autorités de nommage fondées sur le DNS. Si le DNS est partiellement ou totalement compromis, la politique de même origine peut échouer à fournir les propriétés de sécurité requises par les applications. » Le schéma https y résiste mieux, parce que le navigateur vérifie la source par des certificats. Les manières de corrompre une résolution sont l’objet de l’empoisonnement de cache DNS, et l’on mesure ici que cette attaque ne casse pas seulement un acheminement : elle casse l’unité d’isolation du navigateur.
Les unités d’isolation divergentes ensuite, et c’est la plus pernicieuse. Des technologies antérieures au concept moderne d’origine, les cookies au premier chef, « ont souvent des unités d’isolation différentes, ce qui conduit à des vulnérabilités ». Un cookie n’est pas cloisonné par origine mais par domaine et chemin, il ignore le port, et il ignore parfois le schéma : deux documents d’origines différentes au sens de cette RFC peuvent donc partager le même cookie. La RFC déconseille explicitement, en majuscules dans le texte, d’utiliser le domaine enregistrable plutôt que le nom d’hôte complet comme unité d’isolation, pour une raison qui mérite d’être connue : la notion de domaine « contrôlé par un registre » est « une fonction des pratiques humaines autour du DNS plutôt qu’une propriété du DNS lui-même », les listes de suffixes publics sont difficiles à tenir à jour et varient d’une implémentation à l’autre.
L’autorité ambiante enfin, qui est le défaut conceptuel du modèle. Le navigateur accorde une autorité à un contenu « en fonction de son adresse plutôt qu’en fonction des objets que ce contenu peut désigner », ce qui est un cas d’école d’autorité ambiante. Un script injecté dans un document s’exécute avec l’autorité de l’origine du document ; si l’autorité du script était limitée aux objets qu’il peut désigner, l’injection ne rapporterait rien. On retrouve ici le débat général entre listes de contrôle d’accès et capacités, exposé dans la sécurité par capacités contre les ACL. Et pour compléter le tableau, la RFC signale qu’un changement d’algorithme de traitement des noms de domaine internationalisés « pourrait redessiner un certain nombre de frontières de sécurité », voire « abattre des frontières de sécurité entre deux entités qui se méfient mutuellement ». Autant dire que la frontière n’est pas gravée dans la pierre.
- RFC 6454 : The Web Origin Concept, A. Barth, IETF, décembre 2011.
🐝 Ce qui arrive si on s’en passe
Section intitulée « 🐝 Ce qui arrive si on s’en passe »Sans séparation des schémas, un hôte servi en clair à côté du même hôte servi en TLS n’est pas une négligence cosmétique : le contenu non chiffré, modifiable par un attaquant sur le chemin réseau, peut piloter le contenu chiffré et annuler le bénéfice du chiffrement. Sans compréhension de l’asymétrie lecture et envoi, une application se croit protégée par le navigateur alors que n’importe quel site peut lui faire parvenir des requêtes authentifiées par les cookies de l’utilisateur. Sans restriction du type de média sur le contenu déposé par les utilisateurs, un fichier accepté comme image obtient l’autorité complète de l’origine et accède à tout ce qu’un script de l’application pourrait atteindre. Sans en-tête interdisant le reniflement de contenu, le navigateur peut requalifier ce fichier de son propre chef et produire le même résultat. Et sans conscience que le cookie n’a pas la même unité d’isolation que l’origine, deux applications réputées cloisonnées, parce qu’elles diffèrent par le port ou le sous-domaine, partagent en réalité une session.
🦫 Explication de la marmotte 🍫
Section intitulée « 🦫 Explication de la marmotte 🍫 »Un navigateur affiche en même temps des pages venues de sites différents, et il faut bien qu’elles ne puissent pas se lire mutuellement : sinon, une page ouverte dans un onglet lirait votre messagerie dans l’autre. La règle qui l’empêche s’appelle la politique de même origine, et l’origine d’une page, c’est trois choses prises ensemble : le protocole (http ou https), le nom complet du serveur, et le numéro de port. Le chemin après le nom du serveur n’en fait pas partie.
Conséquence immédiate, et contre-intuitive : changer un seul de ces trois éléments crée une autre origine. La version en clair et la version chiffrée d’un même site sont deux origines distinctes, et c’est volontaire, parce que la version en clair peut être modifiée par quelqu’un sur le trajet. En revanche, deux applications rangées dans deux dossiers différents du même serveur sont la même origine : le dossier ne protège rien.
Ce que la règle interdit, c’est la lecture. Une page d’un site ne peut pas lire le contenu d’une page d’un autre site. Ce que la règle n’interdit pas, c’est l’envoi : n’importe quelle page peut faire envoyer une requête à n’importe quel site, et le navigateur y joint les identifiants de session de l’utilisateur comme d’habitude. C’est pour cela qu’une application a besoin de protections supplémentaires contre les requêtes qu’un site tiers lui fait envoyer à l’insu de l’utilisateur.
Autre idée utile : tous les fichiers d’un site n’ont pas les mêmes droits. Une image ne peut rien faire ; une page HTML peut tout faire au nom de son site. Un site qui laisse ses utilisateurs déposer des fichiers doit donc les servir comme des images, et jamais comme des pages, sans quoi le fichier déposé par un inconnu obtient les droits du site.
Enfin, le document de référence reconnaît lui-même trois points faibles. La règle repose sur l’annuaire des noms de domaine, donc une attaque sur cet annuaire la casse. Les cookies, plus anciens, ne se cloisonnent pas de la même manière, de sorte que deux pages réputées séparées peuvent partager une session. Et les droits sont accordés selon l’adresse de la page, pas selon ce qu’elle a besoin de faire, ce qui explique qu’un morceau de code glissé dans une page obtienne tous les droits de celle-ci.
À lire aussi
- CWE-79 : cross-site scripting, la classe au premier rang du Top 25CWE-79, neutralisation incorrecte des entrées lors de la génération d'une page web : ce que la classe recouvre, sa place dans l'arbre CWE, ses sept variantes, et pourquoi elle arrive première du Top 25 2025.
- CWE-352 : falsification de requête inter-sites (CSRF)CWE-352, le CSRF : une faiblesse composée, ce qu'elle exige pour exister, sa place dans l'arbre CWE, pourquoi SameSite a changé la donne sans la supprimer, et son rang 3 au Top 25 2025.
- Cloudbleed 2017 : fuite mémoire d'un proxy TLS mutualiséAnalyse de Cloudbleed (2017), le dépassement de tampon d'un analyseur HTML de proxy de périphérie qui renvoyait la mémoire déchiffrée d'autres clients, et ce qu'il impose à toute architecture de terminaison TLS mutualisée.
- JWE : chiffrer un jeton JSON sans se tromperComment fonctionne JSON Web Encryption, quels algorithmes retenir, quels pièges de production évitent qu'un jeton chiffré ne devienne une fausse garantie.
Pages voisines
La citent
- CWE-352 : falsification de requête inter-sites (CSRF)
- CWE-79 : cross-site scripting, la classe au premier rang du Top 25
- CWE-863 : autorisation incorrecte, le contrôle qui vérifie la mauvaise chose
- Découverte et enregistrement dynamique de client
- DPoP : attacher un jeton d'accès à une clé que le porteur doit prouver détenir
La politique de même origine : ce que le navigateur cloisonne vraiment
Elle cite
- Lien dans les deux sens :La clé de cache HTTP : pourquoi deux requêtes identiques ne le sont pas
- Attributs du cookie de session
- Attaque MIME sniffing par fichier téléversé
- Cross-site scripting (XSS) : mécanisme, variantes et défenses
- Empoisonnement de cache DNS de Kaminsky à SAD DNS et parades
- Sécuriser un canal: TLS, HTTPS et mTLS
- Sécurité par capacités contre ACL
: les deux pages se citent l’une l’autre.